
String
字数: 0 字 时长: 0 分钟
1. String类的源码解读
1.1 String 类的声明
先来看一下 String 类的声明:
public final class String
        implements java.io.Serializable,
                   Comparable<String>,
                   CharSequence {
}从类的声明中,可以看出 String 有几个比较重要的特点。
第一,String 类被 final 修饰。
这意味着 String 类不能被继承,也不能存在它的子类。
final 相关内容会在后面的面向对象笔记中详细介绍。
第二,String 实现了 Serializable 接口。
这意味着 String 对象支持序列化,可以在需要时转换为字节序列进行存储或传输。
序列化相关内容后面会单独介绍。
第三,String 实现了 Comparable<String> 接口。
这意味着 String 定义了字符串之间的自然排序规则,可以通过 compareTo() 方法比较两个字符串的大小关系。
例如:
String str1 = "abc";
String str2 = "abd";

// 按照字符串的字典顺序进行比较
int result = str1.compareTo(str2);

System.out.println(result);需要注意的是,compareTo() 主要用于比较两个字符串的大小关系,而判断两个字符串的内容是否相等,通常应该使用 equals()。
String str1 = new String("kerwim");
String str2 = new String("kerwim");

// 比较两个引用是否指向同一个对象
System.out.println(str1 == str2);

// 比较两个字符串的内容是否相同
System.out.println(str1.equals(str2));输出结果:
false
true因为 == 比较的是两个引用是否指向同一个对象,而 equals() 比较的是字符串中的实际内容。
字符串比较会在后面的字符串比较章节中详细介绍。
以较早版本 JDK 中 String.equals() 的实现为例:
public boolean equals(Object anObject) {

    // 如果两个引用指向同一个对象,直接返回 true
    if (this == anObject) {
        return true;
    }

    // 判断传入对象是否为 String 类型
    if (anObject instanceof String) {

        // 将对象转换为 String
        String anotherString = (String) anObject;

        // 获取当前字符串长度
        int n = value.length;

        // 两个字符串长度相同才继续比较
        if (n == anotherString.value.length) {

            // 获取两个字符串内部保存的字符数组
            char[] v1 = value;
            char[] v2 = anotherString.value;

            int i = 0;

            // 依次比较每一个字符
            while (n-- != 0) {

                // 任意位置字符不同,直接返回 false
                if (v1[i] != v2[i]) {
                    return false;
                }

                i++;
            }

            // 所有字符都相同
            return true;
        }
    }

    return false;
}不同 JDK 版本中
String的内部实现有所不同。JDK 9 之后,String内部已经不再使用char[]保存字符串数据,而是改用了byte[]。这里主要用于理解equals()比较字符串内容的基本思想。
第四,String 实现了 CharSequence 接口。
String、StringBuilder 和 StringBuffer 都实现了 CharSequence 接口,因此它们都可以表示字符序列。
CharSequence
├── String
├── StringBuilder
└── StringBuffer不过它们有一个非常重要的区别:
String         → 不可变字符串

StringBuilder  → 可变字符串
StringBuffer → 可变字符串由于 String 是不可变的,如果需要频繁进行字符串拼接和修改,通常可以考虑使用它的两个“好兄弟”:
StringBuilder 和 StringBuffer。
它们之间的具体区别会在后面的字符串拼接章节中详细介绍。
1.2 String 底层为什么由 char 数组优化为 byte 数组
在 Java 9 以前,String 内部主要使用 char[] 保存字符串内容。
JDK 8 中可以看到类似的定义:
private final char[] value;从 Java 9 开始,String 的底层存储由 char[] 改成了 byte[],并增加了一个 coder 字段,用于标识当前字符串采用哪种内部编码方式。
以 JDK 11 的 String 源码为例:
public final class String
        implements java.io.Serializable,
                   Comparable<String>,
                   CharSequence {

    @Stable
    private final byte[] value;

    private final byte coder;

    private int hash;
}这项优化通常被称为 Compact Strings(紧凑字符串)。
从 char[] 改成 byte[],最主要的目的就是:
减少 String 对象占用的内存空间。
由于 String 在 Java 程序中的使用频率非常高,即使每个字符串只节省一部分内存,放大到整个应用后也可能产生非常明显的效果。
内存占用减少后,还可能进一步减少对象占用的堆空间,从而降低一定的 GC(垃圾回收)压力。
GC 相关内容会在 JVM 部分详细介绍。
Java 9 之前,一个 char 占用 16 bit,也就是 2 个字节。
需要注意:
Java 中的
char表示的是一个 UTF-16 Code Unit(UTF-16 代码单元),并不是使用 UTF-8 编码。
它的取值范围为:
\u0000 ~ \uFFFF也就是:
0 ~ 65535这就意味着,即使字符串中的字符只需要一个字节就可以表示,在以前使用 char[] 存储时,每个 char 仍然需要占用两个字节。
例如:
String name = "jack";j、a、c、k 都属于非常常见的 Latin-1 字符。
在 Java 8 的 char[] 中,仅计算字符数据需要:
4 × 2 Byte = 8 Byte而 Java 9 之后,如果整个字符串都可以使用 Latin-1 表示,那么 byte[] 中只需要:
4 × 1 Byte = 4 Byte这里只计算字符串内部
value保存的字符数据,不包含 String 对象、数组对象头、对齐等额外内存开销。
Latin-1,也称为 ISO-8859-1,是一种单字节字符集。
每个字符只需要一个字节,因此最多可以表示:
2^8 = 256个不同的字符。
其中包括:
- ASCII 中的全部字符
- 英文字母
- 数字
- 常见标点符号
- 一部分西欧语言字符,例如
é、ü、ñ
因此,如果一个字符串中的所有字符都能够使用 Latin-1 表示,就没有必要继续为每个字符使用两个字节。
这就是 Compact Strings 能够节省大量内存的原因。
当然,仅仅把:
char[]改成:
byte[]还不够。
因为 JVM 还必须知道这个 byte[] 中的数据应该按照什么方式解释。
因此,Java 9 的 String 中又增加了一个 coder 字段:
/**
 * The identifier of the encoding used to encode the bytes in value.
 *
 * LATIN1
 * UTF16
 */
private final byte coder;在当前实现中,主要有两种内部表示:
LATIN1
UTF16可以简单理解为:
字符串中的字符都能使用 Latin-1 表示
        ↓
LATIN1
        ↓
每个字符使用 1 个字节保存如果字符串中存在 Latin-1 无法表示的字符:
无法使用 Latin-1 表示
        ↓
UTF16
        ↓
每个 UTF-16 Code Unit 使用 2 个字节保存Java 会根据字符串中的内容自动选择对应的内部表示。
例如:
String name = "jack";可以使用 LATIN1 保存。
仅计算字符数据:
j    1 Byte
a    1 Byte
c    1 Byte
k    1 Byte

总计:4 Byte而对于:
String name = "牛马";牛 和 马 无法使用 Latin-1 表示,因此需要使用 UTF16。
仅计算字符数据:
牛    2 Byte
马    2 Byte

总计:4 Byte所以可以简单概括为:
Java 8 及以前:

英文字符        2 Byte
常见中文字符    2 Byte


Java 9 及以后:

Latin-1 字符    1 Byte
其他字符 使用 UTF-16 形式保存也就是说,这次优化对于包含大量英文、数字、ASCII 字符的字符串效果非常明显。
这里还可以通过 JVM 工具直观地观察 Java 堆中的对象占用情况。
例如可以使用:
jmap -histo:live <pid> | head -n 10查看当前 JVM 中存活对象的数量和占用空间统计。
其中 pid 表示 Java 进程的进程号,可以通过:
ps -ef | grep java或者:
jps -l进行查看。
例如下面这个项目中的 JVM 堆对象统计:
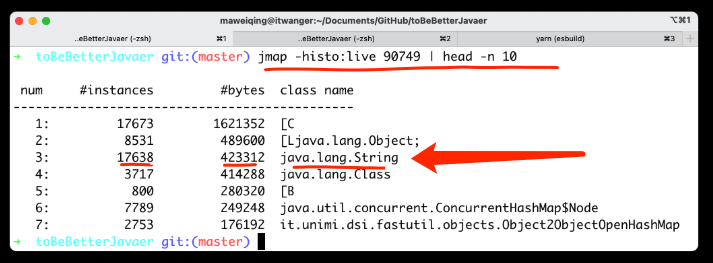
从截图中可以看到:
String 对象:

数量:17638
占用:423312 Byte而在 Java 8 中,String 内部使用的是 char[],因此通常也会看到大量的 char[] 对象。
例如截图中的:
char[] 对象:

数量:17673
占用:1621352 Byte可以看到,字符串本身以及其底层字符数组可能占据相当可观的内存空间。
这也是为什么 JDK 要专门优化 String:
String 使用得实在太频繁了。
如果只是优化一个很少使用的类,即使单个对象节省了一些空间,对整个 JVM 堆的影响可能也很有限。
但是 String 几乎存在于所有 Java 项目中,因此这种底层优化的收益非常可观。
这里还有一个问题:
为什么 String 不直接使用 UTF-8 存储呢?
UTF-8 是一种变长编码。
不同字符可能需要不同数量的字节:
0xxxxxxx

110xxxxx 10xxxxxx

1110xxxx 10xxxxxx 10xxxxxx

11110xxx 10xxxxxx 10xxxxxx 10xxxxxx也就是说,一个 Unicode 字符在 UTF-8 中可能占用:
1 Byte
2 Byte
3 Byte
4 Byte例如 ASCII 范围:
0 ~ 127只需要一个字节。
而其他字符根据 Unicode 编号可能需要多个字节。
如果 String 内部完全使用 UTF-8 保存,那么按照 Java String 的索引语义访问数据时,实现会更加复杂。
例如:
str.charAt(10);Java 的字符串 API 是按照 UTF-16 Code Unit 进行索引的。
如果底层采用 UTF-8 这种变长编码,想找到对应位置的数据,就不能像固定宽度数据那样直接根据索引计算位置,而需要处理前面不同长度的 UTF-8 编码。
这会增加 charAt()、substring() 等字符串操作的复杂度。
可能还会有一个疑问:
UTF-16 不也是变长的吗?
没错。
UTF-16 中:
U+0000 ~ U+FFFF范围内的大部分字符使用一个 16 bit 的代码单元表示,也就是:
2 Byte而 Unicode 中超过 U+FFFF 的字符,则需要使用一对**代理项(Surrogate Pair)**表示:
高位代理:D800 ~ DBFF

低位代理:DC00 ~ DFFF也就是两个 UTF-16 Code Unit,共:
4 Byte但是 Java 的 char 本身就是一个:
16 bit UTF-16 Code Unit因此,对于需要两个 UTF-16 Code Unit 表示的 Unicode 字符,在 Java 中也会表现为两个 char。
例如:
String str = "😀";

System.out.println(str.length());结果为:
2虽然我们视觉上看到的是一个字符,但它在 UTF-16 中由两个代码单元组成,因此 String.length() 返回 2。
同样:
charAt()
substring()
length()这些传统的 String API,本质上都是围绕 UTF-16 Code Unit 进行操作。
因此,从 Java 的字符串 API 语义来看,UTF-16 Code Unit 可以作为固定的 16 bit 单位处理。
所以 Java 9 对 String 的优化思路可以总结为:
Java 8

String
  ↓
char[]
  ↓
每个 char 固定占用 2 Byte


Java 9+

String
  ↓
byte[] + coder
  ↓
┌──────────────┬──────────────┐
│ LATIN1       │ UTF16        │
│ 1 Byte/单位  │ 2 Byte/单位  │
└──────────────┴──────────────┘对于大量只包含英文、数字和常见 Latin-1 字符的字符串,可以直接将底层存储空间缩小接近一半。
而对于中文等无法使用 Latin-1 表示的内容,则继续使用 UTF-16 形式进行保存。
因此,从 char[] 到 byte[] + coder 的改变,本质上就是:
根据字符串实际内容选择更紧凑的内部存储方式,避免所有字符串无论内容如何都固定使用两个字节保存一个 UTF-16 Code Unit。
1.3 hashCode 方法
每一个字符串都可以根据自身内容计算出一个 hashCode。
不同字符串的哈希值可能发生碰撞,因此不能认为 hashCode 一定唯一。不过,一个设计良好的哈希算法会尽可能让不同数据的哈希值均匀分布。
String 非常适合作为 HashMap 的 Key,其中一个重要原因就是 String 是不可变对象。一旦字符串创建完成,其内容不会发生变化,对应的 equals() 和 hashCode() 结果也能够保持稳定。
HashMap以及hashCode()、equals()之间的关系,会在后面的集合笔记中详细介绍。
先来看较早版本 JDK 中 String 类的 hashCode() 实现:
// 缓存字符串计算得到的哈希值
private int hash;

public int hashCode() {

    // 尝试直接获取之前计算过的哈希值
    int h = hash;

    // 如果还没有计算过,并且字符串不为空,则计算 hashCode
    if (h == 0 && value.length > 0) {

        // 获取 String 内部保存字符的数组
        char[] val = value;

        // 遍历字符串中的每一个字符
        for (int i = 0; i < value.length; i++) {

            // 使用 31 作为乘法因子计算哈希值
            h = 31 * h + val[i];
        }

        // 将计算结果缓存起来
        hash = h;
    }

    // 返回最终的哈希值
    return h;
}不同 JDK 版本中
String的底层结构和hashCode()实现细节有所不同,这里主要通过经典实现理解 String 哈希值的计算思想。
hashCode() 会先尝试获取之前已经计算好的哈希值。
如果还没有计算,则遍历字符串中的字符,根据下面的方式不断计算:
h = 31 * h + 当前字符计算完成后,将结果保存到 hash 字段中。后续再次调用 hashCode() 时,可以直接使用已经计算好的结果。
这种需要时才进行计算,并将结果保存起来供后续使用的方式,可以理解为一种惰性计算 + 缓存优化。
String 使用的这种计算方式通常可以称为 31 倍哈希法(31-Hash)。
假设字符串为 s,长度为 n,它最终的计算结果可以展开为:
H(s) =
s[0] × 31^(n-1)
+ s[1] × 31^(n-2)
+ ...
+ s[n-1] × 31^0其中 s[i] 表示对应 char 的数值。
例如:
abc其计算过程可以理解为:
'a' × 31² + 'b' × 31¹ + 'c' × 31⁰实际源码并不会真的进行幂运算,而是通过不断执行:
h = 31 * h + value;得到相同的结果。
31 倍哈希法实现简单、计算速度较快,同时能够让字符串的哈希值获得较好的分布效果,因此被 String.hashCode() 使用。
我们也可以自己模拟实现一次 String 的 hashCode():
public class HashCodeExample {

    public static void main(String[] args) {

        String text = "kerwim";

        // 手动计算字符串的 hashCode
        int hashCode = computeHashCode(text);

        System.out.println(
                "字符串 \"" + text + "\" 的哈希码是: " + hashCode
        );

        // 调用 String 自带的 hashCode() 进行对比
        System.out.println(
                "String 的 hashCode: " + text.hashCode()
        );
    }

    /**
     * 手动实现 31 倍哈希法
     */
    public static int computeHashCode(String text) {

        int h = 0;

        // 遍历字符串中的每一个 char
        for (int i = 0; i < text.length(); i++) {
            h = 31 * h + text.charAt(i);
        }

        return h;
    }
}运行结果:
字符串 "kerwim" 的哈希码是: 867758096
String 的 hashCode: 867758096可以看到,我们手动实现的 31 倍哈希算法,与 String.hashCode() 得到的结果完全一致。
需要注意:
hashCode 相同,并不意味着两个字符串一定相等。
不同字符串仍然有可能计算出相同的 hashCode,这种情况称为哈希冲突(Hash Collision)。
因此,在 HashMap 等哈希结构中,hashCode() 主要用于快速定位数据,而真正判断两个对象是否相等,还需要配合 equals()。
1.4 substring 方法
String 类中还有一个非常常用的方法:substring(),主要用于从字符串中截取指定范围的子串。
先来看较早版本 JDK 中 substring(int beginIndex) 的实现:
public String substring(int beginIndex) {

    // 起始索引不能小于 0
    if (beginIndex < 0) {
        throw new StringIndexOutOfBoundsException(beginIndex);
    }

    // 计算截取后的字符串长度
    int subLen = value.length - beginIndex;

    // beginIndex 不能超过字符串长度
    if (subLen < 0) {
        throw new StringIndexOutOfBoundsException(subLen);
    }

    // 如果从索引 0 开始截取,直接返回当前字符串
    // 否则根据指定范围创建新的 String
    return (beginIndex == 0)
            ? this
            : new String(value, beginIndex, subLen);
}substring() 首先会检查传入索引是否合法,如果索引小于 0 或超过字符串长度,就会抛出 StringIndexOutOfBoundsException。
异常相关内容会在后面的异常处理笔记中详细介绍。
如果 beginIndex 为 0,说明截取后的内容与原字符串完全相同,因此可以直接返回当前字符串:
return this;否则,就会根据指定的起始位置截取字符串中的部分内容,并返回一个新的 String 对象。
上面的源码属于较早版本 JDK 的实现。不同 JDK 版本中
String的底层存储结构以及substring()的具体实现有所不同,这里主要用于理解其基本逻辑。
substring() 常见的两种形式:
substring(beginIndex)表示从 beginIndex 开始,一直截取到字符串末尾。
substring(beginIndex, endIndex)表示截取:
[beginIndex, endIndex)也就是包含起始索引,不包含结束索引。
① 提取字符串中的一段子串
String str = "Hello, world!";

// 从索引 7 开始,截取到索引 12,不包含索引 12
String subStr = str.substring(7, 12);

System.out.println(subStr);输出结果:
world可以理解为:
Hello, world!
0123456789012
       ↑    ↑
7 12substring(7, 12) 会截取索引:
7、8、9、10、11对应的内容就是:
world② 提取字符串中的前缀或后缀
String str = "Hello, world!";

// 截取前 5 个字符
String prefix = str.substring(0, 5);

// 从索引 7 开始,一直截取到字符串末尾
String suffix = str.substring(7);

System.out.println(prefix);
System.out.println(suffix);输出结果:
Hello
world!③ 配合 trim() 和 split() 处理字符串
String str = "   Hello,   world!  ";

// 去除字符串首尾的空格
String trimmed = str.trim();

// 按照一个或多个空白字符进行分割
String[] words = trimmed.split("\\s+");

// 截取第一个单词的首字母
String firstWord = words[0].substring(0, 1);

System.out.println(firstWord);输出结果:
H④ 配合 split() 处理数字和分隔符
String str = "1234-5678-9012-3456";

// 按照 "-" 分割字符串
String[] parts = str.split("-");

// 获取最后一组数据,并从索引 1 开始截取
String last3Digits = parts[3].substring(1);

System.out.println(last3Digits);输出结果:
456总的来说,substring() 的作用非常简单:
根据索引从字符串中截取指定范围的内容。
使用时最需要注意的就是索引范围:
substring(beginIndex, endIndex)

beginIndex 包含
endIndex 不包含1.5 indexOf 方法
indexOf() 方法用于查找某个字符或子字符串在原字符串中第一次出现的位置,并返回对应的索引。
如果没有找到,则返回:
-1先来看较早版本 JDK 中 indexOf() 的核心实现:
/*
 * 在 source 中查找 target 第一次出现的位置。
 *
 * sourceOffset、sourceCount:
 * 指定 source 中参与搜索的范围。
 *
 * targetOffset、targetCount:
 * 指定 target 中参与匹配的范围。
 *
 * fromIndex:
 * 指定从哪个位置开始查找。
 *
 * 找到后返回对应索引,否则返回 -1。
 */
static int indexOf(char[] source, int sourceOffset, int sourceCount,
        char[] target, int targetOffset, int targetCount,
        int fromIndex) {

    // 如果开始位置已经超出 source 的有效范围
    if (fromIndex >= sourceCount) {
        return targetCount == 0 ? sourceCount : -1;
    }

    // 如果开始位置小于 0,则从索引 0 开始查找
    if (fromIndex < 0) {
        fromIndex = 0;
    }

    // 如果目标字符串为空,直接返回开始查找的位置
    if (targetCount == 0) {
        return fromIndex;
    }

    // 获取目标字符串的第一个字符
    char first = target[targetOffset];

    // 计算最后一个可能完成完整匹配的位置
    int max = sourceOffset + (sourceCount - targetCount);

    // 从指定位置开始查找
    for (int i = sourceOffset + fromIndex; i <= max; i++) {

        // 先寻找 target 的第一个字符
        if (source[i] != first) {
            while (++i <= max && source[i] != first);
        }

        // 找到第一个字符后,继续比较后面的字符
        if (i <= max) {

            int j = i + 1;
            int end = j + targetCount - 1;

            for (int k = targetOffset + 1;
                    j < end && source[j] == target[k];
                    j++, k++);

            // target 中的所有字符都匹配成功
            if (j == end) {
                return i - sourceOffset;
            }
        }
    }

    // 没有找到目标字符串
    return -1;
}上面的源码属于较早版本 JDK 中基于
char[]的实现。不同 JDK 版本中String的底层结构以及indexOf()的具体实现有所不同,这里主要用于理解它的查找思路。
它的基本思路可以简单理解为:
先找到目标字符串的第一个字符
        ↓
再继续比较后面的字符
        ↓
全部匹配成功
        ↓
返回第一次出现的索引如果遍历结束后仍然没有找到,则返回 -1。
① 查找子字符串的位置
String str = "Hello, world!";

// 查找 "world" 第一次出现的位置
int index = str.indexOf("world");

System.out.println(index);输出结果:
7② 查找某个字符的位置
String str = "Hello, world!";

// 查找 "," 第一次出现的位置
int index = str.indexOf(",");

System.out.println(index);输出结果:
5③ 从指定位置开始查找
String str = "Hello, world!";

// 从索引 3 开始查找 "l"
int index = str.indexOf("l", 3);

System.out.println(index);输出结果:
3indexOf(str, fromIndex) 表示:
从 fromIndex 指定的位置开始向后查找④ 查找同一个字符的不同位置
String str = "Hello, world!";

// 查找第一个 "o"
int index1 = str.indexOf("o");

// 从索引 5 开始继续查找 "o"
int index2 = str.indexOf("o", 5);

System.out.println(index1);
System.out.println(index2);输出结果:
4
8因此,如果一个字符串中存在多个相同的字符或子字符串,可以通过指定不同的 fromIndex,继续向后查找。
例如判断某个字符串是否存在:
String str = "Hello, world!";

// 返回值 >= 0,说明找到了
if (str.indexOf("world") >= 0) {
    System.out.println("找到了");
}不过如果只是判断字符串中是否包含某段内容,通常还可以直接使用:
str.contains("world");总的来说,indexOf() 最核心的规则就是:
找到    → 返回第一次出现的索引

找不到 → 返回 -11.6 其他方法
除了前面介绍的 substring()、indexOf() 等方法,String 还提供了很多常用的字符串操作方法。
① length():获取字符串长度
length() 用于返回字符串的长度。
String text = "kerwim";

System.out.println(text.length());输出结果:
6② isEmpty():判断字符串是否为空
isEmpty() 用于判断字符串长度是否为 0。
String text = "";

System.out.println(text.isEmpty());输出结果:
true它本质上等价于:
text.length() == 0需要注意,isEmpty() 判断的是空字符串 "",并不能用于判断对象是否为 null。
③ charAt():获取指定索引位置的字符
charAt() 用于返回字符串指定索引位置上的 char。
String text = "kerwim";

// 获取索引 0 位置的字符
char c = text.charAt(0);

System.out.println(c);输出结果:
k字符串的索引同样从 0 开始。
④ valueOf():将其他类型转换为字符串
String.valueOf() 可以将基本数据类型、字符数组、对象等转换为字符串。
例如将整数转换为字符串:
String str = String.valueOf(123);

System.out.println(str);输出结果:
123对于 int 类型,String.valueOf() 内部实际上会调用 Integer.toString():
public static String valueOf(int i) {
    return Integer.toString(i);
}较早版本 JDK 中 Integer.toString(int i) 的实现类似:
public static String toString(int i) {

    // Integer 最小值需要单独处理
    if (i == Integer.MIN_VALUE) {
        return "-2147483648";
    }

    // 计算转换成字符串后需要的长度
    int size = (i < 0)
            ? stringSize(-i) + 1
            : stringSize(i);

    // 创建字符数组
    char[] buf = new char[size];

    // 将整数转换并写入字符数组
    getChars(i, size, buf);

    // 根据字符数组创建 String
    return new String(buf, true);
}其中 getChars() 就是将整数中的数字转换并写入字符数组的具体过程,这里不继续展开。
不同 JDK 版本中
Integer.toString()的具体底层实现会有所变化,这里主要用于理解String.valueOf()最终仍然需要完成“其他类型 → 字符串”的转换过程。
⑤ getBytes():将字符串转换为字节数组
getBytes() 用于将字符串按照指定字符编码转换为 byte[]。
例如使用 UTF-8:
String text = "kerwim";

// 使用 UTF-8 将字符串转换为字节数组
byte[] bytes = text.getBytes(StandardCharsets.UTF_8);

System.out.println(Arrays.toString(bytes));通常建议明确指定字符集:
StandardCharsets.UTF_8避免依赖系统默认编码。
⑥ trim():去除字符串两侧的空白
trim() 用于去除字符串首尾的一部分空白字符。
较早版本 JDK 中的源码如下:
public String trim() {

    int len = value.length;
    int st = 0;
    char[] val = value;

    // 从左向右寻找第一个大于空格字符的位置
    while ((st < len) && (val[st] <= ' ')) {
        st++;
    }

    // 从右向左寻找最后一个大于空格字符的位置
    while ((st < len) && (val[len - 1] <= ' ')) {
        len--;
    }

    // 如果首尾存在需要去除的字符,则截取新的字符串
    return ((st > 0) || (len < value.length))
            ? substring(st, len)
            : this;
}例如:
String text = " kerwim ";

System.out.println(text.trim());输出结果:
kerwim在处理用户输入时经常会用到 trim(),例如:
账号
密码
搜索关键字
表单输入可以先去除用户误输入在字符串首尾的空格。
需要注意,trim() 并不是处理所有 Unicode 空白字符。Java 11 之后如果需要更完整地处理 Unicode 空白字符,还可以使用:
strip()⑦ toCharArray():将字符串转换为字符数组
toCharArray() 用于将字符串转换为 char[]。
String text = "kerwim";

// 将字符串转换为字符数组
char[] chars = text.toCharArray();

System.out.println(Arrays.toString(chars));输出结果:
[k, e, r, w, i, m]除此之外,String 还有很多常用方法,例如:
split()       按照指定规则切割字符串

equals()      比较两个字符串的内容是否相同

contains()    判断是否包含指定内容

startsWith()  判断是否以指定内容开头

endsWith()    判断是否以指定内容结尾

replace()     替换字符串中的内容

toUpperCase() 转换为大写

toLowerCase() 转换为小写

join() 将多个字符串按照指定分隔符连接起来这些方法在实际开发中都会经常使用,可以根据具体场景选择对应的方法。
2. Java 字符串是不可变的
String 是 Java 中使用频率非常高的引用类型,而 不可变性(Immutable) 是 String 最重要的特性之一。
所谓不可变,就是:
一个 String 对象创建之后,它所表示的字符串内容就不能再发生改变。
例如:
String text = "kerwim";

// 看起来修改了字符串
text = text + "666";实际上原来的 "kerwim" 并没有被修改,而是生成了新的字符串对象,然后让 text 指向新的对象。
2.1 String 如何保证不可变
以 JDK 8 中的 String 源码为例:
public final class String
        implements java.io.Serializable,
                   Comparable<String>,
                   CharSequence {

    // 用于保存字符串中的字符
    private final char[] value;
}可以看到两个比较重要的地方。
第一,String 类被 final 修饰。
public final class String这意味着 String 不能被继承,也就不存在子类通过重写相关方法来改变 String 的行为。
final 相关内容会在面向对象部分详细介绍。
第二,String 内部用于保存数据的数组由 final 修饰。
private final char[] value;value 引用一旦初始化之后,就不能再指向其他数组。
同时,String 本身并没有向外提供直接修改内部数组的方法,因此字符串内容对外表现为不可变。
JDK 9 之后,
String的底层由char[]改成了byte[],但 String 的不可变性并没有改变。
2.2 为什么 String 要设计成不可变
String 设计成不可变对象并不是偶然的,它会带来很多好处。
1. 对象更加安全、稳定
一个字符串对象创建之后,其内容不会被其他代码意外修改,因此在多个地方共享同一个 String 对象时更加安全。
例如:
String username = "kerwim";

// username2 和 username 指向同一个 String 对象
String username2 = username;

// 这里只是让 username2 指向新的 String
username2 = "kevin";

System.out.println(username);
System.out.println(username2);输出结果:
kerwim
kevinusername2 的重新赋值并不会修改原来的 "kerwim" 对象。
这使得 String 在方法参数传递、对象共享等场景下不容易因为某一处代码的修改而影响其他地方。
不可变性能够避免字符串内容被意外修改,但密码等敏感数据并不会因为使用 String 就天然更加安全。在一些安全要求较高的场景中,也会使用
char[]等结构保存敏感信息,以便使用后主动清除。
2.3 保证 hashCode 稳定
String 经常会作为 HashMap 等哈希结构的 Key。
例如:
Map<String, String> map = new HashMap<>();

map.put("username", "kerwim");如果 String 是可变的,那么一个字符串作为 Key 放入 HashMap 之后,如果内容发生变化,其 hashCode 也可能随之改变。
这样就可能出现:
放进去的时候使用一个 hashCode

修改字符串

取出来的时候变成另外一个 hashCode这会破坏哈希表的查找逻辑。
而 String 是不可变的,因此一个 String 对象的内容不会发生变化,对应的 hashCode 也能够保持稳定。
String 还会对计算得到的哈希值进行缓存。
例如:
String text1 = "kerwim";
String text2 = "kerwim";

// 第一次调用时计算 hashCode
int hashCode1 = text1.hashCode();

System.out.println("第一次计算 text1 的哈希值:" + hashCode1);

// 再次调用时可以使用已经计算过的结果
int hashCode1Cached = text1.hashCode();

System.out.println("第二次计算:" + hashCode1Cached);

// 字符串字面量来自字符串常量池
// text1 和 text2 通常指向同一个 String 对象
int hashCode2 = text2.hashCode();

System.out.println("text2 的 hashCode:" + hashCode2);由于 String 对象不可变,其哈希值计算之后不会因为字符串内容发生变化而失效。
因此可以进行这种:
第一次使用
    ↓
计算 hashCode
    ↓
缓存结果
    ↓
后续直接使用的优化。
这对于 HashMap、HashSet 等大量依赖 hashCode() 的数据结构来说非常重要。
2.4 可以实现字符串常量池
String 的不可变性还是字符串常量池能够安全存在的重要基础。
例如:
String str1 = "kerwim";
String str2 = "kerwim";由于字符串常量池的存在:
System.out.println(str1 == str2);通常得到:
true可以简单理解为:
str1 ──┐
       ├──> "kerwim"
str2 ──┘两个变量可以安全地共享同一个 String 对象。
这是因为 String 不可变。
如果 String 可以随意修改,那么:
str1 修改 "kerwim"就可能同时影响:
str2这样字符串常量池也就很难安全地共享字符串对象了。
因此,String 的不可变性可以让相同内容的字符串安全复用,从而减少重复对象,在一定程度上节省内存空间。
2.5 字符串操作不会修改原对象
由于 String 是不可变的,因此很多看起来像是在“修改字符串”的方法,实际上都不会直接修改原来的 String 对象。
常见的包括:
substring()    截取字符串

concat()       拼接字符串

replace()      替换字符串

toUpperCase()  转换为大写

toLowerCase() 转换为小写它们通常会返回一个新的 String 对象,或者在结果没有发生变化时直接返回原对象。
substring()
以前面介绍过的较早版本源码为例:
public String substring(int beginIndex) {

    if (beginIndex < 0) {
        throw new StringIndexOutOfBoundsException(beginIndex);
    }

    int subLen = value.length - beginIndex;

    if (subLen < 0) {
        throw new StringIndexOutOfBoundsException(subLen);
    }

    // 如果从 0 开始截取,直接返回当前对象
    // 否则创建新的 String
    return (beginIndex == 0)
            ? this
            : new String(value, beginIndex, subLen);
}如果:
beginIndex == 0截取后的内容与原字符串完全相同,因此直接:
return this;否则就会创建新的 String 对象。
例如:
String text = "Hello Java";

// 截取后得到新的字符串
String result = text.substring(6);

System.out.println(text);
System.out.println(result);输出:
Hello Java
Java可以看到,原来的 text 并没有被改变。
concat()
concat() 用于拼接字符串。
JDK 中的实现大致如下:
public String concat(String str) {

    int olen = str.length();

    // 如果需要拼接的是空字符串
    // 内容没有发生变化,直接返回当前对象
    if (olen == 0) {
        return this;
    }

    if (coder() == str.coder()) {

        byte[] val = this.value;
        byte[] oval = str.value;

        int len = val.length + oval.length;

        byte[] buf = Arrays.copyOf(val, len);

        System.arraycopy(
                oval,
                0,
                buf,
                val.length,
                oval.length
        );

        // 创建新的 String
        return new String(buf, coder);
    }

    int len = length();

    byte[] buf = StringUTF16.newBytesFor(len + olen);

    getBytes(buf, 0, UTF16);
    str.getBytes(buf, len, UTF16);

    // 创建新的 String
    return new String(buf, UTF16);
}如果拼接的是空字符串:
text.concat("");字符串内容没有发生变化,因此可以直接:
return this;如果确实需要进行字符串拼接,则会创建新的字符串对象。
例如:
String text = "Hello";

// concat() 不会修改原来的 String
String result = text.concat(" Java");

System.out.println(text);
System.out.println(result);输出:
Hello
Hello Javareplace()
replace() 也是一样的道理。
例如:
String text = "Hello Java";

// 替换后得到新的 String
String result = text.replace("Java", "World");

System.out.println(text);
System.out.println(result);输出:
Hello Java
Hello World原来的:
Hello Java并没有发生变化。
因此,对于 String 来说:
截取
拼接
替换
大小写转换
……这些操作本质上都不会直接修改原来的字符串内容。
可以简单理解为:
原 String
    ↓
执行字符串操作
    ↓
原 String 保持不变
    ↓
返回新的 String
或在内容没有变化时直接返回原对象这就是 Java String 不可变性最直观的体现。
3. 理解Java字符串常量池
3.1 先从这道面试题开始吧
先来看一道非常经典的 String 面试题:
String s = new String("kerwim");这行代码创建了几个对象?
常见回答是:
两个。
不过更准确地说,应该分情况讨论。
如果字符串常量池中还不存在 "kerwim",那么会涉及两个 String 对象:
"kerwim"
    ↓
先在字符串常量池中创建一个 String 对象

new String("kerwim")
    ↓
再创建一个新的 String 对象最终变量 s 指向的是 new String() 创建出来的那个对象。
如果字符串常量池中已经存在 "kerwim",那么就不会重复创建常量池中的字符串对象,只会通过:
new String("kerwim");再创建一个新的 String 对象。
也就是说:
常量池中不存在 "kerwim" → 最多创建两个 String 对象

常量池中已经存在 "kerwim" → 只创建一个新的 String 对象用下面这张图理解会更加直观:
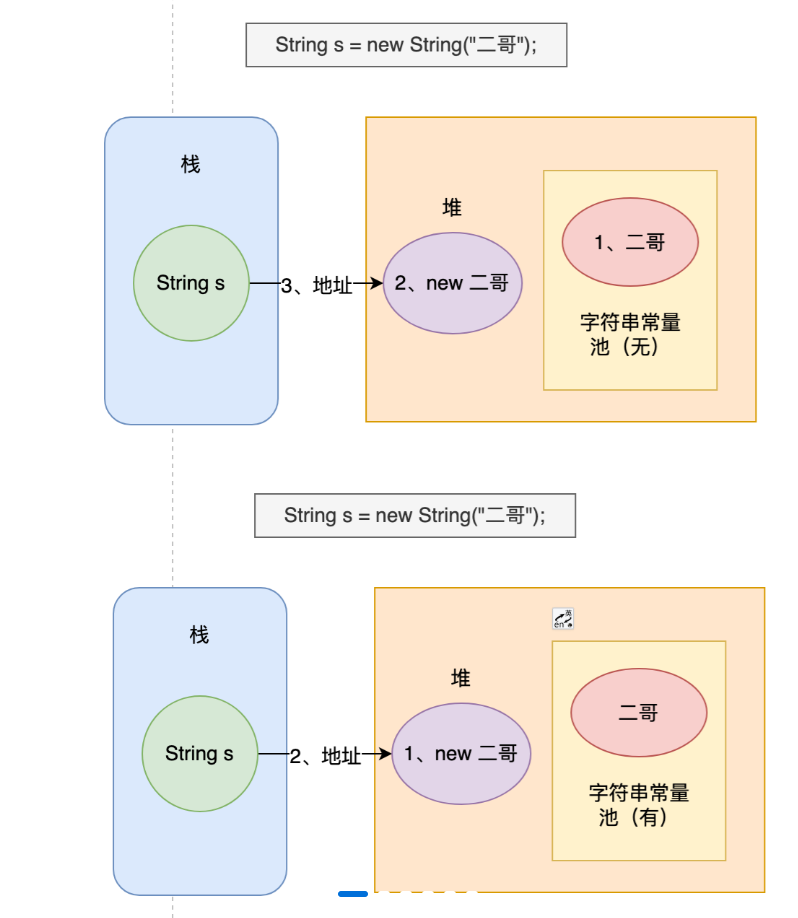
图中使用的是:
String s = new String("二哥");和:
String s = new String("kerwim");原理是一样的。
可以简单理解为:
字符串常量池
┌──────────────────┐
│     "kerwim"      │
└──────────────────┘
          ↑
          │
          │ 作为 new String() 的内容来源
          ↓
      new String()
          ↓
┌──────────────────┐
│     "kerwim"      │
└──────────────────┘
          ↑
          │
s在这个例子中,s 是一个引用变量,它指向 new String() 创建出来的 String 对象。
需要注意的是,在现代 JVM 中,字符串常量池中的 String 对象本身也位于堆中,因此不能简单理解为“常量池对象不在堆里”。
这里真正需要区分的是:
字符串常量池中的 String 对象
        ↓
可以被相同字符串字面量复用

new String() 创建的 String 对象
        ↓
每次执行 new 都会创建新的对象例如:
String s1 = "kerwim";
String s2 = new String("kerwim");

// 比较两个引用是否指向同一个对象
System.out.println(s1 == s2);输出结果:
false因为:
s1 → 指向字符串常量池中的 "kerwim"

s2 → 指向 new 创建出来的新 String 对象虽然两个字符串内容相同,但它们并不是同一个对象。
如果比较字符串内容:
System.out.println(s1.equals(s2));输出结果:
true那为什么 Java 还要专门设计字符串常量池?
原因很简单:
String 的使用频率实在太高了。
如果每出现一次相同的字符串字面量都创建一个新的 String 对象,就会产生大量内容完全相同的对象,造成不必要的内存浪费。
例如:
String s1 = "kerwim";
String s2 = "kerwim";
String s3 = "kerwim";通过字符串常量池,这几个变量可以复用同一个 String 对象:
s1 ──┐
     │
s2 ──┼──> "kerwim"
     │
s3 ──┘这样就可以:
复用相同字符串
        ↓
减少重复对象
        ↓
节省内存空间
        ↓
提高字符串使用效率这也是 Java 为 String 专门设计字符串常量池的重要原因。
3.2 字符串常量池的作用
通常情况下,我们更推荐直接使用双引号创建字符串对象,而不是通过 new 的方式创建:
String s = "三妹";当执行这行代码时,JVM 会先在字符串常量池中查找是否已经存在内容为 "三妹" 的字符串。
如果已经存在:
字符串常量池中已经存在 "三妹"
        ↓
直接复用这个 String 对象
        ↓
将对象引用赋值给变量 s此时不会再创建新的 String 对象。
如果不存在:
字符串常量池中不存在 "三妹"
        ↓
创建 "三妹" 对应的 String 对象
        ↓
加入字符串常量池
        ↓
将对象引用赋值给变量 s用下面这张图理解会更加直观:
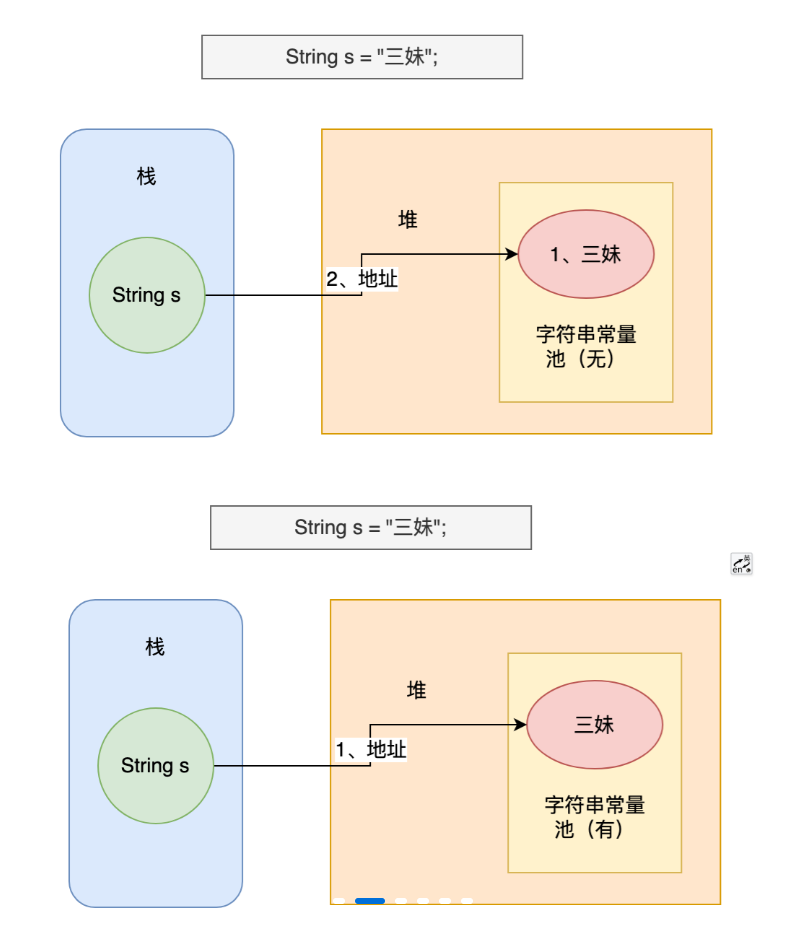
例如:
String s1 = "三妹";
String s2 = "三妹";

// 两个变量复用了字符串常量池中的同一个对象
System.out.println(s1 == s2);输出结果:
true可以简单理解为:
s1 ──┐
     │
     ├──> "三妹"
     │
s2 ──┘字符串常量池最大的作用之一,就是让内容相同的字符串字面量可以直接复用,减少重复 String 对象带来的内存开销。
而下面这种写法:
String s = new String("三妹");只要执行到 new String(),就会创建一个新的 String 对象。
因此,两种创建方式最重要的区别可以简单总结为:
String s = "三妹";

→ 优先复用字符串常量池中的对象


String s = new String("三妹");

→ 每次执行 new 都会创建新的 String 对象也就是说:
new 的方式始终会创建新的 String 对象,而双引号创建字符串时,会优先复用字符串常量池中已经存在的对象。
这也是日常开发中创建普通字符串时,通常直接使用:
String s = "三妹";而不是:
String s = new String("三妹");的原因之一。
3.3 字符串常量池在内存中的什么位置
字符串常量池在不同 JDK 版本中的位置发生过变化,大致可以分为三个阶段。
Java 7 之前
在 Java 7 之前,HotSpot JVM 的字符串常量池位于永久代(PermGen)中。
永久代主要用于保存类的元数据、运行时常量池等与类加载相关的信息。它和普通 Java 堆中的对象实例使用不同的内存区域进行管理。
因此可以简单理解为:
Java 7 之前

JVM 内存
├── Java 堆
│   └── 普通对象、数组等
│
└── 永久代 PermGen
    ├── 类相关信息
    ├── 运行时常量池
└── 字符串常量池例如:
String s = "kerwim";字符串字面量 "kerwim" 对应的 String 对象会进入字符串常量池。
而:
String s = new String("kerwim");除了使用常量池中的 "kerwim" 之外,new String() 还会另外创建一个新的 String 对象。
用下面这张图理解会更加直观:
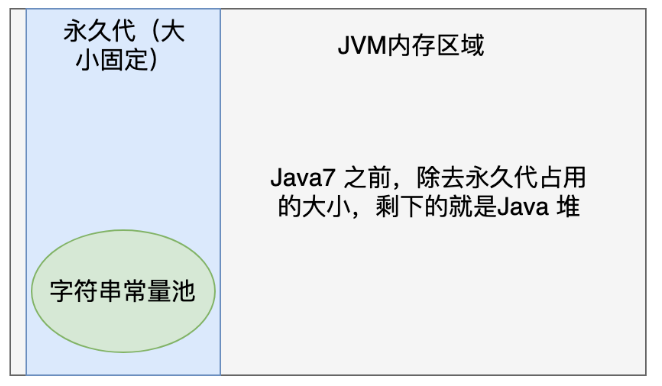
Java 7
永久代的空间通常比较有限,如果加载大量类、常量等数据,就可能造成永久代空间不足,最终出现:
java.lang.OutOfMemoryError: PermGen space从 Java 7 开始,字符串常量池被从永久代移动到了 Java 堆中。
因此:
Java 7

Java 堆
├── 普通对象
├── 数组
└── 字符串常量池

永久代 PermGen
└── 类相关的元数据等字符串常量池进入堆之后,可以和普通对象一样由垃圾收集器进行管理,也减少了永久代的内存压力。
再结合下面这张图来看:
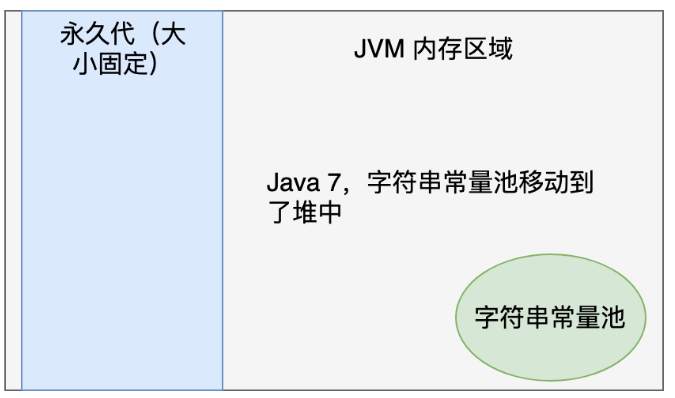
Java 8
到了 Java 8,HotSpot JVM 中的永久代被彻底移除,取而代之的是:
Metaspace(元空间)元空间主要用于保存类的元数据,并且使用的是本地内存(Native Memory),不再占用永久代空间。
需要特别注意:
Java 8 中字符串常量池仍然位于 Java 堆中,并没有随着永久代一起移动到元空间。
因此可以简单理解为:
Java 8+

Java 堆
├── 普通对象
├── 数组
└── 字符串常量池


本地内存 Native Memory
└── Metaspace
└── 类的元数据等相比永久代,元空间最大的变化就是不再使用固定的永久代空间,而是使用本地内存,并可以根据需要动态扩展。
不过元空间也并不是无限的。
如果类加载数量过多,或者设置了:
-XX:MaxMetaspaceSize并超过限制,同样可能出现:
java.lang.OutOfMemoryError: Metaspace所以不能简单认为元空间不会发生 OutOfMemoryError。
再看下面这张图,对比三个阶段会更加直观:
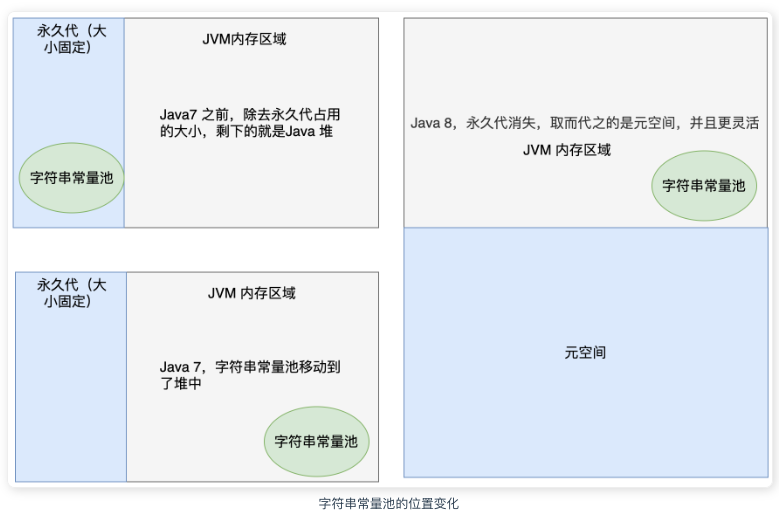
最终可以简单记成:
Java 6 及以前:

字符串常量池
    ↓
PermGen


Java 7:

字符串常量池
    ↓
Java Heap


Java 8+:

字符串常量池
    ↓
Java Heap

PermGen 被移除
    ↓
Metaspace
    ↓
使用本地内存最关键的一点就是:
Java 7 开始,字符串常量池进入堆中;Java 8 移除永久代并引入元空间,但字符串常量池仍然留在堆中。
3.4 永久代、方法区、元空间
这三个概念比较容易混在一起,可以先记住它们之间的关系:
方法区
  ↓
JVM 规范中的逻辑概念

永久代 PermGen
  ↓
HotSpot 对方法区的一种实现

元空间 Metaspace
  ↓
Java 8 之后 HotSpot 对方法区的另一种实现方法区是《Java 虚拟机规范》中定义的一块逻辑内存区域,可以把它理解成一个“规范”或者“接口”,规定了这里主要用于存放类相关的信息。
而**永久代(PermGen)**是早期 HotSpot JVM 对方法区的一种具体实现。
可以简单理解为:
方法区      → 规范

永久代 → 一种具体实现到了 Java 8,HotSpot JVM 移除了永久代,改用**元空间(Metaspace)**来实现方法区。
因此:
Java 7 及以前:

方法区
  ↓
PermGen


Java 8 及以后:

方法区
  ↓
Metaspace永久代和元空间最大的区别之一,就是它们使用的内存位置不同。
永久代使用的是 JVM 管理的内存空间,其容量通常需要通过 JVM 参数进行限制。
如果永久代空间不足,就可能出现:
java.lang.OutOfMemoryError: PermGen space这也是 Java 8 之前比较常见的一类内存异常。
而 Java 8 之后的元空间主要使用的是本地内存(Native Memory),不再使用原来的永久代空间。
因此元空间在默认情况下可以根据需要动态扩展,最大大小主要受到本机可用内存的限制。
不过元空间也不是无限的,如果设置了:
-XX:MaxMetaspaceSize并且实际使用超过了这个限制,或者本机内存不足,同样可能出现:
java.lang.OutOfMemoryError: Metaspace所以可以简单总结为:
方法区:
JVM 规范中的逻辑概念

永久代:
Java 8 之前 HotSpot 对方法区的实现

元空间:
Java 8 之后 HotSpot 对方法区的实现其中最值得记住的一点是:
Java 8 移除了永久代,改用元空间;元空间主要使用本地内存,因此比永久代更加灵活。
3.4 永久代、方法区、元空间
这三个概念比较容易混在一起,可以先记住它们之间的关系:
方法区
  ↓
JVM 规范中的逻辑概念

永久代 PermGen
  ↓
HotSpot 对方法区的一种实现

元空间 Metaspace
  ↓
Java 8 之后 HotSpot 对方法区的另一种实现方法区是《Java 虚拟机规范》中定义的一块逻辑内存区域,可以把它理解成一个“规范”或者“接口”,规定了这里主要用于存放类相关的信息。
而**永久代(PermGen)**是早期 HotSpot JVM 对方法区的一种具体实现。
可以简单理解为:
方法区      → 规范

永久代 → 一种具体实现到了 Java 8,HotSpot JVM 移除了永久代,改用**元空间(Metaspace)**来实现方法区。
因此:
Java 7 及以前:

方法区
  ↓
PermGen


Java 8 及以后:

方法区
  ↓
Metaspace永久代和元空间最大的区别之一,就是它们使用的内存位置不同。
永久代使用的是 JVM 管理的内存空间,其容量通常需要通过 JVM 参数进行限制。
如果永久代空间不足,就可能出现:
java.lang.OutOfMemoryError: PermGen space这也是 Java 8 之前比较常见的一类内存异常。
而 Java 8 之后的元空间主要使用的是本地内存(Native Memory),不再使用原来的永久代空间。
因此元空间在默认情况下可以根据需要动态扩展,最大大小主要受到本机可用内存的限制。
不过元空间也不是无限的,如果设置了:
-XX:MaxMetaspaceSize并且实际使用超过了这个限制,或者本机内存不足,同样可能出现:
java.lang.OutOfMemoryError: Metaspace所以可以简单总结为:
方法区:
JVM 规范中的逻辑概念

永久代:
Java 8 之前 HotSpot 对方法区的实现

元空间:
Java 8 之后 HotSpot 对方法区的实现其中最值得记住的一点是:
Java 8 移除了永久代,改用元空间;元空间主要使用本地内存,因此比永久代更加灵活。
4. StringBuilder和StringBuffer
4.1 StringBuffer 和 StringBuilder 的区别
由于 String 是不可变的,每次对字符串进行修改,都可能产生新的 String 对象。
因此,当程序需要进行大量字符串拼接,尤其是在循环中频繁拼接字符串时,如果不断创建新的 String 对象,就会带来额外的内存开销。
为了解决频繁修改字符串的问题,Java 提供了 StringBuffer 和 StringBuilder。
先来看 StringBuffer:
public final class StringBuffer
        extends AbstractStringBuilder
        implements Serializable, CharSequence {

    public StringBuffer() {
        super(16);
    }

    public synchronized StringBuffer append(String str) {
        super.append(str);
        return this;
    }

    public synchronized String toString() {
        return new String(value, 0, count);
    }

    // 其他方法
}可以看到,StringBuffer 的很多字符串操作方法都使用了:
synchronized进行同步。
例如:
public synchronized StringBuffer append(String str)因此,StringBuffer 在多个线程同时操作同一个对象时,可以提供一定的线程安全保证。
但同步操作需要加锁和释放锁,也会带来额外的性能开销。
如果字符串对象只在单线程环境中使用,这些同步操作通常就是没有必要的。
于是 Java 又提供了 StringBuilder:
public final class StringBuilder
        extends AbstractStringBuilder
        implements java.io.Serializable, CharSequence {

    // ...

    public StringBuilder append(String str) {
        super.append(str);
        return this;
    }

    public String toString() {
        return new String(value, 0, count);
    }

    // ...
}可以看到,StringBuilder 和 StringBuffer 的整体结构非常相似,它们都继承自:
AbstractStringBuilder最大的区别就是:
StringBuffer
    ↓
方法通常带 synchronized
    ↓
线程安全
    ↓
性能相对低一些


StringBuilder
    ↓
没有 synchronized
    ↓
线程不安全
    ↓
性能通常更高因此,在实际开发中:
| 类 | 线程安全 | 性能 | 常见使用场景 |
|---|---|---|---|
StringBuffer | 是 | 相对较低 | 多线程共享并修改同一个字符串对象 |
StringBuilder | 否 | 相对较高 | 单线程下频繁进行字符串拼接和修改 |
现在实际开发中,StringBuilder 的使用频率通常要高于 StringBuffer。
例如:
StringBuilder builder = new StringBuilder();

builder.append("Hello");
builder.append(" ");
builder.append("Java");

System.out.println(builder);输出结果:
Hello Java如果字符串操作本身只发生在当前线程内部,即使程序整体是多线程程序,也依然可以正常使用 StringBuilder。
只有多个线程确实需要共享并同时修改同一个字符串对象时,才需要考虑线程安全问题。
所以通常可以简单记成:
单线程优先使用 StringBuilder,多线程共享修改时再考虑 StringBuffer 或其他同步方案。
4.2 StringBuilder 的使用
在 Java 中,使用 + 进行字符串拼接非常方便。
例如:
String result = "kerwim" + "牛马";如果是在运行期间进行字符串拼接,编译器和 JVM 会对这类代码进行优化。
在较早版本的 Java 中,这类拼接通常可以理解为使用 StringBuilder 完成:
new StringBuilder()
        .append("kerwim")
        .append("牛马")
.toString();也就是说,我们平时写:
String name = "kerwim";
String job = "牛马";

String result = name + job;底层可以理解为类似:
String result = new StringBuilder()
        .append(name)
        .append(job)
.toString();这个转换过程通常不需要程序员手动完成,编译器和 JVM 会对字符串拼接进行相应的优化。
Java 9 之后,字符串拼接的底层实现进行了进一步优化,通常会通过
invokedynamic和StringConcatFactory完成,不再简单地直接转换成StringBuilder。不过从理解字符串拼接原理的角度,可以先把它理解成“避免不断创建中间 String 对象”。
对于简单的字符串拼接,直接使用 + 即可:
String result = "Hello" + " " + "Java";写法更加直观,也更加方便。
但是,如果是在循环中进行大量字符串拼接,就更适合显式使用 StringBuilder。
例如:
StringBuilder builder = new StringBuilder();

for (int i = 0; i < 10; i++) {

    // 在同一个 StringBuilder 对象上不断追加内容
    builder.append(i);
}

String result = builder.toString();

System.out.println(result);相比下面这种写法:
String result = "";

for (int i = 0; i < 10; i++) {

    // String 不可变,每次拼接都可能产生新的字符串对象
    result = result + i;
}使用 StringBuilder 可以减少字符串拼接过程中产生的大量临时对象。
因此可以简单记住:
少量、简单字符串拼接
        ↓
直接使用 +

大量、循环中的字符串拼接
        ↓
优先使用 StringBuilder+ 写起来更加方便,而 StringBuilder 更适合需要频繁修改和拼接字符串的场景。
4.3 StringBuilder 的内部实现
StringBuilder 之所以适合频繁进行字符串拼接,核心原因在于:
它内部使用一个可扩容的数组保存字符,调用
append()时会直接向这个数组中追加内容,而不是每次都创建新的 String 对象。
下面以较早版本 JDK 中基于 char[] 的实现为例,看看 StringBuilder 的内部原理。
JDK 9 之后
AbstractStringBuilder的内部存储已经由char[]调整为byte[],这里主要通过经典的 JDK 8 源码理解其扩容和追加机制。
4.3.1 内部数组与初始容量
先来看 StringBuilder 内部用于保存字符的数据结构:
/**
 * The value is used for character storage.
 */
char[] value;value 是一个 char[],用于保存 StringBuilder 中的字符内容。
同时还有一个 count 字段:
int count;用于记录当前已经存储了多少个字符。
默认创建 StringBuilder 时,内部数组的初始容量为 16:
/**
 * Constructs a string builder with no characters in it and an
 * initial capacity of 16 characters.
 */
public StringBuilder() {
    super(16);
}也就是说:
StringBuilder builder = new StringBuilder();创建完成后,可以简单理解为:
value.length = 16
count = 0这里需要区分两个概念:
count        → 当前实际保存的字符数量

value.length → 当前内部数组的容量随着不断调用 append(),count 会逐渐增加。
当内部数组容量不够时,StringBuilder 会自动进行扩容,这一点和 ArrayList 的动态扩容思想比较类似。
4.3.2 append() 的实现
再来看 StringBuilder 的 append() 方法:
public StringBuilder append(String str) {
    super.append(str);
    return this;
}真正的追加逻辑位于父类 AbstractStringBuilder 中:
public AbstractStringBuilder append(String str) {

    // 如果传入 null,则追加字符串 "null"
    if (str == null) {
        return appendNull();
    }

    // 获取需要追加的字符串长度
    int len = str.length();

    // 检查当前容量是否足够
    ensureCapacityInternal(count + len);

    // 将字符串中的字符复制到内部 value 数组
    str.getChars(0, len, value, count);

    // 更新当前已经使用的字符数量
    count += len;

    return this;
}整个过程可以简单理解为:
append("kerwim")
        ↓
获取字符串长度
        ↓
检查内部数组容量
        ↓
容量不足则扩容
        ↓
将字符复制到 value 数组
        ↓
更新 count例如:
StringBuilder builder = new StringBuilder();

builder.append("kerwim");
builder.append("牛马");并不是每次都创建一个新的 StringBuilder,而是在同一个对象内部不断向 value 数组追加数据。
这也是 StringBuilder 适合频繁字符串拼接的重要原因。
4.3.3 StringBuilder 的扩容机制
在 append() 中,会通过:
ensureCapacityInternal(count + len);检查当前内部数组是否有足够的空间。
源码如下:
private void ensureCapacityInternal(int minimumCapacity) {

    // 当前容量不足,需要扩容
    if (minimumCapacity - value.length > 0) {
        expandCapacity(minimumCapacity);
    }
}其中:
minimumCapacity表示本次追加完成后至少需要的容量。
如果:
minimumCapacity <= value.length说明当前数组容量足够,不需要扩容。
如果:
minimumCapacity > value.length则会调用:
expandCapacity(minimumCapacity);进行扩容。
继续来看扩容源码:
void expandCapacity(int minimumCapacity) {

    // 默认扩容为:旧容量 × 2 + 2
    int newCapacity = value.length * 2 + 2;

    // 如果扩容后的容量仍然不够
    // 直接使用实际需要的最小容量
    if (newCapacity - minimumCapacity < 0) {
        newCapacity = minimumCapacity;
    }

    // 处理容量溢出的情况
    if (newCapacity < 0) {

        if (minimumCapacity < 0) {
            throw new OutOfMemoryError();
        }

        newCapacity = Integer.MAX_VALUE;
    }

    // 创建新的数组并复制原来的数据
    value = Arrays.copyOf(value, newCapacity);
}默认的扩容公式为:
新容量 = 旧容量 × 2 + 2例如默认容量为 16:
16 × 2 + 2 = 34第一次扩容后容量通常变为:
34下一次如果仍然需要扩容:
34 × 2 + 2 = 70因此容量变化大致为:
16 → 34 → 70 → 142 → ...不过,如果按照这个公式计算出来的新容量仍然装不下本次需要追加的数据,就不会继续按照这个结果扩容,而是直接采用:
minimumCapacity例如:
当前容量:16

本次实际需要容量:100按照默认公式:
16 × 2 + 2 = 34显然 34 仍然不够,因此最终容量会直接调整为:
100最后通过:
Arrays.copyOf(value, newCapacity);创建一个更大的数组,并把原数组中的内容复制过去。
所以 StringBuilder 的扩容过程可以理解为:
append()
   ↓
计算本次需要的最小容量
   ↓
当前容量够不够?
   ↓
┌─────────────┬─────────────┐
│     够      │    不够     │
│             │             │
│ 直接追加    │ 执行扩容    │
│             │             │
│             │ 旧容量×2+2  │
│             │     ↓       │
│             │ 仍然不够?  │
│             │     ↓       │
│             │ minimumCapacity
└─────────────┴─────────────┘4.3.4 toString() 的实现
最后再来看 StringBuilder 的 toString():
public String toString() {
    return new String(value, 0, count);
}其中:
value → 保存字符内容的内部数组

count → 当前实际使用的字符数量调用:
builder.toString();时,会根据 value 数组中从索引 0 开始的前 count 个字符,创建一个新的 String 对象并返回。
例如:
StringBuilder builder = new StringBuilder();

builder.append("kerwim");
builder.append("牛马");

// 将 StringBuilder 转换为 String
String result = builder.toString();

System.out.println(result);输出结果:
kerwim牛马因此,整个 StringBuilder 的核心工作过程可以简单概括为:
创建 StringBuilder
        ↓
创建内部数组
默认容量 16
        ↓
append()
        ↓
直接向内部数组追加字符
        ↓
容量不足时自动扩容
        ↓
继续追加
        ↓
toString()
        ↓
最终创建 String 对象也就是说,StringBuilder 并不是让 String 本身变成了可变对象,而是:
先在一个可扩容的内部数组中不断修改和追加数据,最后需要 String 时,再通过
toString()创建最终的 String 对象。
4.4 StringBuilder 的 reverse 方法
StringBuilder 还提供了一个 reverse() 方法,用于将当前字符序列进行反转。
例如:
StringBuilder builder = new StringBuilder("kerwim");

// 反转当前字符序列
builder.reverse();

System.out.println(builder);输出结果:
miwrek先来看 StringBuilder 中的 reverse() 方法:
public StringBuilder reverse() {

    // 调用父类 AbstractStringBuilder 的 reverse()
    super.reverse();

    return this;
}真正的反转逻辑位于父类 AbstractStringBuilder 中。
下面省略一些非核心代码,只保留主要逻辑:
public AbstractStringBuilder reverse() {

    // 最后一个字符的索引
    int n = count - 1;

    // 只遍历字符序列的前半部分
    for (int j = (n - 1) >> 1; j >= 0; j--) {

        // 计算与 j 对称位置的索引
        int k = n - j;

        // 获取两个对称位置上的字符
        char cj = value[j];
        char ck = value[k];

        // 交换两个字符的位置
        value[j] = ck;
        value[k] = cj;
    }

    // 返回当前对象
    return this;
}它的核心思想其实很简单:
原字符串:

k e r w i m
0 1 2 3 4 5

交换:

0 ↔ 5
1 ↔ 4
2 ↔ 3

结果:

m i w r e k整个反转过程只需要遍历字符序列的前半部分,然后将当前位置和对应的对称位置进行交换。
其中:
int k = n - j;用于计算当前索引 j 对应的对称位置。
而:
(n - 1) >> 1使用了右移运算,可以理解为:
(n - 1) / 2也就是确定需要进行交换的前半部分范围。
之所以只需要遍历一半,是因为每次循环都会同时交换前后两个字符。
例如:
abcdef只需要执行:
a ↔ f
b ↔ e
c ↔ d不需要再从后向前重复交换。
因此,reverse() 的核心过程可以概括为:
找到前后两个对称位置
        ↓
交换字符
        ↓
继续向中间移动
        ↓
完成整个字符序列的反转而且 reverse() 返回的是当前 StringBuilder 对象本身,因此还可以继续进行链式调用:
String result = new StringBuilder("kerwim")
        .reverse()
        .append("-Java")
        .toString();

System.out.println(result);输出结果:
miwrek-Java4.5 StringBuilder 的 reverse 方法
StringBuilder 还提供了一个 reverse() 方法,用于反转当前字符序列。
例如:
StringBuilder builder = new StringBuilder("kerwim");

// 反转字符序列
builder.reverse();

System.out.println(builder);输出结果:
miwrek先来看 StringBuilder 中的 reverse() 方法:
public StringBuilder reverse() {
    super.reverse();
    return this;
}可以看到,真正的反转逻辑实际上位于父类 AbstractStringBuilder 中。
下面省略部分非核心代码,只保留主要实现逻辑:
public AbstractStringBuilder reverse() {

    // 字符序列最后一个字符的索引
    int n = count - 1;

    // 只遍历字符序列的前半部分
    for (int j = (n - 1) >> 1; j >= 0; j--) {

        // 计算与当前索引 j 对称的位置
        int k = n - j;

        // 获取两个对称位置上的字符
        char cj = value[j];
        char ck = value[k];

        // 交换两个字符
        value[j] = ck;
        value[k] = cj;
    }

    // 返回当前对象
    return this;
}整个反转过程可以分为两步。
1. 确定需要遍历的范围
int n = count - 1;n 表示字符序列最后一个字符的索引。
例如:
k e r w i m
0 1 2 3 4 5此时:
count = 6
n = 5循环的起始位置:
(n - 1) >> 1右移一位可以理解为除以 2:
(n - 1) >> 1

等价于

(n - 1) / 2因此只需要遍历字符序列的前半部分。
2. 交换前后对称位置的字符
每次循环都会计算与当前索引 j 对称的位置:
int k = n - j;例如:
k e r w i m
0 1 2 3 4 5交换过程为:
0 ↔ 5

1 ↔ 4

2 ↔ 3最终得到:
m i w r e k因此,reverse() 并不需要从头到尾把所有位置都重复处理,只需要遍历一半的位置,并在每次循环中同时交换前后两个字符。
可以简单理解为:
找到前后两个对称位置
        ↓
交换两个字符
        ↓
逐渐向中间移动
        ↓
完成整个字符序列的反转reverse() 最后返回:
return this;也就是返回当前 StringBuilder 对象,因此还可以继续进行链式调用:
String result = new StringBuilder("kerwim")
        .reverse()
        .append("-Java")
        .toString();

System.out.println(result);输出结果:
miwrek-Java上面的源码属于较早版本 JDK 中基于
char[]的经典实现,主要用于理解reverse()的基本交换思路。不同 JDK 版本中的具体实现细节可能有所不同。
5. equals() 与 == 的区别与用法
5.1 简单示例
先来看一个简单的例子:
String str1 = new String("Java");
String str2 = new String("Java");

// 比较字符串内容
System.out.println(str1.equals(str2));

// 比较两个引用是否指向同一个对象
System.out.println(str1 == str2);输出结果:
true
false虽然 str1 和 str2 保存的字符串内容都是 "Java",但它们是通过两次 new String() 创建出来的两个不同对象。
因此:
equals() → 比较字符串内容是否相同

== → 比较两个引用是否指向同一个对象对于引用类型来说,== 比较的是两个引用是否指向同一个对象。
而 equals() 的具体比较规则,则取决于对应的类是否重写了这个方法。
先来看 Object 类中的 equals():
public boolean equals(Object obj) {
    return this == obj;
}可以看到,Object 默认的 equals() 实际上就是通过 == 进行比较。
因此,如果一个类没有重写 equals() 方法:
equals()
   ↓
默认使用 Object.equals()
   ↓
本质上还是使用 ==
   ↓
判断是否为同一个对象但在实际开发中,很多类都会根据自己的业务含义重写 equals()。
例如 String。
我们比较两个字符串时,通常关心的是:
字符串中的内容是否相同而不是:
是不是同一个 String 对象因此,String 重写了 equals() 方法,使其按照字符串内容进行比较。
5.2 String.equals() 的实现
以 JDK 17 中的 String.equals() 为例:
public boolean equals(Object anObject) {

    // 如果两个引用指向同一个对象,直接返回 true
    if (this == anObject) {
        return true;
    }

    // 判断传入对象是否为 String
    if (anObject instanceof String) {

        String aString = (String) anObject;

        // 两个字符串使用相同的内部编码方式
        if (coder() == aString.coder()) {

            // 根据 LATIN1 或 UTF16 进行内容比较
            return isLatin1()
                    ? StringLatin1.equals(value, aString.value)
                    : StringUTF16.equals(value, aString.value);
        }
    }

    return false;
}首先会判断:
this == anObject如果两个引用本身就指向同一个 String 对象,那么字符串内容肯定相同,可以直接返回:
true如果不是同一个对象,则继续判断对方是不是 String,然后比较两个字符串内部保存的数据。
以 Latin-1 的比较实现为例:
@HotSpotIntrinsicCandidate
public static boolean equals(byte[] value, byte[] other) {

    // 长度相同才有继续比较的必要
    if (value.length == other.length) {

        // 逐个比较数组中的字节
        for (int i = 0; i < value.length; i++) {

            // 任意一个位置不同,直接返回 false
            if (value[i] != other[i]) {
                return false;
            }
        }

        return true;
    }

    return false;
}基本思路就是:
是不是同一个对象?
        ↓
是 → true
        ↓
否
        ↓
是不是 String?
        ↓
否 → false
        ↓
是
        ↓
比较内部数据
        ↓
全部相同 → true
存在不同 → falseJDK 9 之后,String 内部使用 byte[] 保存字符串数据,因此这里比较的是字节数组。
再来看 JDK 8 中的实现,会更加直观一些:
public boolean equals(Object anObject) {

    // 判断是否为同一个对象
    if (this == anObject) {
        return true;
    }

    // 判断对象是否为 String 类型
    if (anObject instanceof String) {

        String anotherString = (String) anObject;

        // 获取当前字符串长度
        int n = value.length;

        // 两个字符串长度相同才继续比较
        if (n == anotherString.value.length) {

            char[] v1 = value;
            char[] v2 = anotherString.value;

            int i = 0;

            // 逐个比较字符
            while (n-- != 0) {

                // 任意字符不同,返回 false
                if (v1[i] != v2[i]) {
                    return false;
                }

                i++;
            }

            return true;
        }
    }

    return false;
}JDK 8 中 String 内部使用 char[] 保存数据,因此比较过程可以简单理解为:
先比较长度
    ↓
长度不同 → false
    ↓
长度相同
    ↓
逐个比较字符
    ↓
全部相同 → true5.3 equals() 和 == 应该怎么用
判断两个字符串的内容是否相同:
String str1 = new String("你好");
String str2 = new String("你好");

// 比较字符串内容
System.out.println(str1.equals(str2));输出:
true判断两个引用是否指向同一个对象:
String str1 = new String("你好");
String str2 = new String("你好");

// 比较两个引用是否指向同一个对象
System.out.println(str1 == str2);输出:
false需要注意字符串常量池带来的特殊情况:
String str1 = "你好";
String str2 = "你好";

System.out.println(str1 == str2);输出通常为:
true这是因为两个字符串字面量会复用字符串常量池中的同一个 String 对象:
str1 ──┐
       ├──> "你好"
str2 ──┘但这并不意味着以后比较字符串内容应该使用 ==。
判断字符串内容是否相等,仍然应该使用:
str1.equals(str2);因此可以直接记住:
基本数据类型:

== → 比较值


引用类型:

== → 比较是否为同一个对象


String:

equals() → 比较字符串内容

== → 比较是否为同一个 String 对象实际开发中,比较字符串内容时一般使用:
str1.equals(str2);如果字符串可能为 null,为了避免 NullPointerException,还可以写成:
"Java".equals(str);或者使用:
Objects.equals(str1, str2);其中 Objects.equals() 可以安全处理 null:
Objects.equals(null, null);结果为:
true所以最重要的一句话就是:
比较字符串内容用
equals(),判断两个引用是否指向同一个对象用==。
6. String拼接字符串
6.1 + 号操作符的本质
在 Java 中,+ 不仅可以用于数值运算,也可以用于字符串拼接。
从使用角度来看,+ 可以理解为 Java 提供的一种语法糖,让字符串拼接的代码写起来更加简单。
例如:
class Demo {

    public static void main(String[] args) {

        String kerwim = "科尔沃";
        String niuma = " 牛马";

        System.out.println(kerwim + niuma);
    }
}在 Java 8 环境下,可以使用:
javap -c Demo.class查看编译后的字节码。
字节码和
javap会在 JVM 部分详细介绍,这里先简单看一下字符串拼接相关的部分即可。
反编译后可以看到类似下面的内容:
Compiled from "Demo.java"
class Demo {
  Demo();
    Code:
       0: aload_0
       1: invokespecial #1
       4: return

  public static void main(java.lang.String[]);
    Code:
       0: ldc           #2                  // String 科尔沃
       2: astore_1
       3: ldc           #3                  // String 牛马
       5: astore_2

       6: getstatic     #4                  // Field java/lang/System.out:Ljava/io/PrintStream;

       9: new           #5                  // class java/lang/StringBuilder
      12: dup
      13: invokespecial #6                  // Method java/lang/StringBuilder."<init>":()V

      16: aload_1
      17: invokevirtual #7                  // Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;

      20: aload_2
      21: invokevirtual #7                  // Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;

      24: invokevirtual #8                  // Method java/lang/StringBuilder.toString:()Ljava/lang/String;

      27: invokevirtual #9                  // Method java/io/PrintStream.println:(Ljava/lang/String;)V
      30: return
}即使暂时不了解这些字节码指令,也可以重点关注几个位置。
首先:
9: new #5 // class java/lang/StringBuilder这里创建了一个 StringBuilder 对象。
接着:
17: invokevirtual ... StringBuilder.append调用了 StringBuilder 的 append() 方法,将:
"科尔沃"追加到 StringBuilder 中。
然后:
21: invokevirtual ... StringBuilder.append再次调用 append(),将:
" 牛马"继续追加进去。
最后:
24: invokevirtual ... StringBuilder.toString调用 toString(),得到最终的 String 对象。
因此,在 Java 8 中:
kerwim + niuma可以大致理解为:
new StringBuilder()
        .append(kerwim)
        .append(niuma)
.toString();换成完整的 Java 代码,大致可以理解为:
class Demo {

    public static void main(String[] args) {

        String kerwim = "科尔沃";
        String niuma = " 牛马";

        String result = new StringBuilder()
                .append(kerwim)
                .append(niuma)
                .toString();

        System.out.println(result);
    }
}所以在 Java 8 中,字符串 + 拼接的核心可以简单理解为:
+
↓
StringBuilder
↓
append()
↓
toString()
↓
得到最终 String也就是说,我们负责写更加简洁的:
kerwim + niuma编译器则帮助我们完成底层更加繁琐的字符串拼接操作。
需要注意,从 Java 9 开始,字符串拼接的底层实现进行了优化,通常会使用
invokedynamic和StringConcatFactory,不再简单地全部转换为StringBuilder。但在理解 Java 8 的字符串拼接原理时,可以把+理解为StringBuilder.append()的语法糖。
6.2 为什么循环中更推荐使用 StringBuilder.append()
在字符串拼接次数较少时,直接使用 + 操作符通常没有什么问题。
但是,如果在循环体中频繁进行字符串拼接,就更推荐使用 StringBuilder.append()。
例如:
String result = "";

for (int i = 0; i < 100000; i++) {

    // String 是不可变对象
    // 每次拼接都会产生新的字符串结果
    result += "六六六";
}在 Java 8 等较早版本中,这种循环中的字符串拼接可以大致理解为每次循环都会执行类似下面的操作:
result = new StringBuilder()
        .append(result)
        .append("六六六")
.toString();也就是说,每次循环都可能涉及:
创建 StringBuilder
        ↓
复制之前的字符串内容
        ↓
append() 新内容
        ↓
toString()
        ↓
创建新的 String如果循环次数很多,就会产生大量临时对象,不仅增加内存开销,也会增加 GC 的压力,从而影响程序性能。
更好的方式是在循环外部创建一个 StringBuilder,然后在循环中不断调用 append():
StringBuilder sb = new StringBuilder();

for (int i = 1; i < 10; i++) {

    String kerwim = "科尔森";
    String niuma = "牛马";

    // 在同一个 StringBuilder 对象中不断追加内容
    sb.append(kerwim);
    sb.append(niuma);
}

System.out.println(sb);这样整个循环过程中主要操作的是同一个 StringBuilder 对象,避免了大量无意义的中间 String 对象。
可以做一个简单的性能测试。
第一种方式,在 for 循环中使用 +:
String result = "";

for (int i = 0; i < 100000; i++) {
    result += "六六六";
}第二种方式,在循环外创建 StringBuilder,循环内部使用 append():
StringBuilder sb = new StringBuilder();

for (int i = 0; i < 100000; i++) {
    sb.append("六六六");
}在实际测试中,两种写法的性能差距可能非常明显。
例如某次测试结果:
循环中使用 +          → 6212 ms

使用 StringBuilder → 不到 1 ms具体执行时间会受到 JDK 版本、JIT 优化、CPU、循环次数以及测试方式等因素影响,因此这个时间只能作为示例,不能认为所有机器都会得到完全相同的结果。
但整体结论是不变的:
少量字符串拼接
        ↓
直接使用 +


循环中频繁拼接字符串
        ↓
优先使用 StringBuilder.append()Java 9 之后字符串
+的底层实现已经进行了优化,通常会使用invokedynamic和StringConcatFactory。但由于 String 本身仍然是不可变对象,在循环中不断执行result += ...仍然会不断生成新的字符串结果,因此大量拼接时依然更适合使用StringBuilder。
6.3 append 方法源码解析
来看一下 StringBuilder 的 append() 方法:
public StringBuilder append(String str) {
    super.append(str);
    return this;
}这几行代码本身比较简单,真正的追加逻辑位于父类 AbstractStringBuilder 中:
public AbstractStringBuilder append(String str) {

    // 如果传入 null,则按照字符串 "null" 处理
    if (str == null) {
        return appendNull();
    }

    // 获取待追加字符串的长度
    int len = str.length();

    // 检查内部数组容量是否足够
    ensureCapacityInternal(count + len);

    // 将 str 中的字符复制到内部 value 数组
    str.getChars(0, len, value, count);

    // 更新当前已经使用的字符数量
    count += len;

    return this;
}这里使用的是 JDK 8 中基于
char[]的经典实现。JDK 9 之后AbstractStringBuilder的底层存储已经改为byte[],但append()的核心思想仍然类似。
整个 append() 的执行过程可以分为下面几步。
1)判断字符串是否为 null
如果传入的是 null:
StringBuilder builder = new StringBuilder();

builder.append((String) null);

System.out.println(builder);输出结果:
null因为 append() 会调用:
appendNull();源码如下:
private AbstractStringBuilder appendNull() {

    int c = count;

    // "null" 一共需要 4 个字符的位置
    ensureCapacityInternal(c + 4);

    final char[] value = this.value;

    // 依次写入 n、u、l、l
    value[c++] = 'n';
    value[c++] = 'u';
    value[c++] = 'l';
    value[c++] = 'l';

    // 更新已经使用的字符数量
    count = c;

    return this;
}也就是说:
builder.append((String) null);并不会真正把一个 null 对象放进去,而是追加:
"null"2)获取待拼接字符串的长度
int len = str.length();例如:
str = "kerwim";那么:
len = 63)检查内部数组容量是否足够
接下来调用:
ensureCapacityInternal(count + len);其中:
count → 当前已经保存的字符数量

len   → 本次准备追加的字符数量

count + len → 本次追加完成后至少需要的容量ensureCapacityInternal() 的源码如下:
private void ensureCapacityInternal(int minimumCapacity) {

    // 当前容量不足,需要进行扩容
    if (minimumCapacity - value.length > 0) {

        value = Arrays.copyOf(
                value,
                newCapacity(minimumCapacity)
        );
    }
}由于 StringBuilder 内部使用数组保存字符,因此数组容量并不是无限的。
如果:
minimumCapacity <= value.length说明当前数组还能装得下,不需要扩容。
如果:
minimumCapacity > value.length说明当前数组容量已经不足,需要先计算新的容量,然后通过:
Arrays.copyOf()创建一个更大的数组,并把原来的内容复制过去。
因此这里的核心逻辑就是:
准备追加字符串
      ↓
计算需要的容量
      ↓
当前数组够不够?
      ↓
够      → 直接使用
不够 → 扩容后再使用4)将字符串复制到内部数组
容量确认没有问题之后,会调用:
str.getChars(0, len, value, count);可以简单理解为:
把 str 中索引 0 ~ len 的内容
        ↓
复制到 value 数组
        ↓
从 count 位置开始存放例如原来的内容是:
Hello此时:
count = 5再执行:
append("Java");就会把:
Java从 value[5] 开始继续写入:
H e l l o J a v a
0 1 2 3 4 5 6 7 85)更新 count
字符串复制完成之后:
count += len;用于更新当前实际保存的字符数量。
需要注意:
count表示当前已经使用了多少个字符,并不是内部数组value的长度。
例如:
value.length = 16
count = 9表示内部数组总容量是 16,但目前只使用了其中的 9 个位置。
因此,append() 的整个核心流程可以总结为:
append(str)
    ↓
str == null?
    ↓
是 → 追加 "null"

否
    ↓
获取 str.length()
    ↓
检查内部数组容量
    ↓
容量不足则扩容
    ↓
将 str 复制到 value 数组
    ↓
更新 count
    ↓
return this最后返回:
return this;因此 StringBuilder 可以进行链式调用:
String result = new StringBuilder()
        .append("kerwim")
        .append("-")
        .append("Java")
        .toString();

System.out.println(result);输出结果:
kerwim-Java6.4 String.concat() 拼接字符串
除了使用 + 操作符和 StringBuilder.append() 之外,String 类本身也提供了 concat() 方法来进行字符串拼接。
例如:
String kerwim = "科尔森";
String niuma = "牛马";

// 使用 concat() 拼接字符串
System.out.println(kerwim.concat(niuma));输出结果:
科尔森牛马concat() 的作用和 StringBuilder.append() 有些类似,都是将一段字符串追加到另一段字符串后面。
来看较早版本 JDK 中 concat() 的实现:
public String concat(String str) {

    // 获取待拼接字符串的长度
    int otherLen = str.length();

    // 如果拼接的是空字符串,直接返回当前对象
    if (otherLen == 0) {
        return this;
    }

    // 获取当前字符串长度
    int len = value.length;

    // 创建一个更大的数组,并复制当前字符串内容
    char[] buf = Arrays.copyOf(value, len + otherLen);

    // 将 str 的内容继续复制到 buf 后面
    str.getChars(buf, len);

    // 根据新的字符数组创建 String 对象
    return new String(buf, true);
}上面的源码属于较早版本 JDK 中基于
char[]的实现。JDK 9 之后String底层已经改为byte[],具体源码有所变化,但concat()的核心思想没有改变。
整个过程可以简单理解为:
原字符串
   ↓
计算拼接后的长度
   ↓
创建新的数组
   ↓
复制原字符串
   ↓
追加新的字符串
   ↓
创建新的 String 对象其中有几个值得注意的地方。
1)如果拼接的是空字符串,直接返回当前 String
例如:
String text = "kerwim";

String result = text.concat("");

System.out.println(text == result);输出结果:
true因为:
if (otherLen == 0) {
    return this;
}此时字符串内容没有发生变化,因此没有必要创建新的 String 对象。
2)正常拼接时,会返回新的 String 对象
例如:
String text = "kerwim";

// concat() 不会修改原来的 String
String result = text.concat(" Java");

System.out.println(text);
System.out.println(result);输出:
kerwim
kerwim Java这是因为 String 本身是不可变对象,concat() 并不会直接修改原字符串,而是生成新的字符串结果。
3)concat() 遇到 null 会抛出异常
例如:
String text = "kerwim";

String result = text.concat(null);会抛出:
NullPointerException因为源码首先会调用:
str.length();如果 str == null,自然就会产生 NullPointerException。
而使用 +:
String text = "kerwim";

System.out.println(text + null);输出:
kerwimnull+ 会把 null 转换成字符串:
"null"因此两者在处理 null 时存在明显区别:
"kerwim".concat(null)
        ↓
NullPointerException


"kerwim" + null
        ↓
"kerwimnull"4)大量字符串拼接不适合使用 concat()
如果只拼接少量字符串:
String result = str1.concat(str2);完全没有问题。
但是如果需要连续拼接很多字符串:
String result = "";

for (int i = 0; i < 10000; i++) {
    result = result.concat("Java");
}由于 String 是不可变对象,每次 concat() 都可能产生新的字符串结果,并复制之前的字符串内容。
随着拼接次数增加,会产生越来越多的临时对象和数组复制操作。
这种情况下更适合使用:
StringBuilder builder = new StringBuilder();

for (int i = 0; i < 10000; i++) {
    builder.append("Java");
}

String result = builder.toString();所以几种常见字符串拼接方式可以简单理解为:
| 方式 | 特点 | 常见场景 |
|---|---|---|
+ | 写法最简单、直观 | 少量字符串拼接 |
concat() | String 自带的拼接方法 | 少量 String 之间的拼接 |
StringBuilder.append() | 可以在同一个对象中不断追加 | 循环、大量字符串拼接 |
需要注意,具体性能还会受到 JDK 版本和编译器优化影响,因此没有必要为了少量字符串拼接刻意使用 concat()。
通常可以简单记住:
简单拼接
    ↓
直接使用 +

大量、循环拼接
    ↓
StringBuilder.append()

concat()
    ↓
可以使用,但主要适合少量 String 拼接6.5 String.join() 拼接字符串
String 类还提供了一个静态方法 join(),可以按照指定的分隔符将多个字符串连接起来。
例如:
String kerwim = "科尔森";
String niuma = "牛马";

// 使用空字符串作为连接符
String cmower = String.join("", kerwim, niuma);

System.out.println(cmower);输出结果:
科尔森牛马join() 的第一个参数就是字符串连接符。
例如使用 - 作为连接符:
String message = String.join(
"-",
"科尔森",
"太特么",
"牛马了"
);
System.out.println(message);输出结果:
科尔森-太特么-牛马了也就是说:
String.join(连接符, 字符串1, 字符串2, 字符串3...)可以将多个字符串按照指定的连接符拼接起来。
来看一下 join() 方法的源码:
public static String join(
CharSequence delimiter,
CharSequence... elements) {
// 连接符不能为 null
Objects.requireNonNull(delimiter);
// 可变参数数组不能为 null
Objects.requireNonNull(elements);
// 创建 StringJoiner
StringJoiner joiner = new StringJoiner(delimiter);
// 遍历所有需要拼接的字符串
for (CharSequence cs : elements) {
joiner.add(cs);
}
// 返回最终拼接结果
return joiner.toString();
}可以看到,String.join() 内部会创建一个 StringJoiner 对象:
StringJoiner joiner = new StringJoiner(delimiter);然后通过 for-each 遍历可变参数中的所有元素:
for (CharSequence cs : elements) {
joiner.add(cs);
}依次将字符串添加到 StringJoiner 中。
最后调用:
joiner.toString();返回最终的 String 对象。
所以整个过程可以简单理解为:
String.join()
↓
创建 StringJoiner
↓
设置连接符 delimiter
↓
遍历所有字符串
↓
joiner.add()
↓
toString()
↓
返回最终 StringString.join() 特别适合这种需要按照固定分隔符拼接多个字符串的场景:
String result = String.join(
", ",
"Java",
"MySQL",
"Redis",
"Spring Boot"
);
System.out.println(result);输出结果:
Java, MySQL, Redis, Spring Boot相比手动不断拼接分隔符,String.join() 的写法更加简洁直观。
6.6 StringUtils.join() 拼接字符串
在实际开发中,Apache Commons Lang 提供的:
org.apache.commons.lang3.StringUtils也经常用于处理字符串,其中 StringUtils.join() 就可以用来进行字符串拼接。
这里暂时不展开 Maven 依赖和导包,直接看项目中的使用方式:
String kerwim = "科尔森";
String niuma = "牛马";
// 将多个字符串拼接在一起
String result = StringUtils.join(kerwim, niuma);
System.out.println(result);输出结果:
科尔森牛马StringUtils.join() 对 null 的处理也比较友好,不容易因为待拼接的数据中存在 null 而直接抛出 NullPointerException。
例如:
StringUtils.join(null) = null
StringUtils.join([]) = ""
StringUtils.join([null]) = ""
StringUtils.join(["a", "b", "c"]) = "abc"
StringUtils.join([null, "", "a"]) = "a"除了直接拼接,也可以指定分隔符。
例如:
String[] array = {"Java", "MySQL", "Redis"};
// 使用 "-" 作为分隔符
String result = StringUtils.join(array, "-");
System.out.println(result);输出结果:
Java-MySQL-Redis来看一下 StringUtils.join() 的部分源码:
public static String join(
final Object[] array,
String separator,
final int startIndex,
final int endIndex) {
// 数组为 null,直接返回 null
if (array == null) {
return null;
}
// 分隔符为 null,则按照空字符串处理
if (separator == null) {
separator = EMPTY;
}
// 创建 StringBuilder 保存拼接结果
final StringBuilder buf =
new StringBuilder(noOfItems * 16);
// 遍历指定范围内的元素
for (int i = startIndex; i < endIndex; i++) {
// 除第一个元素外,在元素之间添加分隔符
if (i > startIndex) {
buf.append(separator);
}
// null 元素不会追加到结果中
if (array[i] != null) {
buf.append(array[i]);
}
}
return buf.toString();
}可以看到,StringUtils.join() 的内部最终仍然使用了:
StringBuilder来完成字符串拼接。
整个过程可以简单理解为:
StringUtils.join()
↓
处理 null 和分隔符
↓
创建 StringBuilder
↓
遍历数组中的元素
↓
append() 追加分隔符和元素
↓
toString()
↓
返回最终字符串所以 StringUtils.join() 本质上还是对字符串拼接逻辑进行了一层封装。
相比自己手动处理 StringBuilder、分隔符以及 null,它在实际项目中使用起来会更加方便。
7. String 拆分字符串
字符串拆分最常用的方法之一,就是 String 类提供的 split()。
假如现在有这样一段字符串:
kerwim,一名牛马程序员需要按照中文逗号 , 进行拆分,那么可以写成:
String kerwim = "kerwim,一名牛马程序员";
// 判断字符串中是否包含中文逗号
if (kerwim.contains(",")) {
// 按照中文逗号拆分字符串
String[] parts = kerwim.split(",");
System.out.println(
"第一部分:" + parts[0]
+ " 第二部分:" + parts[1]
);
} else {
throw new IllegalArgumentException("当前字符串没有包含逗号");
}输出结果:
第一部分:kerwim 第二部分:一名牛马程序员如果分隔符是普通字符,例如中文逗号,这种写法没有什么问题。
但是需要特别注意:
split()方法接收的参数并不是普通字符串,而是正则表达式。
例如:
public String[] split(String regex)参数名称本身就是:
regex也就是 Regular Expression(正则表达式)。
因此,如果分隔符本身属于正则表达式中的特殊字符,直接传入 split() 就可能产生意料之外的结果,甚至抛出 PatternSyntaxException。
正则表达式中比较常见的特殊字符包括:
\ ^ $ . | ? * + ( ) [ ] { }例如,我们想按照英文句点 . 拆分:
String text = "Java.MySQL.Redis";
// 错误示例
String[] parts = text.split(".");这里的 . 在正则表达式中表示:
任意字符因此它不会被当成普通的句点处理。
正确写法需要进行转义:
String text = "Java.MySQL.Redis";
// \\ 表示 Java 字符串中的反斜杠
// \. 表示正则表达式中的普通句点
String[] parts = text.split("\\.");
System.out.println(Arrays.toString(parts));输出结果:
[Java, MySQL, Redis]例如按照 | 拆分:
String text = "Java|MySQL|Redis";
// | 在正则表达式中具有特殊含义,需要转义
String[] parts = text.split("\\|");
System.out.println(Arrays.toString(parts));输出结果:
[Java, MySQL, Redis]如果分隔符是动态获取的,或者不确定它是不是正则表达式中的特殊字符,可以使用:
Pattern.quote()将分隔符按照普通字符串处理。
例如:
String text = "Java|MySQL|Redis";
String separator = "|";
// 将分隔符转换为正则表达式中的普通文本
String[] parts = text.split(Pattern.quote(separator));
System.out.println(Arrays.toString(parts));输出结果:
[Java, MySQL, Redis]这种方式尤其适合分隔符来自变量的情况:
String separator = getSeparator();
String[] parts = text.split(Pattern.quote(separator));这样就不用自己判断:
.
|
+
*
?
\
……到底需不需要进行转义。
另外,split() 默认还会丢弃字符串末尾的空字符串。
例如:
String text = "Java,MySQL,";
String[] parts = text.split(",");
System.out.println(Arrays.toString(parts));输出:
[Java, MySQL]如果希望保留最后面的空字符串,可以使用两个参数的重载方法:
String[] parts = text.split(",", -1);
System.out.println(Arrays.toString(parts));输出:
[Java, MySQL, ]因此,使用 split() 时最重要的一点就是:
split() 按照正则表达式进行拆分,而不是单纯按照普通字符串进行拆分。
如果确定分隔符只是普通字符,可以直接使用:
text.split(",");如果分隔符可能包含正则特殊字符,更稳妥的写法是:
text.split(Pattern.quote(separator));