
Set
字数: 0 字 时长: 0 分钟
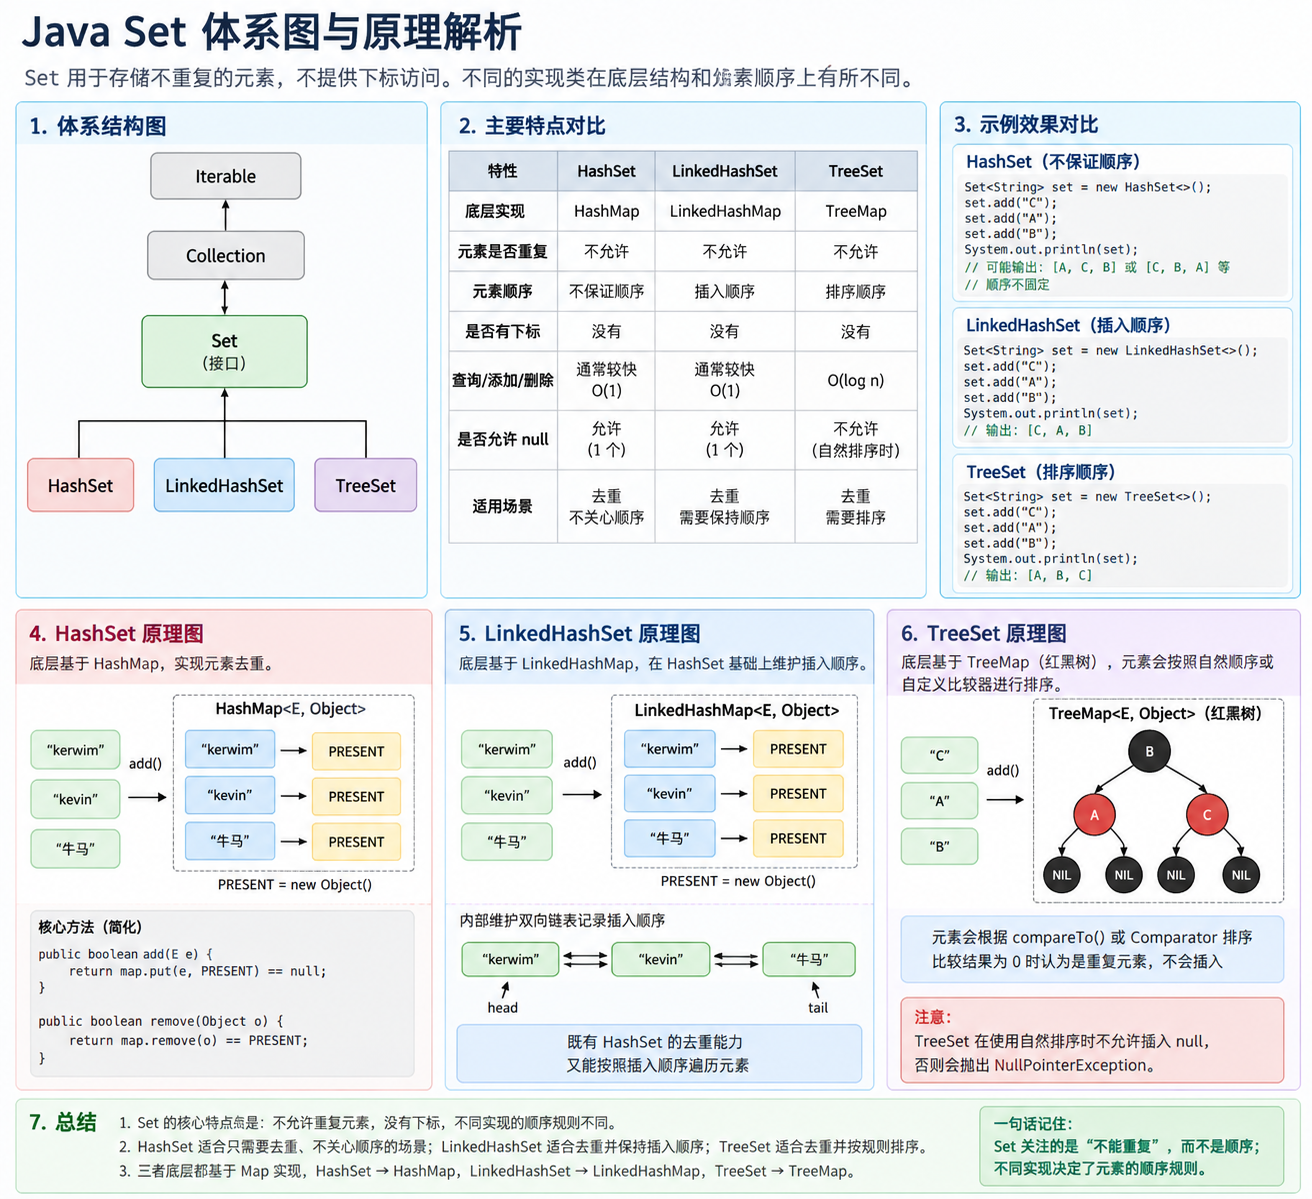
1. Set
Set 是 Java 集合框架中用于保存不重复元素的接口。
和 List 相比,最大的区别是:
List
    ↓
元素可以重复
支持索引


Set
    ↓
元素不能重复
没有索引需要注意:
Set 本身并不等于“无序”。
不同实现的顺序规则不同:
HashSet
    ↓
不保证迭代顺序


LinkedHashSet
    ↓
维护插入顺序


TreeSet
    ↓
按照排序规则保存常见实现:
Set
├── HashSet
├── LinkedHashSet
└── TreeSet1.1 HashSet
HashSet 是最常见的 Set 实现之一。
主要特点:
元素不能重复

不保证元素的迭代顺序

没有下标

查找、添加、删除通常比较快HashSet 底层基于:
HashMap实现。
可以简单理解:
HashSet 中的元素
    ↓
作为 HashMap 的 key


HashMap 的 value
    ↓
使用一个固定对象占位核心源码思想类似:
private transient HashMap<E, Object> map;

private static final Object PRESENT =
        new Object();

public HashSet() {

    map =
            new HashMap<>();
}

public boolean add(
        E element) {

    return map.put(
            element,
            PRESENT
    ) == null;
}

public boolean remove(
        Object object) {

    return map.remove(
            object
    ) == PRESENT;
}所以:
set.add("kerwim");本质上类似:
map.put(
        "kerwim",
        PRESENT
);1.1.1 HashSet 基本使用
Set<String> set =
        new HashSet<>();

// 添加元素
set.add("kerwim");
set.add("kevin");
set.add("牛马");

// 判断元素是否存在
boolean exists =
        set.contains(
                "kerwim"
        );

// 删除元素
set.remove(
        "kevin"
);

// 遍历
for (String value : set) {

    System.out.println(
            value
    );
}Set 没有:
get(index)所以不能像 List 一样:
// 不存在
// set.get(0);1.1.2 HashSet 如何去重
例如:
Set<String> set =
        new HashSet<>();

set.add("牛马");
set.add("kevin");
set.add("kerwim");
set.add("牛马");

System.out.println(
        set.size()
);结果:
3第二次添加:
"牛马"不会再次进入集合。
原因是:
HashSet
    ↓
使用 HashMap 的 key 保存元素
    ↓
Map 的 key 不能重复这里不能简单理解成:
hashCode 一样
    ↓
就是同一个元素因为:
不同对象可能拥有相同:
hashCode()也就是:
哈希冲突HashSet 判断元素是否重复,本质依赖底层 HashMap 对 key 的判断逻辑,通常会结合:
hashCode()

equals()所以自定义对象放入 HashSet 时,通常需要正确实现:
equals()

hashCode()1.1.3 HashSet 的使用场景
HashSet 最典型的用途就是:
去重例如:
Set<String> words =
        new HashSet<>();

words.add("Java");
words.add("Spring");
words.add("Java");

System.out.println(
        words.size()
);结果:
2所以如果业务只关心:
元素是否存在

元素是否重复而不关心顺序,HashSet 很合适。
1.2 LinkedHashSet
LinkedHashSet 继承自:
HashSet但它底层实际上利用:
LinkedHashMap来保存元素。
可以简单理解:
LinkedHashSet
    ↓
HashSet 的去重能力
+
LinkedHashMap 的顺序维护能力因此它最明显的特点是:
元素不重复,并且按照插入顺序进行迭代。
例如:
Set<String> set =
        new LinkedHashSet<>();

set.add("kerwim");
set.add("kevin");
set.add("牛马");

for (String value : set) {

    System.out.println(
            value
    );
}输出顺序:
kerwim
kevin
牛马1.2.1 LinkedHashSet 基本使用
Set<String> set =
        new LinkedHashSet<>();

// 添加元素
set.add("kerwim");
set.add("kevin");
set.add("牛马");

// 删除
set.remove(
        "kevin"
);

// Set 没有 set(index, value)
// 修改通常需要删除旧值,再添加新值
set.remove(
        "牛马"
);

set.add(
        "纯牛马"
);

// 查询
boolean exists =
        set.contains(
                "kerwim"
        );

System.out.println(
        exists
);由于 Set 没有:
索引所以不存在:
set.set(
        1,
        "value"
);如果需要“修改”一个元素,一般是:
删除旧元素
    ↓
添加新元素1.2.2 LinkedHashSet 的特点
可以简单记:
HashSet
    ↓
不重复
不保证顺序


LinkedHashSet
    ↓
不重复
保持插入顺序因此:
LinkedHashSet适合:
既需要去重

又希望保留原来的插入顺序的场景。
1.3 TreeSet
TreeSet 是一个:
可以自动排序的 Set 实现。
它底层基于:
TreeMap实现。
可以简单理解:
TreeSet 中的元素
    ↓
作为 TreeMap 的 key


TreeMap
    ↓
红黑树所以 TreeSet 具有:
元素不重复

没有索引

自动排序这些特点。
1.3.1 TreeSet 基本使用
Set<String> set =
        new TreeSet<>();

set.add("欧阳锋");
set.add("周芷若");
set.add("张无忌");

System.out.println(
        set
);

// 删除
set.remove(
        "周芷若"
);

// 修改
set.remove(
        "欧阳锋"
);

set.add(
        "小昭"
);

// 查询
System.out.println(
        set.contains(
                "张无忌"
        )
);TreeSet 同样没有:
直接修改元素这种操作。
一般也是:
remove()
    ↓
add()1.3.2 TreeSet 的排序规则
TreeSet 可以通过两种方式决定元素顺序:
自然排序
Comparable或者:
自定义排序
Comparator例如整数:
Set<Integer> set =
        new TreeSet<>();

set.add(30);
set.add(10);
set.add(20);

System.out.println(
        set
);结果:
[10, 20, 30]因为:
Integer本身实现了:
Comparable<Integer>所以可以进行自然排序。
也可以传入:
Comparator自定义顺序:
Set<Integer> set =
        new TreeSet<>(
                Comparator.reverseOrder()
        );

set.add(30);
set.add(10);
set.add(20);

System.out.println(
        set
);结果:
[30, 20, 10]1.3.3 TreeSet 如何判断重复
HashSet 主要依赖:
hashCode()

equals()而 TreeSet 是否认为两个元素重复,核心取决于排序比较结果。
也就是:
compareTo()或者:
Comparator.compare()如果比较结果为:
0TreeSet 会认为两个元素在排序意义上是:
相同元素因此不会同时保存。
所以:
HashSet
    ↓
HashMap
    ↓
hashCode + equals


TreeSet
    ↓
TreeMap
    ↓
Comparable / Comparator这是两者很重要的区别。
1.3.4 TreeSet 与 null
普通使用自然排序的:
TreeSet不能加入:
null例如:
TreeSet<String> set =
        new TreeSet<>();

set.add(null);通常会抛出:
NullPointerException因为:
TreeSet需要对元素进行比较排序,而:
null无法参与自然排序。
2. 小结
三个常见 Set 实现可以直接这样记:
| 实现 | 底层实现 | 顺序 | 主要特点 |
|---|---|---|---|
HashSet | HashMap | 不保证顺序 | 去重、查询快 |
LinkedHashSet | LinkedHashMap | 插入顺序 | 去重 + 保持顺序 |
TreeSet | TreeMap | 排序顺序 | 去重 + 自动排序 |
核心关系:
HashSet
    ↓
HashMap


LinkedHashSet
    ↓
LinkedHashMap


TreeSet
    ↓
TreeMap选择时可以简单记:
只需要去重
    ↓
HashSet


去重 + 保持插入顺序
    ↓
LinkedHashSet


去重 + 排序
    ↓
TreeSetSet 本身没有:
索引所以不能像 List 一样通过:
get(index)访问元素。
一句话概括:
Set 的核心是“不重复”,HashSet 负责普通去重,LinkedHashSet 在去重基础上维护插入顺序,TreeSet 在去重基础上提供排序。