
LinkedList(附源码)
字数: 0 字 时长: 0 分钟
1. LinkedList 概述
假设现在需要管理一批票据,可能只有:
100 张也可能有:
500 万张如果直接申请一个很大的数组:
可能造成空间浪费如果使用类似 ArrayList 的动态数组:
容量不足
    ↓
扩容
    ↓
重新复制数组如果已经有:
500 万个元素现在需要删除中间位置的一个元素,数组后面的大量元素还需要整体向前移动。
这正是数组结构的一个明显特点:
随机访问快

中间插入、删除需要移动元素而链表采用的思路完全不同:
元素不依赖连续的数组空间
    ↓
每个元素存放在一个节点中
    ↓
节点之间通过引用连接链表常见结构主要有:
单向链表
    ↓
节点保存 next
    ↓
指向下一个节点


双向链表
    ↓
节点保存 next 和 prev
    ↓
既可以向后找
也可以向前找LinkedList 底层使用的就是:
双向链表。
1.1 LinkedList 的基本结构
LinkedList 内部有一个非常重要的静态内部类:
Node也就是:
节点源码:
/**
 * 链表中的节点
 */
private static class Node<E> {

    // 当前节点保存的元素
    E item;

    // 下一个节点
    Node<E> next;

    // 上一个节点
    Node<E> prev;

    Node(
            Node<E> prev,
            E element,
            Node<E> next) {

        this.item =
                element;

        this.next =
                next;

        this.prev =
                prev;
    }
}一个节点由三部分组成:
prev
    ↓
上一个节点


item
    ↓
当前元素


next
    ↓
下一个节点结构图:
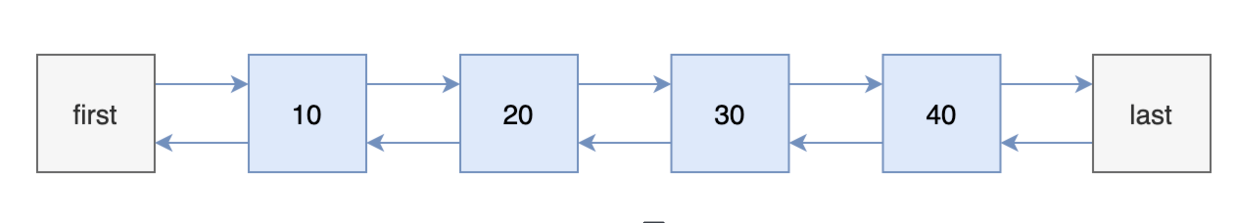
对于一个完整的双向链表:
第一个节点
    ↓
prev = null


最后一个节点
    ↓
next = null


中间节点
    ↓
prev 指向前一个节点
next 指向后一个节点可以简单理解:
null
  ↑
[A] ⇄ [B] ⇄ [C]
              ↓
nullLinkedList 内部还会维护:
first
    ↓
头节点


last
    ↓
尾节点


size
    ↓
节点数量2. LinkedList 的 CRUD
创建一个 LinkedList:
LinkedList<String> list =
new LinkedList<>();和 ArrayList 不同:
ArrayList
    ↓
底层是数组
    ↓
存在容量
    ↓
容量不足需要扩容


LinkedList
    ↓
底层是链表
    ↓
不需要预先设置数组容量
    ↓
添加元素时创建新的 Node所以 LinkedList 不存在:
数组扩容这套机制。
2.1 增
例如:
list.add(
        "张无忌"
);

list.add(
        "赵敏"
);

list.add(
        "灭绝师太"
);2.1.1 add()
add() 默认把元素添加到:
链表尾部源码:
/**
 * 将指定元素添加到链表尾部
 *
 * @param e 要添加的元素
 * @return 始终返回 true
 */
public boolean add(
        E e) {

    linkLast(e);

    return true;
}所以:
add()
    ↓
linkLast()
    ↓
尾部创建新节点2.1.2 linkLast()
linkLast() 负责:
把新节点连接到链表尾部。
源码:
/**
 * 在链表尾部添加指定元素
 *
 * @param e 要添加的元素
 */
void linkLast(
        E e) {

    // 保存原来的尾节点
    final Node<E> oldLast =
            last;

    // 创建新的尾节点
    final Node<E> newNode =
            new Node<>(
                    oldLast,
                    e,
                    null
            );

    // 更新 last
    last =
            newNode;

    // 原链表为空
    if (oldLast == null) {

        first =
                newNode;

    } else {

        // 原来的尾节点指向新节点
        oldLast.next =
                newNode;
    }

    size++;
}整个过程可以分开来看。
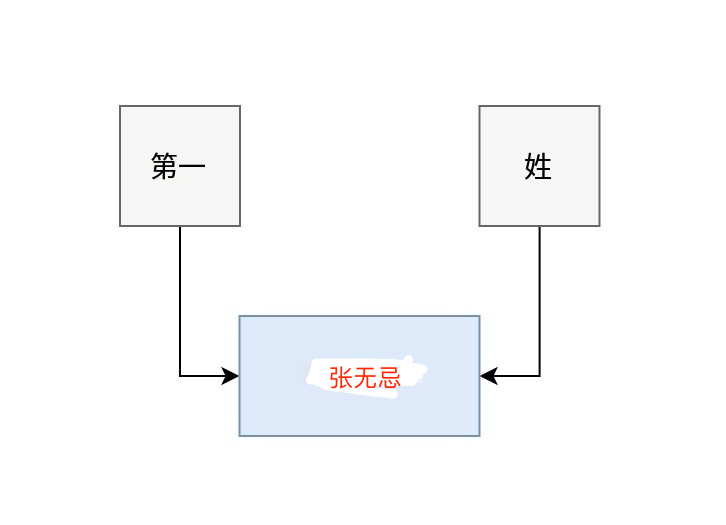
2.1.3 添加第一个元素
最开始:
first = null

last = null创建第一个节点:
prev = null

item = 张无忌

next = null然后:
first
    ↓
newNode


last
    ↓
newNode所以:
first 和 last
    ↓
同时指向第一个节点示意图:
2.1.4 添加第二个元素
第二次执行:
list.add(
        "赵敏"
);此时:
first
    ↓
第一个节点


last
    ↓
第一个节点创建:
第二个节点新节点:
prev
    ↓
第一个节点


next
    ↓
null然后:
第一个节点.next
    ↓
第二个节点


last
    ↓
第二个节点链表变成:
张无忌 ⇄ 赵敏2.1.5 添加第三个元素
继续:
list.add(
        "灭绝师太"
);新节点:
prev
    ↓
赵敏


next
    ↓
null然后:
赵敏.next
    ↓
灭绝师太


last
    ↓
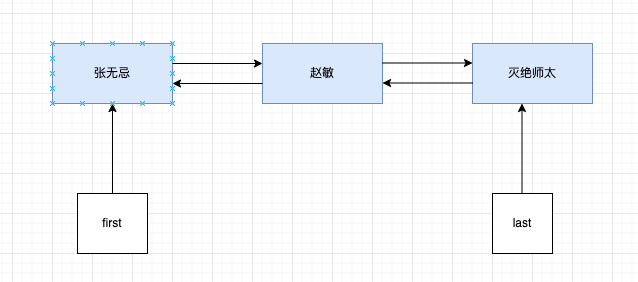
灭绝师太最终:
null
  ↑
张无忌 ⇄ 赵敏 ⇄ 灭绝师太
                    ↓
null示意图:
2.2 addFirst()
除了:
add()还可以:
addFirst()把元素添加到链表头部。
例如:
list.addFirst(
        "周芷若"
);源码:
/**
 * 在链表头部添加指定元素
 *
 * @param e 要添加的元素
 */
public void addFirst(
        E e) {

    linkFirst(e);
}真正的操作在:
linkFirst()中。
2.2.1 linkFirst()
/**
 * 在链表头部添加指定元素
 *
 * @param e 要添加的元素
 */
private void linkFirst(
        E e) {

    // 保存原来的头节点
    final Node<E> oldFirst =
            first;

    // 创建新的头节点
    final Node<E> newNode =
            new Node<>(
                    null,
                    e,
                    oldFirst
            );

    // 更新 first
    first =
            newNode;

    // 原链表为空
    if (oldFirst == null) {

        last =
                newNode;

    } else {

        // 原头节点的 prev 指向新节点
        oldFirst.prev =
                newNode;
    }

    size++;
}执行过程:
保存原 first
    ↓
创建 newNode
    ↓
newNode.next 指向原 first
    ↓
first 指向 newNode
    ↓
原 first.prev 指向 newNode例如原来:
张无忌 ⇄ 赵敏执行:
list.addFirst(
        "周芷若"
);变成:
周芷若 ⇄ 张无忌 ⇄ 赵敏2.3 addLast()
addLast() 用于:
在链表尾部添加元素源码:
/**
 * 在链表尾部添加指定元素
 *
 * @param e 要添加的元素
 */
public void addLast(
        E e) {

    linkLast(e);
}它的核心还是:
linkLast()所以:
add()
    ↓
linkLast()


addLast()
    ↓
linkLast()二者都可以把元素添加到链表尾部。
2.4 删
LinkedList 常见删除方法:
remove()
    ↓
删除第一个节点


remove(int index)
    ↓
删除指定位置节点


remove(Object o)
    ↓
删除第一次出现的指定元素


removeFirst()
    ↓
删除第一个节点


removeLast()
    ↓
删除最后一个节点2.4.1 remove(int index)
例如:
list.remove(1);源码:
/**
 * 删除指定位置上的元素
 *
 * @param index 要删除的位置
 * @return 被删除的元素
 */
public E remove(
        int index) {

    // 检查索引
    checkElementIndex(
            index
    );

    // 找到节点以后删除
    return unlink(
            node(index)
    );
}可以看到整个过程分成两步:
node(index)
    ↓
找到指定位置的节点


unlink(node)
    ↓
把节点从链表中断开2.4.2 unlink()
unlink() 是 LinkedList 删除节点的核心方法。
/**
 * 从链表中删除指定节点
 *
 * @param node 要删除的节点
 * @return 被删除节点中的元素
 */
E unlink(
        Node<E> node) {

    // 保存当前元素
    final E element =
            node.item;

    // 下一个节点
    final Node<E> next =
            node.next;

    // 上一个节点
    final Node<E> prev =
            node.prev;

    // 当前节点是头节点
    if (prev == null) {

        first =
                next;

    } else {

        // 前一个节点跳过当前节点
        prev.next =
                next;

        node.prev =
                null;
    }

    // 当前节点是尾节点
    if (next == null) {

        last =
                prev;

    } else {

        // 后一个节点跳过当前节点
        next.prev =
                prev;

        node.next =
                null;
    }

    node.item =
            null;

    size--;

    return element;
}假设:
A ⇄ B ⇄ C删除:
B原来:
A.next
    ↓
B


C.prev
    ↓
B删除以后:
A.next
    ↓
C


C.prev
    ↓
A最终:
A ⇄ C所以链表删除节点的核心就是:
修改前后节点的引用然后把当前节点:
prev

next

item清理掉。
2.5 remove(Object o)
例如:
list.remove(
        "张无忌"
);源码:
/**
 * 删除第一次出现的指定元素
 *
 * @param o 要删除的元素
 * @return 删除成功返回 true
 */
public boolean remove(
        Object o) {

    if (o == null) {

        // 从头开始遍历
        for (
                Node<E> node = first;
                node != null;
                node = node.next
        ) {

            if (node.item == null) {

                unlink(node);

                return true;
            }
        }

    } else {

        // 从头开始遍历
        for (
                Node<E> node = first;
                node != null;
                node = node.next
        ) {

            if (
                    o.equals(
                            node.item
                    )
            ) {

                unlink(node);

                return true;
            }
        }
    }

    return false;
}判断规则:
o == null
    ↓
使用 == 判断


o != null
    ↓
使用 equals() 判断找到目标节点以后:
unlink(node);完成删除。
2.6 removeFirst()
remove() 删除的也是:
第一个节点而:
removeFirst()同样负责删除头节点。
源码:
/**
 * 删除并返回链表中的第一个元素
 *
 * @return 被删除的第一个元素
 * @throws NoSuchElementException
 *         如果链表为空
 */
public E removeFirst() {

    final Node<E> firstNode =
            first;

    if (firstNode == null) {

        throw new NoSuchElementException();
    }

    return unlinkFirst(
            firstNode
    );
}如果:
first == null说明链表为空。
此时抛出:
NoSuchElementException否则调用:
unlinkFirst()2.7 unlinkFirst()
/**
 * 删除链表的第一个节点
 *
 * @param firstNode 第一个节点
 * @return 被删除节点的元素
 */
private E unlinkFirst(
        Node<E> firstNode) {

    // 保存元素
    final E element =
            firstNode.item;

    // 保存第二个节点
    final Node<E> next =
            firstNode.next;

    // 清理原来的头节点
    firstNode.item =
            null;

    firstNode.next =
            null;

    // 第二个节点成为新的 first
    first =
            next;

    // 原来只有一个节点
    if (next == null) {

        last =
                null;

    } else {

        next.prev =
                null;
    }

    size--;

    return element;
}例如:
A ⇄ B ⇄ C删除:
A首先:
next = B然后:
first
    ↓
B再把:
B.prev
    ↓
null最终:
null ← B ⇄ C2.8 改
修改指定位置元素使用:
set()例如:
list.set(
        0,
        "张三丰"
);源码:
/**
 * 替换指定位置的元素
 *
 * @param index 要修改的位置
 * @param element 新元素
 * @return 原来的元素
 */
public E set(
        int index,
        E element) {

    // 检查索引
    checkElementIndex(
            index
    );

    // 找到对应节点
    Node<E> node =
            node(index);

    // 保存旧值
    E oldValue =
            node.item;

    // 替换元素
    node.item =
            element;

    return oldValue;
}整个过程:
检查 index
    ↓
node(index)
    ↓
找到节点
    ↓
保存旧 item
    ↓
替换 item
    ↓
prev 和 next 不变2.9 node()
set()、get()、remove(index) 等操作都会涉及一个非常重要的方法:
node(index)作用是:
根据下标找到对应节点。
源码:
/**
 * 获取指定位置的节点
 *
 * @param index 节点位置
 * @return 指定位置的节点
 */
Node<E> node(
        int index) {

    // 位于前半部分
    if (
            index
                    < (
                    size >> 1
            )
    ) {

        Node<E> node =
                first;

        // 从头向后寻找
        for (
                int i = 0;
                i < index;
                i++
        ) {

            node =
                    node.next;
        }

        return node;

    } else {

        Node<E> node =
                last;

        // 从尾向前寻找
        for (
                int i =
                        size - 1;
                i > index;
                i--
        ) {

            node =
                    node.prev;
        }

        return node;
    }
}这里:
size >> 1相当于:
size / 2所以:
index 在前半部分
    ↓
从 first 开始向后找


index 在后半部分
    ↓
从 last 开始向前找例如:
0 1 2 3 4 5 6 7 8 9查找:
index = 2从:
first向后查找更近。
而:
index = 8从:
last向前查找更近。
这也是双向链表相比单向链表的一个优势:
可以根据位置
选择从头还是从尾开始遍历2.10 查
LinkedList 中常见查询方法:
indexOf(Object)
    ↓
查找元素第一次出现的位置


get(int)
    ↓
获取指定位置的元素2.10.1 indexOf()
源码:
/**
 * 返回指定元素第一次出现的位置
 * 如果不存在返回 -1
 *
 * @param o 要查找的元素
 * @return 元素索引
 */
public int indexOf(
        Object o) {

    int index =
            0;

    if (o == null) {

        // 从头向后遍历
        for (
                Node<E> node = first;
                node != null;
                node = node.next
        ) {

            if (node.item == null) {

                return index;
            }

            index++;
        }

    } else {

        // 从头向后遍历
        for (
                Node<E> node = first;
                node != null;
                node = node.next
        ) {

            if (
                    o.equals(
                            node.item
                    )
            ) {

                return index;
            }

            index++;
        }
    }

    return -1;
}逻辑和:
remove(Object)比较类似。
判断:
null
    ↓
==


非 null
    ↓
equals()如果找到:
返回 index没有找到:
返回 -12.10.2 get()
get() 本身非常简单:
public E get(
        int index) {

    checkElementIndex(
            index
    );

    return node(
            index
    ).item;
}真正的核心还是:
node(index)执行过程:
get(index)
    ↓
检查下标
    ↓
node(index)
    ↓
判断离 first 近
还是离 last 近
    ↓
遍历找到节点
    ↓
返回 node.item所以:
LinkedList.get(index)并不像:
ArrayList.get(index)那样可以直接通过数组下标定位。
LinkedList 必须:
遍历节点才能找到对应位置。
2.11 其他首尾操作
因为 LinkedList 同时实现了:
Deque所以还提供了很多首尾操作。
例如:
getFirst()
    ↓
获取第一个元素


getLast()
    ↓
获取最后一个元素


poll()
    ↓
删除并返回第一个元素


pollFirst()
    ↓
删除并返回第一个元素


pollLast()
    ↓
删除并返回最后一个元素


peekFirst()
    ↓
返回第一个元素
但不删除因此 LinkedList 不仅可以作为:
List使用,也可以作为:
Queue / Deque使用。
3. 总结
LinkedList 的核心就是:
基于 Node 节点实现的双向链表。
节点结构:
Node
├── prev
├── item
└── next整个链表:
first
  ↓
[A] ⇄ [B] ⇄ [C]
              ↑
last添加元素:
add()
    ↓
linkLast()
    ↓
尾部创建 Node
    ↓
修改前后引用头部添加:
addFirst()
    ↓
linkFirst()删除元素:
remove(index)
    ↓
node(index)
    ↓
unlink()修改元素:
set(index)
    ↓
node(index)
    ↓
修改 node.item查询元素:
get(index)
    ↓
node(index)
    ↓
遍历找到目标节点node(index) 会根据位置进行判断:
靠近前半部分
    ↓
从 first 向后找


靠近后半部分
    ↓
从 last 向前找因此 LinkedList 和 ArrayList 最大的区别来自底层结构:
ArrayList
    ↓
动态数组
    ↓
随机访问方便
    ↓
中间增删需要移动元素


LinkedList
    ↓
双向链表
    ↓
访问指定位置需要遍历
    ↓
找到节点以后
只需要调整节点引用在需要维护节点顺序、频繁进行链表位置调整的场景中,可以利用 LinkedList 的双向链表结构。
例如 LRU 的基本思想中,就需要维护:
最近使用
    ↓
移动到链表头部


最近最少使用
    ↓
位于链表尾部所以学习 LinkedList 最核心的不是死记 API,而是理解:
Node

first / last

prev / next

link

unlink

node(index)这些链表操作是如何完成的。