
HashMap(附源码)
字数: 0 字 时长: 0 分钟
Java HashMap
字数: 0 字 时长: 0 分钟
HashMap 是 Java 中常用的数据结构之一,用于存储键值对。
在 HashMap 中,每个 Key 对应一个 Value,可以通过 Key 快速访问对应的 Value,理想情况下时间复杂度可以达到:
O(1)下面先来看一个简单的增删改查示例。
1)增加元素
将一个键值对添加到 HashMap 中,可以使用 put() 方法。
例如,将名字和年龄作为键值对保存:
HashMap<String, Integer> map =
        new HashMap<>();

map.put(
        "赵敏",
        20
);

map.put(
        "小昭",
        25
);2)删除元素
从 HashMap 中删除一个键值对,可以使用 remove() 方法:
map.remove(
        "赵敏"
);3)修改元素
修改 HashMap 中某个 Key 对应的 Value,同样可以使用 put() 方法:
map.put(
        "小昭",
        30
);为什么修改和添加使用的是同一个方法?
因为:
HashMap 的 Key 是唯一的
    ↓
再次 put 相同的 Key
    ↓
新的 Value 会覆盖原来的 Value具体原因后面继续分析。
4)查找元素
根据 Key 查找对应的 Value,可以使用 get():
int age =
        map.get(
                "小昭"
);在实际开发中,HashMap 可以用于:
缓存

索引例如:
用户 ID
    ↓
Key


用户信息
    ↓
Value将用户信息保存到 HashMap 中,就可以根据用户 ID 快速查找。
又比如:
关键字
    ↓
Key


文档 ID 列表
    ↓
Value可以将文档索引保存到 HashMap 中,方便快速搜索文档。
HashMap 的实现原理基于:
哈希表底层是一个数组。
数组中的每一个位置可能保存:
一个键值对

链表

红黑树当添加一个键值对时:
Key
    ↓
计算 Hash
    ↓
计算数组下标
    ↓
找到对应桶
    ↓
保存键值对通过 Key 查找 Value 时也是类似过程:
Key
    ↓
计算 Hash
    ↓
计算数组下标
    ↓
找到对应桶
    ↓
查找对应 Value1. hash 方法的原理
简单了解 HashMap 后,先讨论第一个问题:
HashMap 的 hash 方法到底在做什么?
理解这个方法,对后面理解 HashMap 非常重要。
JDK 8 中 HashMap 的 hash() 方法:
static final int hash(
        Object key) {

    int h;

    return (
            key == null
    )
            ? 0
            : (
                    h = key.hashCode()
            ) ^ (
                    h >>> 16
            );
}这段代码的作用就是:
对 Key 的
hashCode()进行处理,得到 HashMap 最终使用的哈希值。
例如:
HashMap<String, String> map =
        new HashMap<>();

map.put(
        "zhaomin",
        "赵敏"
);来看一下 put():
public V put(
        K key,
        V value) {

    return putVal(
            hash(key),
            key,
            value,
            false,
            true
    );
}可以看到:
put()内部首先调用了:
hash(key)1.1 hash 方法的作用
前面说过,HashMap 底层使用数组。
第一次真正创建数组后,默认容量为:
16也就是说,向 HashMap 中添加元素时,需要根据 Key 的哈希值,在长度为 16 的数组中找到一个位置。
可以把数组想象成:
16 个桶每一个桶都有自己的数组下标。
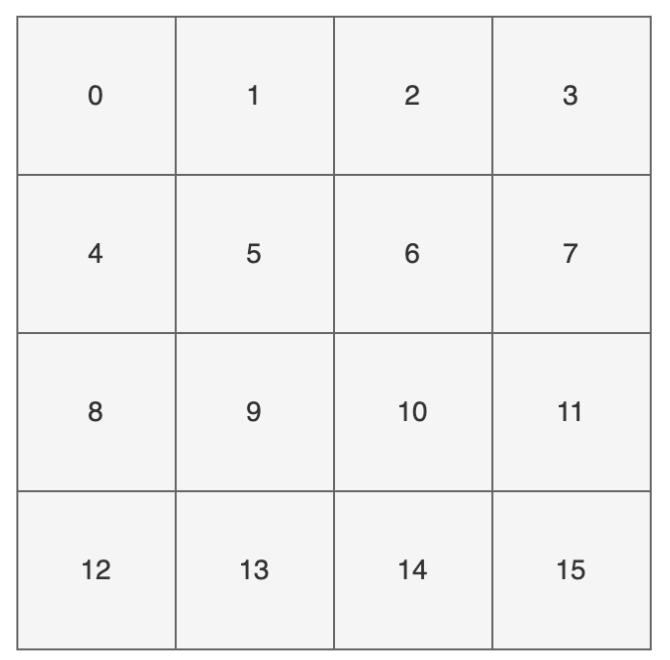
现在需要把:
Key   = zhaomin

Value = 赵敏放进这 16 个桶中的一个。
怎么确定位置?
核心计算:
(n - 1) & hash其中:
n
    ↓
数组长度


hash
    ↓
通过 hash() 方法处理后的哈希值例如:
map.put(
        "zhaomin",
        "赵敏"
);计算以后的位置为:
8也就是说:
zhaomin → 赵敏会放到:
数组下标 8对应的桶中。
所以 HashMap 保存键值对时:
hash()对于计算元素的位置非常重要。
再回到源码:
static final int hash(
        Object key) {

    int h;

    return (
            key == null
    )
            ? 0
            : (
                    h = key.hashCode()
            ) ^ (
                    h >>> 16
            );
}解释一下:
key
    ↓
需要计算哈希值的 Key如果:
key == null则:
hash = 0也就是说,Key 为 null 时,对应的哈希值为 0。
否则先执行:
key.hashCode()得到原始哈希值。
然后:
h >>> 16把哈希值无符号右移 16 位。
最后:
h ^ (h >>> 16)将两部分进行异或运算。
其中:
^
    ↓
异或运算规则:
相同
    ↓
0


不同
    ↓
1最终返回经过处理后的哈希值。
理论上,哈希值是一个 int 类型,范围非常大,大约拥有 40 亿级别的映射空间。
如果哈希值能够分布得足够均匀:
哈希冲突出现的概率就会降低。
但显然,我们不可能创建一个长度达到几十亿的数组。
HashMap 第一次真正初始化数组以后:
容量通常只有 16所以原始哈希值不能直接作为数组下标。
必须进一步通过:
(n - 1) & hash将哈希值映射到数组范围之内。
1.2 取模运算 VS 取余运算 VS 与运算
这里顺便梳理一下:
取模

取余

位与之间的关系。
严格来说:
Modulo Operation
取模运算


Remainder Operation
取余运算并不是完全相同的概念。
Java 中:
%通常表示取余。
而:
Math.floorMod()表示取模。
主要区别:
操作数都是正数
    ↓
取模和取余结果相同


存在负数
    ↓
结果可能不同原因:
取模
    ↓
商向负无穷靠近


取余
    ↓
商向 0 靠近另外,当数组长度是 2 的幂时:
取模 / 取余可以通过:
位运算来完成。
来看一个例子:
int a =
        -7;

int b =
        3;

// 取余
int remainder =
        a % b;

// 取模
int modulus =
        Math.floorMod(
                a,
                b
        );

System.out.println(
        "数字: a = "
                + a
                + ", b = "
                + b
);

System.out.println(
        "取余 (%): "
                + remainder
);

System.out.println(
        "取模 (Math.floorMod): "
                + modulus
);

// 改变正负情况
a = 7;

b = -3;

remainder =
        a % b;

modulus =
        Math.floorMod(
                a,
                b
        );

System.out.println(
        "\n数字: a = "
                + a
                + ", b = "
                + b
);

System.out.println(
        "取余 (%): "
                + remainder
);

System.out.println(
        "取模 (Math.floorMod): "
                + modulus
);输出:
数字: a = -7, b = 3
取余 (%): -1
取模 (Math.floorMod): 2

数字: a = 7, b = -3
取余 (%): 1
取模 (Math.floorMod): -2为什么会出现不同的结果?
先看普通除法。
例如:
7 ÷ 3得到:
商 = 2

余数 = 1因为:
7 = 3 × 2 + 11)取余
余数基于普通除法。
它的商:
趋向于 0例如:
-7 % 3可以考虑两种情况:
商 -2
余 -1或者:
商 -3
余 2因为取余时商趋近于:
0所以选择:
-2最终余数:
-12)取模
取模同样基于除法,只不过商:
趋向于负无穷例如:
Math.floorMod(
        -7,
        3
);因为:
-3比:
-2更靠近负无穷,所以最终结果:
2需要注意:
取模

取余都建立在除法基础上,因此:
除数不能为 03)与运算
当操作数都是正数时:
取模

取余结果一样。
例如:
7 % 3 = 1普通除法:
7 / 3
    ↓
商 2
余 1因此在很多资料中会把:
取模

取余混在一起说。
严格来说:
在操作数均为正数时,两者结果一致;出现负数时,两者可能不同。
对于 HashMap 来说,需要根据:
hash和:
table.length计算数组位置。
可以简单理解成:
hash % table.length例如数组长度:
3当:
hash = 7则:
7 % 3 = 1元素落在:
index = 1当:
hash = 8则:
8 % 3 = 2落在:
index = 2当:
hash = 9则:
9 % 3 = 0落在:
index = 0数组三个位置:
0

1

2都可以被利用。
那为什么 HashMap 并没有直接使用:
%而是使用:
&?
因为当数组长度是:
2 的 n 次方时:
hash & (length - 1)和:
hash % length结果一致。
例如:
9 % 4 = 1二进制:
9
    ↓
1001


4 - 1 = 3
    ↓
0011执行:
1001
&
0011
----
0001结果:
1再例如:
10 % 4 = 2二进制:
10
    ↓
1010


3
    ↓
0011执行:
1010
&
0011
----
0010结果:
2但如果数组长度不是:
2 的 n 次方结果就可能不同。
例如:
7 % 3 = 1但:
7
    ↓
0111


3 - 1 = 2
    ↓
0010执行:
0111
&
0010
----
0010结果:
2已经和:
7 % 3 = 1不同。
为什么长度是 2 的幂时会如此巧合?
因为:
hash / 2ⁿ相当于:
hash >> n高位表示商,而被移出去的低位就是:
hash % 2ⁿ例如:
8 = 2³二进制:
1000而:
8 - 1 = 7二进制:
0111这三个低位全部都是:
1所以:
hash & 7实际上就是:
只保留 hash 的最低 3 位。
例如:
26
    ↓
11010计算:
26 % 8因为:
8 = 2³只需要关注最低三位:
010转成十进制:
2所以:
26 % 8 = 2当执行:
hash & (length - 1)时,本质也是保留最低 n 位,其余高位清零。
例如:
hash = 14

length = 8

length - 1 = 7计算:
  1110
& 0111
------
0110结果:
6也就是:
14 % 8 = 6于是:
hash % length和:
hash & (length - 1)形成闭环。
HashMap 中,这种计算主要会出现在:
put

get过程中。
put() 最终会调用:
putVal()源码片段:
final V putVal(
        int hash,
        K key,
        V value,
        boolean onlyIfAbsent,
        boolean evict) {

    // 数组
    HashMap.Node<K, V>[] tab;

    // 当前节点
    HashMap.Node<K, V> p;

    // n 为数组长度
    // i 为数组下标
    int n;
    int i;

    if (
            (tab = table) == null
                    || (
                    n = tab.length
            ) == 0
    ) {

        // 第一次扩容
        n =
                (
                        tab = resize()
                ).length;
    }

    // 根据 hash 计算桶位置
    if (
            (
                    p = tab[
                            i = (
                                    n - 1
                            ) & hash
                    ]
            ) == null
    ) {

        tab[i] =
                newNode(
                        hash,
                        key,
                        value,
                        null
                );
    }

    // ...
}其中:
(n - 1) & hash负责计算:
数组下标从 HashMap 中 get() 时,也会再次出现同样的逻辑。
例如 getNode():
final Node<K, V> getNode(
        int hash,
        Object key) {

    Node<K, V>[] tab;

    Node<K, V> first;
    Node<K, V> e;

    int n;

    K k;

    if (
            (tab = table) != null
                    && (
                    n = tab.length
            ) > 0
                    && (
                    first =
                            tab[
                                    (
                                            n - 1
                                    ) & hash
                            ]
            ) != null
    ) {

        // 桶中的第一个节点就是目标
        if (
                first.hash == hash
                        && (
                        (
                                k = first.key
                        ) == key
                                || (
                                key != null
                                        && key.equals(k)
                        )
                )
        ) {

            return first;
        }

        // 第一个不是目标,继续遍历
        if (
                (
                        e = first.next
                ) != null
        ) {

            do {

                if (
                        e.hash == hash
                                && (
                                (
                                        k = e.key
                                ) == key
                                        || (
                                        key != null
                                                && key.equals(k)
                                )
                        )
                ) {

                    return e;
                }

            } while (
                    (
                            e = e.next
                    ) != null
            );
        }
    }

    return null;
}可以看到:
(n - 1) & hash再次出现。
简单理解:
put
    ↓
根据 hash 计算桶下标
    ↓
把键值对放入桶


get
    ↓
根据 hash 计算桶下标
    ↓
从桶中查找键值对1.3 取模运算 % 和位运算 &
可能会产生一个疑问:
取模不是应该使用
%吗?为什么 HashMap 使用&?
原因之一就是:
&可以直接进行位运算。
并且当:
b = 2ⁿ时:
a % b
=
a & (b - 1)也就是:
a % 2ⁿ
=
a & (2ⁿ - 1)例如:
a = 14

b = 8 = 2³首先:
14 % 8 = 614 的二进制:
11108:
10008 - 1:
7
    ↓
0111进行:
1110
&
0111
----
0110结果:
6和:
14 % 8结果相同。
这也解释了:
为什么 HashMap 数组容量通常保持为 2 的幂。
因为:
length - 1正好可以形成一个:
低位掩码例如:
16
    ↓
10000


16 - 1
    ↓
01111& 的规则:
两位都是 1
    ↓
1


否则
    ↓
0例如:
5 & 3二进制:
0101
&
0011
----
0001结果:
1HashMap 初始数组长度:
16那么:
16 - 1
    ↓
1515 的二进制:
00000000 00000000 00001111假设某个哈希值:
10100101 11000100 00100101和:
00000000 00000000 00001111进行 &:
   10100101 11000100 00100101
&  00000000 00000000 00001111
--------------------------------
00000000 00000000 00000101高位全部被清零,只保留最低几位:
0101即:
5所以这个 Key 对应的键值对最终会被放到:
数组下标 5的位置。
如果前面的二进制暂时看不懂,也没关系。
记住:
(n - 1) & hash
    ↓
计算 HashMap 的数组下标即可。
1.4 为什么取模运算之前要调用 hash 方法
来看这个图:
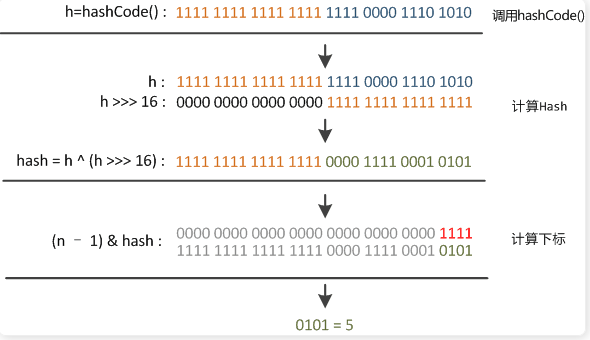
假设某个哈希值为:
11111111 11111111 11110000 11101010执行:
h >>> 16相当于把高 16 位移动到低位:
00000000 00000000 11111111 11111111然后:
h ^ (h >>> 16)进行异或。
结果:
11111111 11111111 00001111 00010101异或:
XOR
^规则:
相同
    ↓
0


不同
    ↓
1经过:
h ^ (h >>> 16)之后:
原哈希值的高位信息
    ↓
混入低位这样可以增强低位的随机性。
然后再与:
数组长度 - 1进行 & 运算。
假设数组长度为:
16则:
length - 1 = 15二进制:
00000000 00000000 00000000 00001111最终得到数组下标:
00000000 00000000 00000000 00000101也就是:
5再看之前假设的另外一个哈希值:
00000000 10100101 11000100 00100101执行:
h >>> 16得到:
00000000 00000000 00000000 10100101再执行:
h ^ (h >>> 16)得到:
00000000 10100101 00111011 10000000然后和:
length - 1进行 &:
00000000 00000000 00000000 00001111最终:
00000000 00000000 00000000 00000000也就是:
index = 0所以:
hash 方法的作用就是对原始 hashCode 进行进一步优化,将高位信息混入低位。
可以简单理解:
key.hashCode()
    ↓
h
    ↓
h >>> 16
    ↓
高位移动到低位
    ↓
h ^ (h >>> 16)
    ↓
高低位混合
    ↓
得到新的 hash这样可以让数据在数组中的分布更加均衡,减少哈希冲突。
1.5 小结
hash() 方法的主要作用:
获取 Key 的 hashCode
    ↓
高 16 位右移
    ↓
与原 hashCode 异或
    ↓
得到新的 hash然后:
hash
    ↓
(n - 1) & hash
    ↓
得到 Bucket 下标HashMap 底层:
数组
    ↓
Bucket桶中可能保存:
单个节点

链表

红黑树整个过程:
Key
    ↓
hashCode()
    ↓
hash()
    ↓
(n - 1) & hash
    ↓
数组下标
    ↓
Bucket这个过程直接影响 HashMap 中键值对的查找效率。
2. HashMap 的扩容机制
数组一旦初始化以后:
长度不能改变所以:
ArrayList需要通过创建新数组完成扩容。
HashMap 的底层同样使用数组。
随着 HashMap 中元素不断增加:
数组容量不足
    ↓
需要扩容扩容以后:
桶数量增加
    ↓
部分冲突可能被分散
    ↓
查询效率可能提高来看一个例子,先把容量看作:
16HashMap<String, String> map =
new HashMap<>();
map.put(
"zhangwuji",
"张无忌"
);
map.put(
"zhaomin",
"赵敏"
);
map.put(
"zhouzhiruo",
"周芷若"
);
map.put(
"xiaozhao",
"小昭"
);
map.put(
"yinyewang",
"殷野王"
);
map.put(
"yideng",
"殷离"
);
map.put(
"yangxiao",
"杨逍"
);
map.put(
"weiyixiao",
"韦一笑"
);
// 遍历 HashMap
for (
String key :
map.keySet()
) {
int h;
int n =
16;
int hash =
(
key == null
)
? 0
: (
h = key.hashCode()
) ^ (
h >>> 16
);
int index =
(
n - 1
) & hash;
System.out.println(
key
+ "的hash值 : "
+ hash
+ " 的索引 : "
+ index
);
}输出:
zhangwuji的hash值 : -1460972958 的索引 : 2
yangxiao的hash值 : -431770781 的索引 : 3
weiyixiao的hash值 : 1854843780 的索引 : 4
zhouzhiruo的hash值 : -1262322553 的索引 : 7
yideng的hash值 : -730738309 的索引 : 11
zhaomin的hash值 : -323244979 的索引 : 13
xiaozhao的hash值 : 265727213 的索引 : 13
yinyewang的hash值 : 1055043855 的索引 : 15可以看到:
zhaomin

xiaozhao最终落到了同一个:
index = 13也就是说发生了:
哈希冲突需要通过:
拉链法把它们放到同一个桶中。
此时查询的时候:
不能只定位数组
    ↓
还需要继续查找桶中的节点如果把数组长度:
16扩容为:
32将前面代码中的:
n = 16;改成:
n = 32;输出:
zhangwuji的hash值 : -1460972958 的索引 : 2
yangxiao的hash值 : -431770781 的索引 : 3
weiyixiao的hash值 : 1854843780 的索引 : 4
zhouzhiruo的hash值 : -1262322553 的索引 : 7
yideng的hash值 : -730738309 的索引 : 27
zhaomin的hash值 : -323244979 的索引 : 13
xiaozhao的hash值 : 265727213 的索引 : 13
yinyewang的hash值 : 1055043855 的索引 : 15可以看到:
zhaomin

xiaozhao仍然都位于:
13数组本身不会自动扩容。
所以 HashMap 扩容需要:
创建更大的数组
    ↓
转移旧数组中的元素
    ↓
重新确定元素位置整个过程本身是比较耗时的。
2.1 resize 方法
HashMap 的扩容通过:
resize()实现。
JDK 8 引入了红黑树:
链表节点较多
    ↓
可能树化源码理解起来会更加复杂。
先来看 JDK 7 的扩容逻辑。
JDK 7 的 resize():
/**
 * newCapacity 为新的容量
 */
void resize(
        int newCapacity) {

    // 保存旧数组
    Entry[] oldTable =
            table;

    // 旧容量
    int oldCapacity =
            oldTable.length;

    // 达到最大容量
    if (
            oldCapacity
                    == MAXIMUM_CAPACITY
    ) {

        threshold =
                Integer.MAX_VALUE;

        return;
    }

    // 创建新的大数组
    Entry[] newTable =
            new Entry[
                    newCapacity
            ];

    // 将旧数组元素转移到新数组
    transfer(
            newTable,
            initHashSeedAsNeeded(
                    newCapacity
            )
    );

    // table 指向新数组
    table =
            newTable;

    // 重新计算阈值
    threshold =
            (
                    int
            ) Math.min(
                    newCapacity
                            * loadFactor,
                    MAXIMUM_CAPACITY
                            + 1
            );
}这个方法接收:
newCapacity也就是新的容量。
首先:
oldTable
    ↓
保存旧数组


oldCapacity
    ↓
保存旧容量如果旧容量已经达到:
MAXIMUM_CAPACITY即:
2³⁰则:
threshold =
Integer.MAX_VALUE;HashMap 不再继续扩容。
接着:
Entry[] newTable =
new Entry[newCapacity];创建一个更大的新数组。
然后调用:
transfer()把旧数组中的元素转移到新数组。
转移完成以后:
table =
newTable;让 HashMap 内部的 table 指向新的数组。
最后重新计算:
threshold
扩容阈值2.2 新容量 newCapacity
那:
newCapacity是怎么计算出来的?
JDK 7 中:
int newCapacity =
        oldCapacity * 2;

if (
        newCapacity < 0
                || newCapacity
                >= MAXIMUM_CAPACITY
) {

    newCapacity =
            MAXIMUM_CAPACITY;

} else if (
        newCapacity
                < DEFAULT_INITIAL_CAPACITY
) {

    newCapacity =
            DEFAULT_INITIAL_CAPACITY;
}也就是说:
新容量
    ↓
旧容量 × 2如果超过:
MAXIMUM_CAPACITY就使用最大容量。
如果小于默认初始容量:
16则使用:
16Java 8 中,新容量的计算方式出现了一些变化:
int newCapacity =
        oldCapacity << 1;

if (
        newCapacity
                >= DEFAULT_INITIAL_CAPACITY
                && oldCapacity
                >= DEFAULT_INITIAL_CAPACITY
) {

    if (
            newCapacity
                    > MAXIMUM_CAPACITY
    ) {

        newCapacity =
                MAXIMUM_CAPACITY;
    }

} else {

    if (
            newCapacity
                    < DEFAULT_INITIAL_CAPACITY
    ) {

        newCapacity =
                DEFAULT_INITIAL_CAPACITY;
    }
}注意:
oldCapacity * 2变成了:
oldCapacity << 1这里出现:
左移
<<例如:
int a =
        39;

int b =
a << 2;十进制:
39用 8 位二进制表示:
00100111左移两位:
10011100转换回十进制:
156也就是:
39 × 4可以简单记:
左移 1 位
    ↓
约等于 ×2


左移 2 位
    ↓
约等于 ×4


左移 3 位
    ↓
约等于 ×8所以:
oldCapacity << 1表示:
容量扩大 2 倍2.3 transfer 方法
接着来看:
transfer()它负责:
把旧数组中的元素转移到新的大数组。
JDK 7:
void transfer(
        Entry[] newTable,
        boolean rehash) {

    // 新容量
    int newCapacity =
            newTable.length;

    // 遍历旧数组
    for (
            Entry<K, V> entry :
                    table
    ) {

        while (
                entry != null
        ) {

            // 保存链表中的下一个节点
            Entry<K, V> next =
                    entry.next;

            // 是否重新计算 hash
            if (rehash) {

                entry.hash =
                        (
                                entry.key
                                        == null
                        )
                                ? 0
                                : hash(
                                        entry.key
                                );
            }

            // 计算在新数组中的位置
            int index =
                    indexFor(
                            entry.hash,
                            newCapacity
                    );

            // 使用头插法
            entry.next =
                    newTable[index];

            // 放到新数组
            newTable[index] =
                    entry;

            // 继续处理链表中的下一个节点
            entry =
                    next;
        }
    }
}参数:
newTable
    ↓
新的 HashMap 数组


rehash
    ↓
是否重新计算 hash整个过程:
遍历旧数组
    ↓
遍历桶中的链表
    ↓
计算新数组下标
    ↓
把节点放到新数组其中:
entry.next =
        newTable[index];

newTable[index] =
entry;使用的是:
链表头插法2.4 拉链法
注意:
entry.next =
newTable[index];说明 JDK 7 转移链表节点时使用:
头插法也就是说:
同一个桶中新转移的节点
    ↓
放到链表头部因此原来链表中的顺序可能发生变化。
同时,扩容以后重新计算数组位置:
原来同一个桶中的节点
    ↓
可能进入新数组不同的桶Java 8 对这里进行了比较大的优化。
2.5 Java 8 扩容
JDK 8 的 resize():
final Node<K, V>[] resize() {

    Node<K, V>[] oldTab =
            table;

    int oldCap =
            (
                    oldTab == null
            )
                    ? 0
                    : oldTab.length;

    int oldThr =
            threshold;

    int newCap;
    int newThr =
            0;

    if (oldCap > 0) {

        if (
                oldCap
                        >= MAXIMUM_CAPACITY
        ) {

            threshold =
                    Integer.MAX_VALUE;

            return oldTab;

        } else if (
                (
                        newCap =
                                oldCap << 1
                ) < MAXIMUM_CAPACITY
                        && oldCap
                        >= DEFAULT_INITIAL_CAPACITY
        ) {

            newThr =
                    oldThr << 1;
        }

    } else if (
            oldThr > 0
    ) {

        newCap =
                oldThr;

    } else {

        newCap =
                DEFAULT_INITIAL_CAPACITY;

        newThr =
                (
                        int
                ) (
                        DEFAULT_LOAD_FACTOR
                                * DEFAULT_INITIAL_CAPACITY
                );
    }

    // 计算新的扩容阈值
    if (newThr == 0) {

        float ft =
                (
                        float
                ) newCap
                        * loadFactor;

        newThr =
                (
                        newCap
                                < MAXIMUM_CAPACITY
                                && ft
                                < (
                                float
                        ) MAXIMUM_CAPACITY
                )
                        ? (
                                int
                        ) ft
                        : Integer.MAX_VALUE;
    }

    threshold =
            newThr;

    @SuppressWarnings(
            {
                    "rawtypes",
                    "unchecked"
            }
    )
    Node<K, V>[] newTab =
            (
                    Node<K, V>[]
            ) new Node[newCap];

    table =
            newTab;

    if (oldTab != null) {

        for (
                int j = 0;
                j < oldCap;
                ++j
        ) {

            Node<K, V> e;

            if (
                    (
                            e = oldTab[j]
                    ) != null
            ) {

                oldTab[j] =
                        null;

                if (
                        e.next == null
                ) {

                    newTab[
                            e.hash
                                    & (
                                    newCap - 1
                            )
                    ] = e;

                } else if (
                        e
                                instanceof
                                TreeNode
                ) {

                    (
                            (
                                    TreeNode<K, V>
                            ) e
                    ).split(
                            this,
                            newTab,
                            j,
                            oldCap
                    );

                } else {

                    Node<K, V> loHead =
                            null;

                    Node<K, V> loTail =
                            null;

                    Node<K, V> hiHead =
                            null;

                    Node<K, V> hiTail =
                            null;

                    Node<K, V> next;

                    do {

                        next =
                                e.next;

                        if (
                                (
                                        e.hash
                                                & oldCap
                                ) == 0
                        ) {

                            if (
                                    loTail
                                            == null
                            ) {

                                loHead =
                                        e;

                            } else {

                                loTail.next =
                                        e;
                            }

                            loTail =
                                    e;

                        } else {

                            if (
                                    hiTail
                                            == null
                            ) {

                                hiHead =
                                        e;

                            } else {

                                hiTail.next =
                                        e;
                            }

                            hiTail =
                                    e;
                        }

                    } while (
                            (
                                    e = next
                            ) != null
                    );

                    if (
                            loTail != null
                    ) {

                        loTail.next =
                                null;

                        newTab[j] =
                                loHead;
                    }

                    if (
                            hiTail != null
                    ) {

                        hiTail.next =
                                null;

                        newTab[
                                j
                                        + oldCap
                        ] = hiHead;
                    }
                }
            }
        }
    }

    return newTab;
}整体过程:
1. 获取旧数组 table、oldCap 和 oldThr

2. 根据旧容量计算 newCap 和 newThr

3. 如果旧数组为空但 oldThr 不为 0
   将 oldThr 作为新数组容量

4. 如果旧数组和 oldThr 都为 0
   使用默认容量 16
   使用默认负载因子 0.75 计算阈值

5. 计算新的 threshold

6. 创建 newTab,并让 table 指向它

7. 遍历 oldTab,将元素转移到 newTab

8. 返回 newTabJDK 7 中定位元素的位置:
static int indexFor(
        int h,
        int length) {

    return h
            & (
                    length - 1
            );
}其实就可以理解成:
hashCode % table.length假设:
table.length = 2Key 的哈希值分别为:
3

7

5经过计算以后都发生了哈希冲突,进入:
table[1]扩容之前:
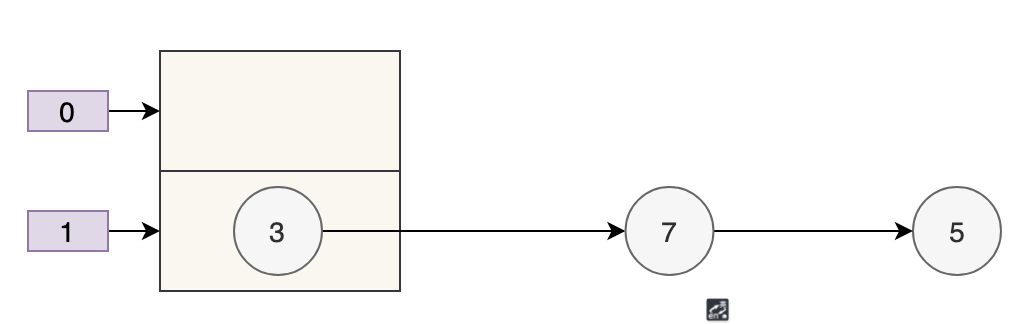
数组容量:
2Key:
3

7

5全部落在:
table[1]因此通过:
拉链法解决冲突。
假设:
loadFactor = 1也就是说,元素数量超过数组长度时发生扩容。
扩容后:
容量 2
    ↓
容量 4重新计算位置:
3 % 4
    ↓
3


7 % 4
    ↓
3


5 % 4
    ↓
1所以:
3
    ↓
table[3]


7
    ↓
table[3]


5
    ↓
table[1]示意图:
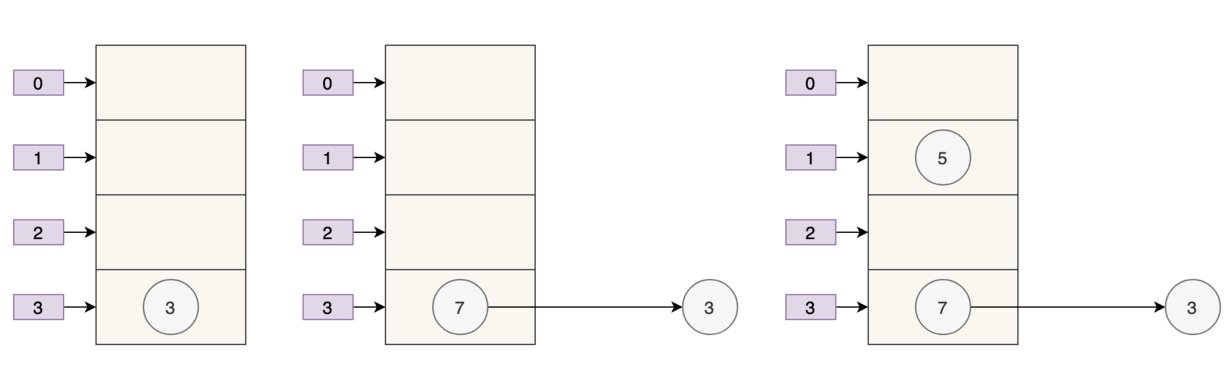
由于 JDK 7 使用:
头插法所以:
7跑到了:
3前面。
对应代码:
e.next =
newTable[i];同时:
5被重新分配到了:
index = 1JDK 8 对扩容过程进行了优化。
JDK 8 中可以简单看:
Node<K, V>[] newTab =
        new Node[
                newCapacity
        ];

for (
        int j = 0;
        j < oldTab.length;
        j++
) {

    Node<K, V> e =
            oldTab[j];

    if (e != null) {

        int hash =
                e.hash;

        int newIndex =
                hash
                        & (
                        newCapacity - 1
                );

        newTab[newIndex] =
                e;
    }
}新位置仍然根据:
hash & (newCapacity - 1)确定。
JDK 8 的 hash():
static final int hash(
        Object key) {

    int h;

    return (
            key == null
    )
            ? 0
            : (
                    h = key.hashCode()
            ) ^ (
                    h >>> 16
            );
}也就是:
32 位 hashCode
    ↓
无符号右移 16 位
    ↓
与原 hashCode 异或JDK 7 的 hash 算法:
final int hash(
        Object key) {

    int h =
            hashSeed;

    if (
            h != 0
                    && key
                    instanceof
                    String
    ) {

        return sun.misc.Hashing
                .stringHash32(
                        (
                                String
                        ) key
                );
    }

    h ^=
            key.hashCode();

    h ^=
            (
                    h >>> 20
            ) ^ (
                    h >>> 12
            );

    return h
            ^ (
                    h >>> 7
            )
            ^ (
                    h >>> 4
            );
}再来看 JDK 8 扩容后的索引规律。
假设扩容前:
数组长度 = 16则:
n - 1
    ↓
15
    ↓
0000 1111假设:
key1 = 5
    ↓
0000 0101


key2 = 21
    ↓
0001 0101扩容前:
key1 & 15
    ↓
0000 0101
    ↓
5


key2 & 15
    ↓
0000 0101
    ↓
5发生:
哈希冲突现在 HashMap 扩容:
16
    ↓
32新的:
n - 1
    ↓
31
    ↓
0001 1111重新计算:
key1
    ↓
0000 0101
&
0001 1111
    ↓
0000 0101
    ↓
5而:
key2
    ↓
0001 0101
&
0001 1111
    ↓
0001 0101
    ↓
21也就是:
21
=
5 + 16示意图:
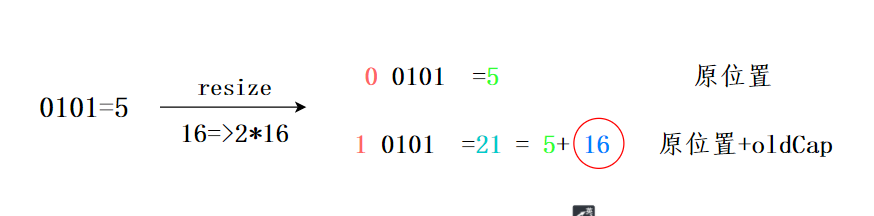
所以在 JDK 8 扩容时,元素新的位置:
要么保持原索引

要么
原索引 + 旧容量示意图:
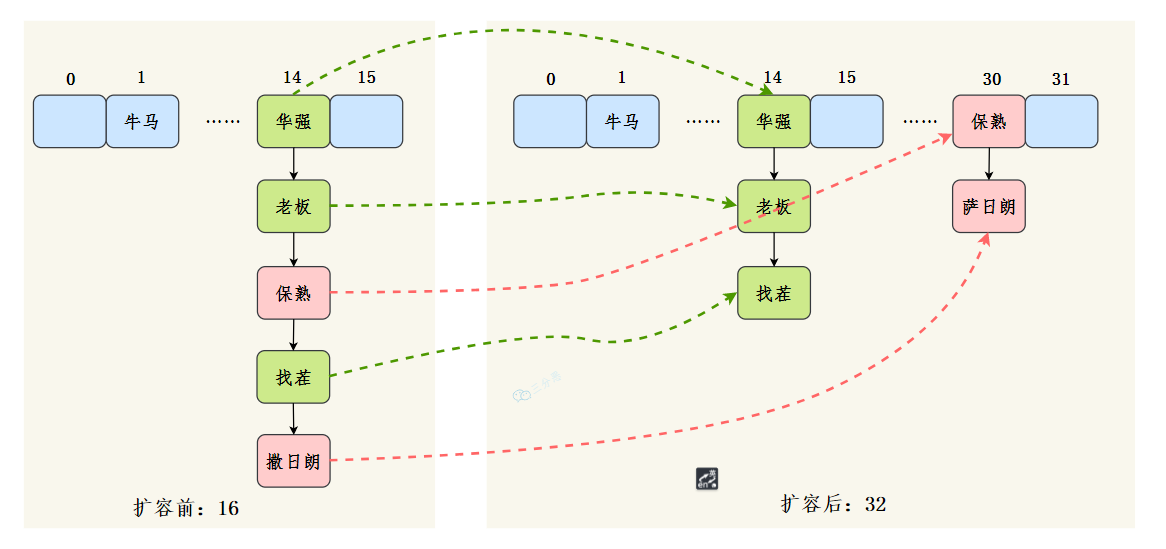
这个规律离不开:
hash 算法

数组长度始终保持 2 的幂两者共同作用。
2.6 小结
不断向 HashMap 中添加元素时:
元素数量达到扩容阈值
    ↓
触发 resize()扩容阈值和:
loadFactor有关。
扩容时:
旧数组
    ↓
容量扩大
    ↓
创建新数组
    ↓
重新分配元素HashMap 通常将容量扩展为原来的:
2 倍JDK 8 中,原桶中的节点在扩容以后:
要么保持原索引

要么移动到:
原索引 + oldCap3. 加载因子为什么是 0.75
前面扩容机制中提到了:
Load Factor
加载因子 / 负载因子那么为什么 HashMap 默认选择:
0.75而不是:
0.6

0.8?
HashMap 底层结构:
数组
+
链表 / 红黑树添加或查找元素时:
Key
    ↓
hash()
    ↓
计算数组下标先计算:
static final int hash(
        Object key) {

    int h;

    return (
            key == null
    )
            ? 0
            : (
                    h = key.hashCode()
            ) ^ (
                    h >>> 16
            );
}然后:
index =
        (
                n - 1
) & hash;这种结构需要面对两个问题:
数组容量太小
    ↓
容易产生哈希冲突


数组容量太大
    ↓
空间利用率降低加载因子就是用来表示:
HashMap 中数据的填充程度。
可以理解:
加载因子
=
哈希表中的数据数量
/
哈希表长度所以:
加载因子越小
    ↓
元素相对越少
    ↓
冲突概率降低
    ↓
但空间浪费更多
    ↓
扩容也更容易触发反过来:
加载因子越大
    ↓
数组填得更满
    ↓
空间利用率提高
    ↓
但哈希冲突概率增加因此必须在:
哈希冲突

空间利用率之间寻找平衡。
HashMap 通过:
拉链法解决哈希冲突。
为了降低冲突概率,当 HashMap 的元素数量达到一个临界值时:
触发扩容这个临界值:
临界值
=
容量 × 加载因子默认容量:
static final int
        DEFAULT_INITIAL_CAPACITY =
1 << 4;也就是:
16默认加载因子:
static final float
        DEFAULT_LOAD_FACTOR =
0.75f;所以:
16 × 0.75
=
12也就是说,当元素数量达到对应阈值时,就会触发扩容机制。
为什么选择:
0.75?
这里会涉及统计学中的:
泊松分布
Poisson Distribution泊松分布是一种常见的离散概率分布,用于描述一定时间、面积、空间等范围内随机事件发生次数的概率。
阮一峰老师曾经专门介绍过泊松分布和指数分布:
泊松分布公式:
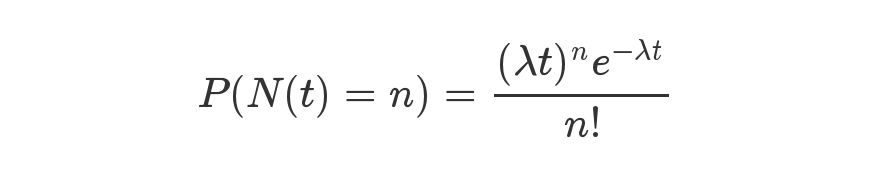
等号左侧:
P
    ↓
概率


N
    ↓
某种函数关系


t
    ↓
时间


n
    ↓
数量HashMap 的源码注释中曾有一段描述:
Because TreeNodes are about twice the size of regular nodes, we use them only when bins contain enough nodes to warrant use (see TREEIFY_THRESHOLD). And when they become too small (due to removal or resizing) they are converted back to plain bins. In usages with well-distributed user hashCodes, tree bins are rarely used. Ideally, under random hashCodes, the frequency of nodes in bins follows a Poisson distribution with a parameter of about 0.5 on average for the default resizing threshold of 0.75, although with a large variance because of resizing granularity. Ignoring variance, the expected occurrences of list size k are (exp(-0.5) * pow(0.5, k) / factorial(k)). The first values are:
text0: 0.60653066 1: 0.30326533 2: 0.07581633 3: 0.01263606 4: 0.00157952 5: 0.00015795 6: 0.00001316 7: 0.00000094 8: 0.00000006 more: less than 1 in ten million
为了理解这段话,先回顾 HashMap 的:
拉链法

红黑树Java 8 之前:
HashMap
    ↓
数组 + 链表发生哈希冲突时:
多个 Key
    ↓
进入同一个桶
    ↓
形成链表链表越来越长:
查询时需要遍历
    ↓
效率下降Java 8 中:
链表节点数量达到一定阈值
    ↓
可能转换为红黑树红黑树可以提高大量节点情况下的查询效率。
上面的源码说明大致表达的是:
TreeNode 的大小大约是普通 Node 的两倍,所以只有桶中的节点足够多时才会使用树结构。节点减少以后,还可能重新转换为普通结构。在 hashCode 分布良好的情况下,树结构很少真正出现。理想情况下,随机 hashCode 在桶中的节点数量近似符合泊松分布。
这段内容中提到了:
TREEIFY_THRESHOLD = 8

Load Factor = 0.75这里还可以结合:
二项分布
Binomial Distribution理解。
假设一次实验只有两个结果:
成功

失败类似:
抛硬币
    ↓
正面 / 反面如果进行:
N 次实验每一次:
互相独立并且成功概率相同,就可以建立相应概率模型。
对于 HashMap:
向哈希表放入数据
    ↓
没有发生哈希冲突
        ↓
成功


发生哈希冲突
        ↓
失败可以假设 hash 值是随机的。
HashMap 容量为:
16时,可以想象成:
掷一个 16 面骰子每次 put:
Key
    ↓
随机落在一个桶中如果两个结果一样:
发生冲突我们的目标就是:
连续放入若干数据
    ↓
尽可能降低冲突概率相关概率计算:
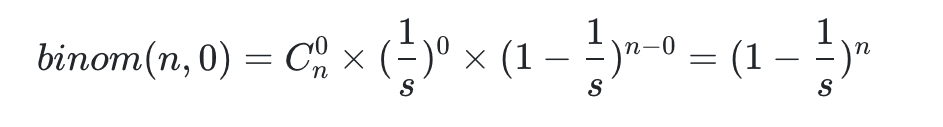
希望这个概率:
> 0.5于是:
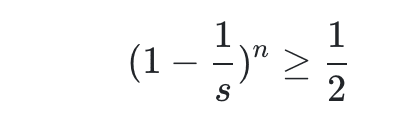
进一步希望求:
当数组长度为 s 时
    ↓
放入多少个元素 n
    ↓
应该发生扩容负载因子:
n / s继续推导:
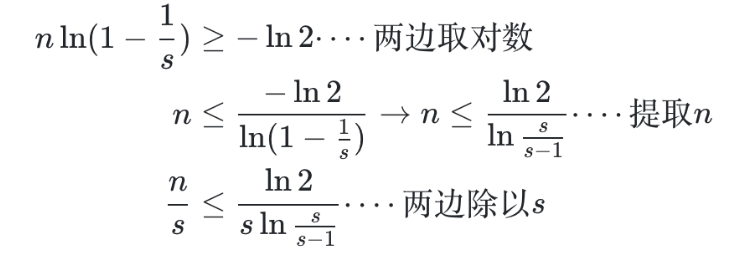
得到:
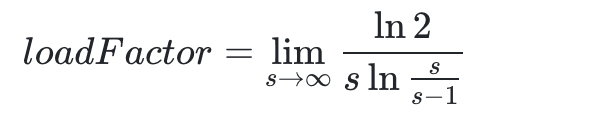
其中:
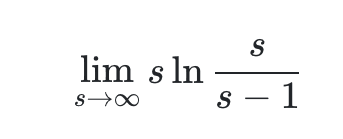
这是一个:
∞ · 0形式的函数极限问题。
令:
s = m + 1

m → ∞转化为:
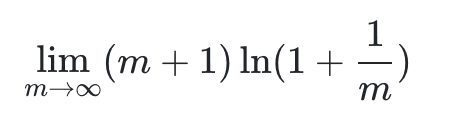
再令:
x = 1 / m

x → 0得到:
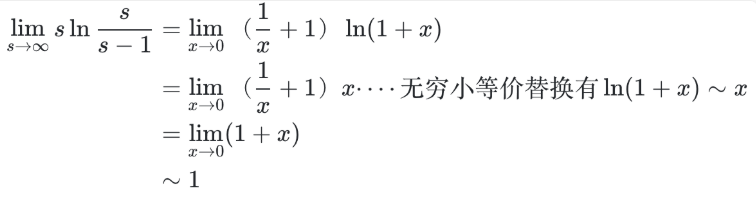
所以:
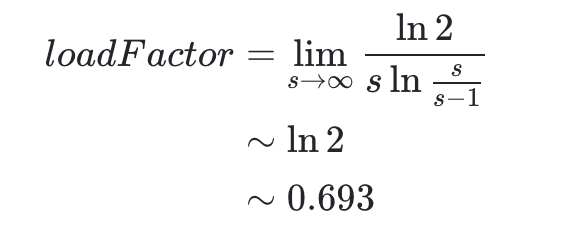
另外 HashMap 容量要求保持:
2 的 n 次幂当加载因子为:
0.75时:
容量 × 负载因子可以得到整数:
16 × 0.75 = 12

32 × 0.75 = 24在:
0.5 ~ 1之间还可以看到:
0.625
5 / 8


0.875
7 / 8从中间值的角度来看:
0.75也是一个比较合适的选择。
相关资料中也提到,拉链法的加载因子最好控制在:
0.7 ~ 0.8左右。
超过一定范围以后,查表时 CPU Cache Miss 的情况也可能明显增加。
所以:
0.75 是 HashMap 在空间利用率与哈希冲突之间选择的一个平衡值。
3.1 小结
HashMap 的加载因子:
Load Factor表示:
哈希表中元素数量
/
桶数量当元素数量达到:
容量 × Load Factor时:
触发扩容如果加载因子太大:
元素更密集
    ↓
空间利用率提高
    ↓
冲突概率提高
    ↓
查找、插入、删除效率可能下降如果加载因子太小:
桶数量相对更多
    ↓
冲突减少
    ↓
但空间利用率下降所以:
0.75是在:
时间成本

空间成本之间做出的平衡。
4. 线程不安全
HashMap 是:
线程不安全主要可以从三个方面理解:
多线程扩容可能出现问题

多线程 put 可能导致元素丢失

put 和 get 并发可能出现异常结果4.1 多线程下扩容会死循环
HashMap 通过:
拉链法解决哈希冲突。
也就是:
多个 Key
    ↓
落到同一个桶
    ↓
通过链表保存JDK 7 中:
链表采用头插法新的冲突节点会插入到旧节点之前。
扩容过程中重新转移链表节点时,多线程并发修改链表结构,就可能造成:
环形链表从而产生:
死循环4.2 多线程下 put 会导致元素丢失
正常情况下,发生哈希冲突时:
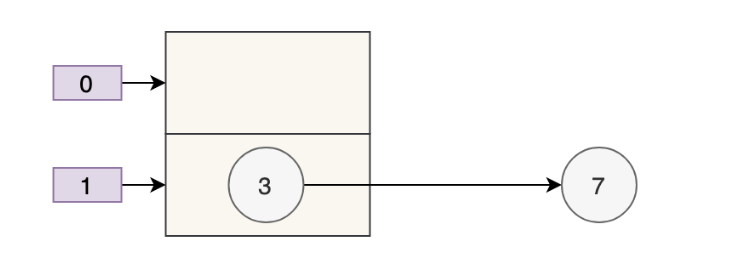
如果多个线程同时执行:
put()并且计算出的数组位置相同,就可能出现:
线程 A 准备写入节点

线程 B 同时准备写入节点

两个线程操作相同桶
    ↓
其中一次修改可能覆盖另一次修改
    ↓
导致元素丢失4.3 put 和 get 并发时会导致 get 到 null
假设:
线程 1
    ↓
执行 put
    ↓
达到扩容阈值
    ↓
触发 resize同时:
线程 2
    ↓
执行 get就有可能出现问题。
示意图:
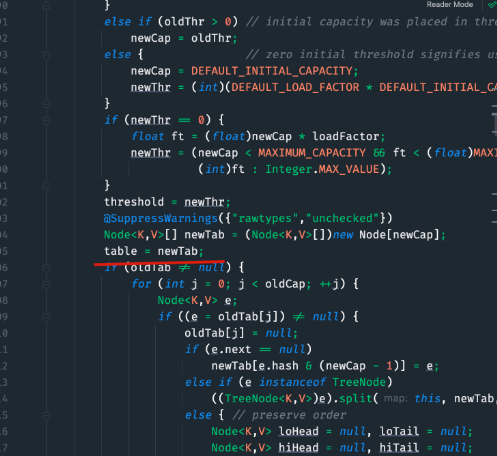
线程 1 执行:
table = newTab;以后,线程 2 看到的 table 也可能已经发生变化。
但此时:
旧元素
    ↓
还没有全部完成转移线程 2 此时执行:
get()就可能得到:
null4.4 小结
HashMap 线程不安全,主要是因为:
插入

删除

扩容都会改变内部:
数组

链表

树的结构。
如果一个线程正在操作 HashMap,而另外一个线程同时修改其内部结构:
可能造成数据丢失

可能得到错误结果

可能破坏内部结构多线程环境下,如果需要线程安全的 Map,可以使用:
ConcurrentHashMapConcurrentHashMap 的实现会在单独的:
ConcurrentHashMap.md中继续分析。
5. 小结
HashMap 是 Java 中最常用的集合之一。
它是一种:
Key → Value形式的键值存储结构,可以通过 Key 快速访问对应的 Value。
主要特点:
HashMap
    ↓
数组
+
链表 / 红黑树理想情况下:
添加

删除

查找都可以达到很高的效率。
HashMap:
线程不安全多线程场景需要考虑:
ConcurrentHashMapHashMap 的扩容机制:
元素不断增加
    ↓
达到 threshold
    ↓
resize()
    ↓
数组容量扩大
    ↓
旧元素重新分配Java 8 中:
数组

链表

红黑树共同组成了 HashMap 的主要底层结构。
HashMap 中:
Key 唯一如果重复:
put(
        相同Key,
        新Value
);后面的 Value 会覆盖前面的 Value。
HashMap 的容量和加载因子都可以设置。
默认:
初始容量
    ↓
16


加载因子
    ↓
0.75HashMap 本身:
不保证遍历顺序如果需要根据 Key 的顺序进行排序,可以使用:
TreeMap综上:
HashMap 是一种高效的键值存储结构,核心在于 hash、数组下标计算、哈希冲突处理、扩容机制以及线程安全问题。