
List
字数: 0 字 时长: 0 分钟
1. List
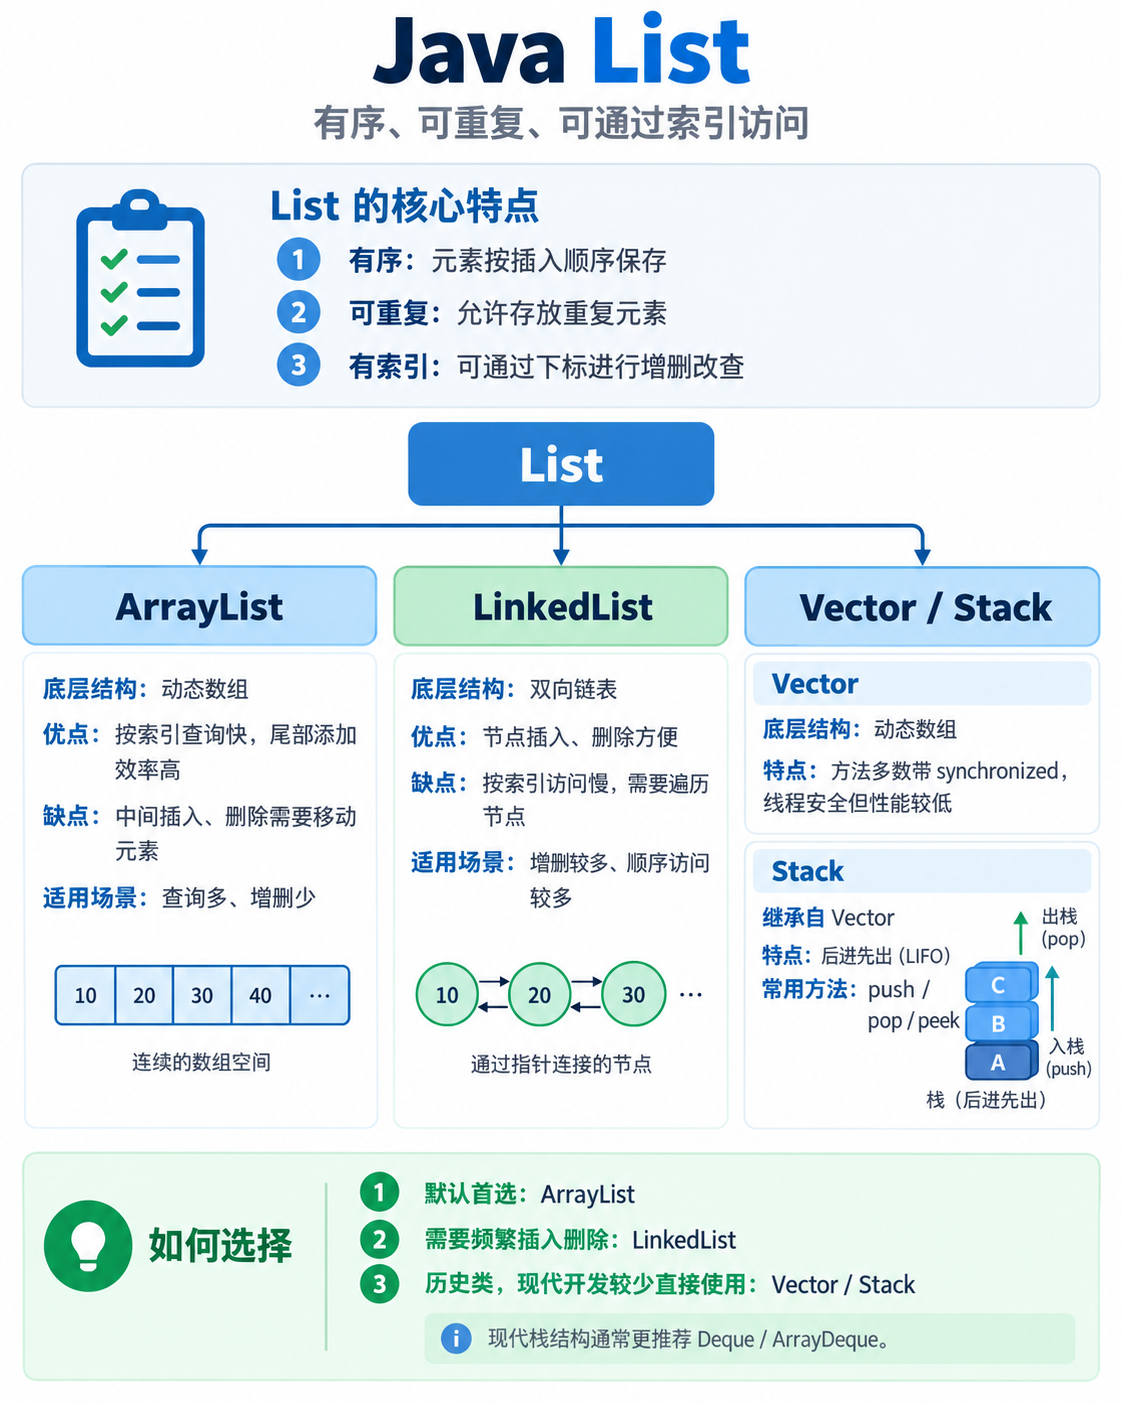
List 是 Java 集合框架中非常常用的接口。
主要特点:
- 有序:元素按照插入顺序保存。
- 可重复:允许存放相同元素。
- 有索引:可以通过下标对元素进行增删改查。
常见实现:
List
├── ArrayList
├── LinkedList
└── Vector
└── Stack1.1 ArrayList
ArrayList 是 List 最常用的实现类,底层基于动态数组实现。
基本使用:
List<String> list = new ArrayList<>();

// 添加元素
list.add("kerwim");
list.add("kevin");
list.add("牛马");

// 获取元素
String value = list.get(0);

// 修改元素
list.set(1, "小牛马");

// 删除元素
list.remove(1);

// 遍历
for (String item : list) {
    System.out.println(item);
}主要特点:
- 底层使用数组实现。
- 支持通过下标快速访问元素。
- 尾部追加元素通常比较快。
- 中间位置插入、删除时需要移动后面的元素。
- 容量不足时会自动扩容。
简单理解:
ArrayList
    ↓
动态数组
    ↓
查询快
    ↓
中间插入、删除相对慢ArrayList 的源码、扩容机制和时间复杂度在 ArrayList.md 中单独整理。
1.2 LinkedList
LinkedList 底层基于双向链表实现。
基本使用和 ArrayList 基本一致:
List<String> list = new LinkedList<>();

list.add("kerwim");
list.add("kevin");
list.add("牛马");

String value = list.get(0);

list.set(1, "小牛马");

list.remove(1);

for (String item : list) {
    System.out.println(item);
}主要特点:
- 底层使用双向链表。
- 不具备数组那样的随机访问能力。
get(index)需要查找对应节点。- 找到节点以后,插入和删除只需要修改节点之间的引用。
- 每个节点还需要保存前驱、后继引用,因此额外占用一些内存。
简单理解:
LinkedList
    ↓
双向链表
    ↓
随机访问慢
    ↓
节点定位后插入、删除方便需要注意:
LinkedList的插入删除并不是任何情况下都比ArrayList快,因为通过下标操作时,首先仍然需要遍历找到对应节点。
具体源码和节点结构在 LinkedList.md 中单独整理。
1.3 Vector 和 Stack
1.3.1 Vector
Vector 是 Java 比较早期的集合类,和 ArrayList 很相似,底层同样基于动态数组。
它最大的特点是:
很多方法使用
synchronized进行了同步。
例如:
public synchronized boolean add(E e) {
    // 添加元素
}因此:
Vector
    ↓
动态数组
    ↓
很多方法带 synchronized现代开发中,如果不需要这种同步机制,一般优先使用:
ArrayList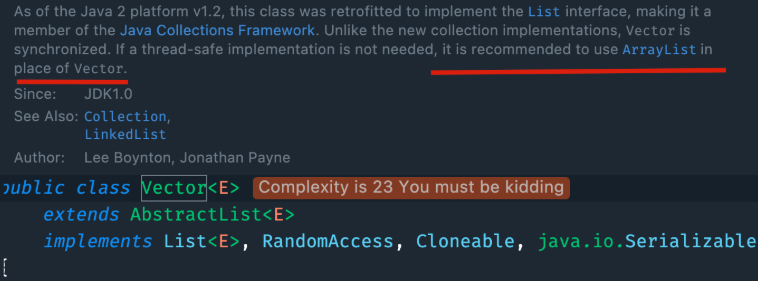
1.3.2 Stack
Stack 继承自:
Vector它提供了典型的栈操作:
push()
    ↓
压栈


pop()
    ↓
返回并删除栈顶元素


peek()
    ↓
查看栈顶元素栈遵循:
LIFO
Last In First Out
后进先出例如:
Stack<String> stack =
        new Stack<>();

stack.push("A");
stack.push("B");
stack.push("C");

System.out.println(
        stack.pop()
);输出:
C不过现代 Java 中一般不再优先使用:
Stack实现栈。
更推荐:
Deque<String> stack =
new ArrayDeque<>();所以可以简单记:
Vector
    ↓
早期线程安全动态数组


Stack
    ↓
继承 Vector 的栈实现


现代代码
    ↓
List 优先 ArrayList
栈优先 Deque + ArrayDeque2. ArrayList 和 LinkedList 的区别
前面已经分别分析过 ArrayList 和 LinkedList 的源码,这里再从:
底层实现

新增元素

删除元素

遍历元素

使用场景几个方面对两者进行一次对比。
2.1 ArrayList 是如何实现的
ArrayList 实现了 List 接口,并继承:
AbstractList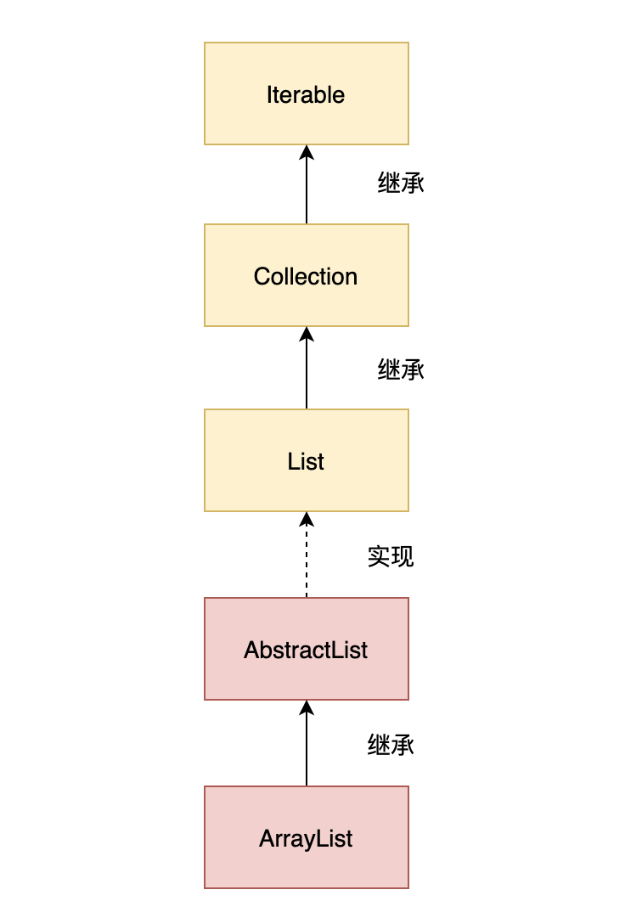
ArrayList 底层基于:
数组实现,并支持动态扩容。
部分源码:
public class ArrayList<E>
        extends AbstractList<E>
        implements List<E>,
                   RandomAccess,
                   Cloneable,
                   Serializable {

    // 默认容量
    private static final int DEFAULT_CAPACITY =
            10;

    // 保存元素的数组
    transient Object[] elementData;

    // 实际元素数量
    private int size;
}2.1.1 RandomAccess
ArrayList 还实现了:
RandomAccess它是一个标记接口:
public interface RandomAccess {
}内部没有任何方法。
它主要用于标记:
实现该接口的 List 支持快速随机访问。
所谓随机访问,就是:
通过下标
    ↓
直接访问对应位置而不需要从头开始遍历。
例如 ArrayList 的 get():
public E get(
        int index) {

    Objects.checkIndex(
            index,
            size
    );

    return elementData(
            index
    );
}真正获取元素:
E elementData(
        int index) {

    return (E) elementData[
            index
    ];
}因此:
ArrayList.get(index)
    ↓
直接访问数组下标而 LinkedList 没有实现:
RandomAccess因为它需要通过链表遍历找到指定位置。
2.1.2 Cloneable
ArrayList 还实现了:
Cloneable说明它支持:
cloneArrayList 重写了 clone():
public Object clone() {

    try {

        ArrayList<?> copy =
                (ArrayList<?>)
                        super.clone();

        copy.elementData =
                Arrays.copyOf(
                        elementData,
                        size
                );

        copy.modCount =
                0;

        return copy;

    } catch (
            CloneNotSupportedException e
    ) {

        throw new InternalError(e);
    }
}这里得到的是:
浅拷贝也就是说:
ArrayList 本身
    ↓
复制一份


内部元素对象
    ↓
不会继续深拷贝2.1.3 Serializable
ArrayList 还实现了:
Serializable同样是一个标记接口:
public interface Serializable {
}但是 ArrayList 中用于保存元素的:
elementData却使用了:
transient修饰:
transient Object[] elementData;也就是说:
elementData
    ↓
不会直接按照默认方式序列化为什么这么做?
因为 ArrayList 是动态数组。
例如当前:
size = 11数组容量扩容以后可能变成:
15那么真正保存元素的只有:
11 个位置剩余:
4 个位置实际上是空闲的。
如果直接把整个:
elementData数组序列化,就会把这些没有实际使用的空间也一起处理。
所以 ArrayList 自己实现了:
writeObject()和:
readObject()完成序列化和反序列化。
writeObject():
private void writeObject(
        ObjectOutputStream stream)
        throws IOException {

    stream.defaultWriteObject();

    // 写出 size
    stream.writeInt(
            size
    );

    // 只写出真正存在的元素
    for (
            int i = 0;
            i < size;
            i++
    ) {

        stream.writeObject(
                elementData[i]
        );
    }
}可以看到:
序列化上限
    ↓
size而不是:
elementData.length所以只会保存:
真正存在的元素反序列化:
private void readObject(
        ObjectInputStream stream)
        throws IOException,
               ClassNotFoundException {

    elementData =
            EMPTY_ELEMENTDATA;

    stream.defaultReadObject();

    stream.readInt();

    if (size > 0) {

        ensureCapacityInternal(
                size
        );

        Object[] array =
                elementData;

        for (
                int i = 0;
                i < size;
                i++
        ) {

            array[i] =
                    stream.readObject();
        }
    }
}整个过程:
读取 size
    ↓
重新分配 elementData
    ↓
逐个恢复元素2.2 LinkedList 是如何实现的
LinkedList 继承:
AbstractSequentialList底层是一个:
双向链表同时它还可以作为:
List

Queue

Deque使用。
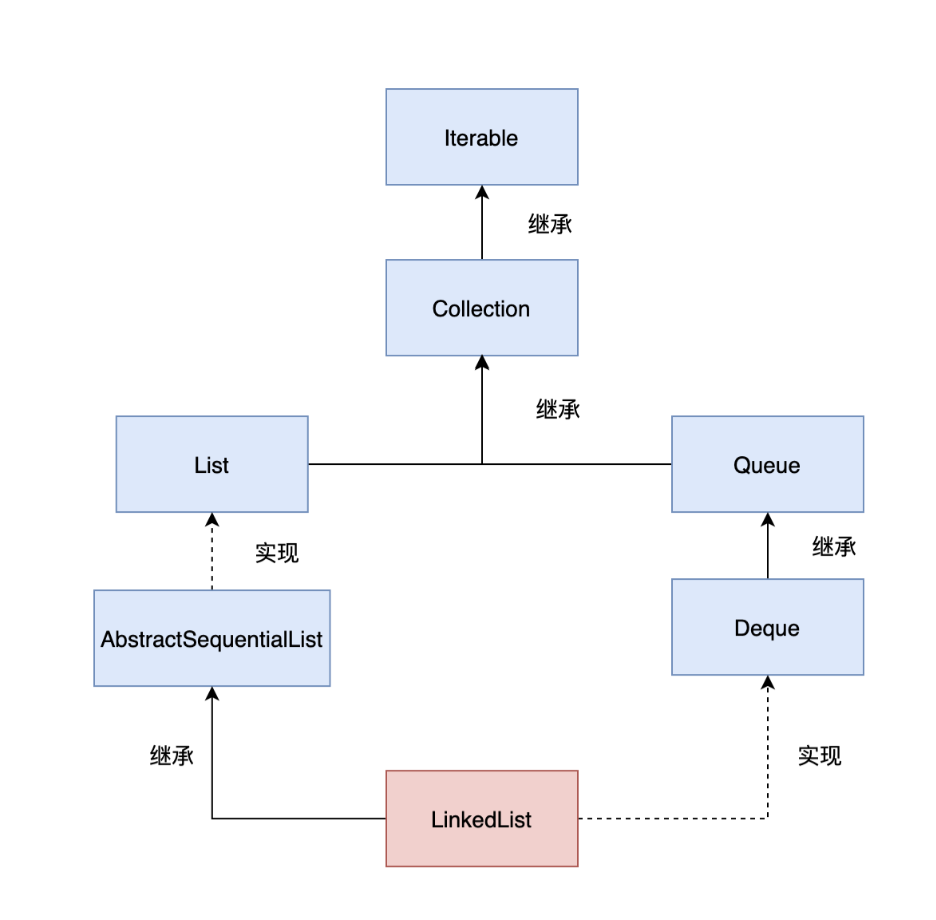
部分源码:
public class LinkedList<E>
        extends AbstractSequentialList<E>
        implements List<E>,
                   Deque<E>,
                   Cloneable,
                   Serializable {

    // 节点数量
    transient int size =
            0;

    // 头节点
    transient Node<E> first;

    // 尾节点
    transient Node<E> last;
}LinkedList 内部的节点:
Node主要包含三个部分:
item
    ↓
当前元素


prev
    ↓
前一个节点


next
    ↓
后一个节点这个结构前面在 LinkedList.md 中已经分析过。
LinkedList 同样实现了:
Cloneable说明它支持拷贝。
同时也实现了:
Serializable但是:
size

first

last这些关键字段都使用:
transient修饰。
原因和 ArrayList 类似:
LinkedList 也希望按照自己的方式完成序列化。
LinkedList 的 writeObject():
private void writeObject(
        ObjectOutputStream stream)
        throws IOException {

    stream.defaultWriteObject();

    // 写入节点数量
    stream.writeInt(
            size
    );

    // 按照链表顺序保存元素
    for (
            Node<E> node = first;
            node != null;
            node = node.next
    ) {

        stream.writeObject(
                node.item
        );
    }
}可以看到:
LinkedList 序列化
    ↓
只保存 item并不会保存:
prev

next这样的节点引用关系。
那反序列化以后,链表怎么恢复?
readObject():
private void readObject(
        ObjectInputStream stream)
        throws IOException,
               ClassNotFoundException {

    stream.defaultReadObject();

    int size =
            stream.readInt();

    for (
            int i = 0;
            i < size;
            i++
    ) {

        linkLast(
                (E) stream.readObject()
        );
    }
}其中:
linkLast()会重新创建节点并把链表连接起来:
void linkLast(
        E element) {

    Node<E> oldLast =
            last;

    Node<E> newNode =
            new Node<>(
                    oldLast,
                    element,
                    null
            );

    last =
            newNode;

    if (oldLast == null) {

        first =
                newNode;

    } else {

        oldLast.next =
                newNode;
    }

    size++;
}所以:
反序列化元素
    ↓
linkLast()
    ↓
重新创建 Node
    ↓
恢复双向链表和 ArrayList 相比:
ArrayList
    ↓
实现 RandomAccess
    ↓
支持快速随机访问


LinkedList
    ↓
没有实现 RandomAccess
    ↓
随机访问需要遍历节点2.3 新增元素时究竟谁快
ArrayList 和 LinkedList 都支持:
尾部添加

指定位置添加但实现方式完全不同。
2.3.1 ArrayList
ArrayList 在尾部添加元素:
public boolean add(
        E element) {

    add(
            element,
            elementData,
            size
    );

    return true;
}真正添加:
private void add(
        E element,
        Object[] elementData,
        int size) {

    // 数组已满则扩容
    if (
            size
                    == elementData.length
    ) {

        elementData =
                grow();
    }

    // 直接写入数组尾部
    elementData[size] =
            element;

    this.size =
            size + 1;
}整个过程:
判断是否需要扩容
    ↓
直接根据数组下标添加如果不发生扩容:
尾部追加非常直接。
指定位置插入:
public void add(
        int index,
        E element) {

    rangeCheckForAdd(
            index
    );

    int size =
            this.size;

    Object[] elementData =
            this.elementData;

    if (
            size
                    == elementData.length
    ) {

        elementData =
                grow();
    }

    // index 后面的元素整体向后移动
    System.arraycopy(
            elementData,
            index,
            elementData,
            index + 1,
            size - index
    );

    elementData[index] =
            element;

    this.size =
            size + 1;
}整个过程:
检查 index
    ↓
判断是否扩容
    ↓
index 后面的元素整体右移
    ↓
写入新元素所以 ArrayList 在:
中间位置插入时,需要进行数组复制。
2.3.2 LinkedList
LinkedList 尾部添加:
public boolean add(
        E element) {

    linkLast(
            element
    );

    return true;
}真正添加:
void linkLast(
        E element) {

    Node<E> oldLast =
            last;

    Node<E> newNode =
            new Node<>(
                    oldLast,
                    element,
                    null
            );

    last =
            newNode;

    if (oldLast == null) {

        first =
                newNode;

    } else {

        oldLast.next =
                newNode;
    }

    size++;
}过程:
获取 last
    ↓
创建新 Node
    ↓
更新 last
    ↓
重新连接前后节点指定位置插入:
public void add(
        int index,
        E element) {

    checkPositionIndex(
            index
    );

    if (index == size) {

        linkLast(
                element
        );

    } else {

        linkBefore(
                element,
                node(index)
        );
    }
}如果不是插在尾部,需要先执行:
node(index)找到指定位置的节点:
Node<E> node(
        int index) {

    if (
            index
                    < (
                    size >> 1
            )
    ) {

        Node<E> node =
                first;

        for (
                int i = 0;
                i < index;
                i++
        ) {

            node =
                    node.next;
        }

        return node;

    } else {

        Node<E> node =
                last;

        for (
                int i = size - 1;
                i > index;
                i--
        ) {

            node =
                    node.prev;
        }

        return node;
    }
}如果位置在前半段:
从 first 往后找如果位置在后半段:
从 last 往前找找到节点以后,再执行:
linkBefore()void linkBefore(
E element,
Node<E> successor) {
Node<E> predecessor =
successor.prev;
Node<E> newNode =
new Node<>(
predecessor,
element,
successor
);
successor.prev =
newNode;
if (predecessor == null) {
first =
newNode;
} else {
predecessor.next =
newNode;
}
size++;
}真正修改链表节点关系并不复杂。
问题在于:
按照 index 插入
    ↓
必须先 node(index)
    ↓
找到对应节点如果位置越靠近:
链表中间遍历节点需要的时间就越多。
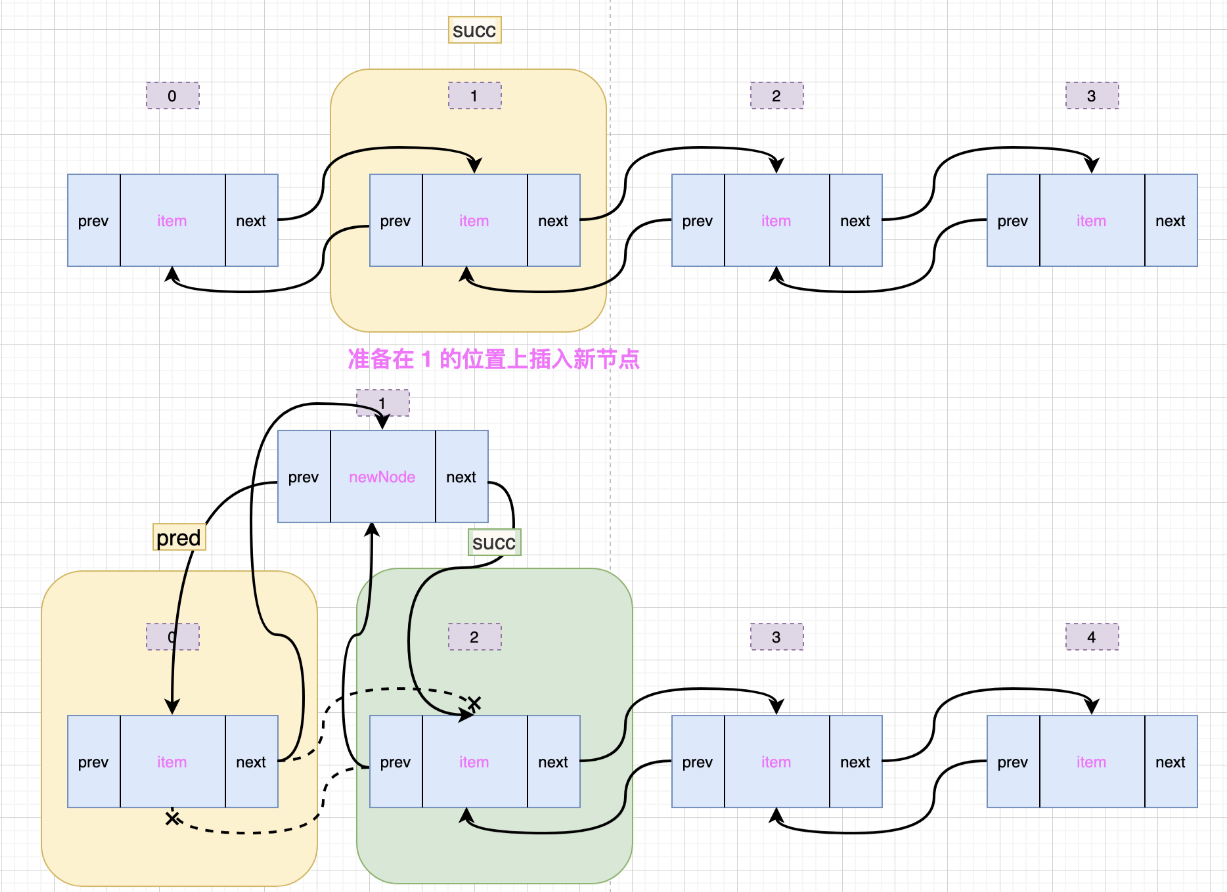
所以:
不能简单认为 LinkedList 新增元素一定比 ArrayList 快。
例如从集合中间不断新增元素:
public class ArrayListTest {

    public static void addFromMidTest(
            int num) {

        ArrayList<String> list =
                new ArrayList<>(
                        num
                );

        int i =
                0;

        long start =
                System.currentTimeMillis();

        while (i < num) {

            int size =
                    list.size();

            list.add(
                    size / 2,
                    i + "周芷若"
            );

            i++;
        }

        long end =
                System.currentTimeMillis();

        System.out.println(
                "ArrayList从集合中间位置新增元素花费的时间"
                        + (
                        end - start
                )
        );
    }
}LinkedList:
public class LinkedListTest {

    public static void addFromMidTest(
            int num) {

        LinkedList<String> list =
                new LinkedList<>();

        int i =
                0;

        long start =
                System.currentTimeMillis();

        while (i < num) {

            int size =
                    list.size();

            list.add(
                    size / 2,
                    i + "周芷若"
            );

            i++;
        }

        long end =
                System.currentTimeMillis();

        System.out.println(
                "LinkedList从集合中间位置新增元素花费的时间"
                        + (
                        end - start
                )
        );
    }
}原测试中:
num = 10000结果:
ArrayList从集合中间位置新增元素花费的时间16

LinkedList从集合中间位置新增元素花费的时间114可以看到,这次测试中:
ArrayList反而更快。
如果从集合头部新增元素:
ArrayList
    ↓
后面的元素需要整体移动


LinkedList
    ↓
直接调整头节点关系ArrayList 的代价通常更大。
再测试尾部添加。
ArrayList:
public static void addFromTailTest(
        int num) {

    ArrayList<String> list =
            new ArrayList<>(
                    num
            );

    int i =
            0;

    long start =
            System.currentTimeMillis();

    while (i < num) {

        list.add(
                i + "灭绝师太"
        );

        i++;
    }

    long end =
            System.currentTimeMillis();

    System.out.println(
            "ArrayList从集合尾部位置新增元素花费的时间"
                    + (
                    end - start
            )
    );
}LinkedList:
public static void addFromTailTest(
        int num) {

    LinkedList<String> list =
            new LinkedList<>();

    int i =
            0;

    long start =
            System.currentTimeMillis();

    while (i < num) {

        list.add(
                i + "灭绝师太"
        );

        i++;
    }

    long end =
            System.currentTimeMillis();

    System.out.println(
            "LinkedList从集合尾部位置新增元素花费的时间"
                    + (
                    end - start
            )
    );
}原测试结果:
ArrayList从集合尾部位置新增元素花费的时间69

LinkedList从集合尾部位置新增元素花费的时间193在这个测试中:
ArrayList同样更快。
因此,新增元素时不能只看:
数组移动

链表修改引用还需要考虑:
LinkedList 查找节点

Node 对象创建

ArrayList 是否扩容等因素。
2.4 删除元素时究竟谁快
2.4.1 ArrayList
ArrayList 删除元素主要有:
remove(Object)和:
remove(int)两种方式。
remove(Object):
public boolean remove(
        Object object) {

    Object[] elements =
            elementData;

    int size =
            this.size;

    int index =
            0;

    found: {

        if (object == null) {

            for (
                    ;
                    index < size;
                    index++
            ) {

                if (
                        elements[index]
                                == null
                ) {

                    break found;
                }
            }

        } else {

            for (
                    ;
                    index < size;
                    index++
            ) {

                if (
                        object.equals(
                                elements[index]
                        )
                ) {

                    break found;
                }
            }
        }

        return false;
    }

    fastRemove(
            elements,
            index
    );

    return true;
}remove(int):
public E remove(
        int index) {

    Objects.checkIndex(
            index,
            size
    );

    Object[] elements =
            elementData;

    E oldValue =
            (E) elements[index];

    fastRemove(
            elements,
            index
    );

    return oldValue;
}两个方法最后都会调用:
fastRemove()private void fastRemove(
Object[] elements,
int index) {
int newSize;
if (
(
newSize =
size - 1
) > index
) {
System.arraycopy(
elements,
index + 1,
elements,
index,
newSize - index
);
}
elements[
size = newSize
] = null;
}只要删除的不是最后一个元素:
删除位置后面的元素
    ↓
整体向前移动所以:
删除位置越靠前
    ↓
移动元素越多2.4.2 LinkedList
LinkedList 删除指定位置:
public E remove(
        int index) {

    checkElementIndex(
            index
    );

    return unlink(
            node(index)
    );
}首先:
node(index)
    ↓
找到节点然后:
unlink()
    ↓
解除节点连接源码:
E unlink(
        Node<E> node) {

    E element =
            node.item;

    Node<E> next =
            node.next;

    Node<E> prev =
            node.prev;

    if (prev == null) {

        first =
                next;

    } else {

        prev.next =
                next;

        node.prev =
                null;
    }

    if (next == null) {

        last =
                prev;

    } else {

        next.prev =
                prev;

        node.next =
                null;
    }

    node.item =
            null;

    size--;

    return element;
}直接按元素删除:
public boolean remove(
        Object object) {

    if (object == null) {

        for (
                Node<E> node = first;
                node != null;
                node = node.next
        ) {

            if (node.item == null) {

                unlink(
                        node
                );

                return true;
            }
        }

    } else {

        for (
                Node<E> node = first;
                node != null;
                node = node.next
        ) {

            if (
                    object.equals(
                            node.item
                    )
            ) {

                unlink(
                        node
                );

                return true;
            }
        }
    }

    return false;
}同样需要:
先查找节点
    ↓
再 unlink()删除第一个节点:
public E removeFirst() {

    Node<E> first =
            this.first;

    if (first == null) {

        throw new NoSuchElementException();
    }

    return unlinkFirst(
            first
    );
}真正删除:
private E unlinkFirst(
        Node<E> first) {

    E element =
            first.item;

    Node<E> next =
            first.next;

    first.item =
            null;

    first.next =
            null;

    this.first =
            next;

    if (next == null) {

        last =
                null;

    } else {

        next.prev =
                null;
    }

    size--;

    return element;
}删除第一个节点:
不需要遍历删除最后一个节点也是类似:
直接根据 last 操作所以 LinkedList 删除:
头部

尾部元素时非常方便。
但如果通过:
index删除中间元素:
node(index)本身仍然需要进行遍历。
原测试结果:
ArrayList从集合头部位置删除元素花费的时间380
LinkedList从集合头部位置删除元素花费的时间4

ArrayList从集合中间位置删除元素花费的时间381
LinkedList从集合中间位置删除元素花费的时间5922

ArrayList从集合尾部位置删除元素花费的时间8
LinkedList从集合尾部位置删除元素花费的时间12可以看到,在这组测试中:
头部删除
    ↓
LinkedList 更快


中间删除
    ↓
ArrayList 更快


尾部删除
    ↓
两者差距不大2.5 遍历元素时究竟谁快
2.5.1 ArrayList
ArrayList 查找元素通常有两种方式。
根据索引获取:
get(int index)源码:
public E get(
        int index) {

    Objects.checkIndex(
            index,
            size
    );

    return elementData(
            index
    );
}由于底层是数组:
index
    ↓
直接访问数组位置所以随机访问速度很快。
另一种:
indexOf(Object)根据元素查找索引:
public int indexOf(
        Object object) {

    return indexOfRange(
            object,
            0,
            size
    );
}真正查找:
int indexOfRange(
        Object object,
        int start,
        int end) {

    Object[] elements =
            elementData;

    if (object == null) {

        for (
                int i = start;
                i < end;
                i++
        ) {

            if (
                    elements[i]
                            == null
            ) {

                return i;
            }
        }

    } else {

        for (
                int i = start;
                i < end;
                i++
        ) {

            if (
                    object.equals(
                            elements[i]
                    )
            ) {

                return i;
            }
        }
    }

    return -1;
}因此:
get(index)
    ↓
直接访问


indexOf(object)
    ↓
需要遍历2.5.2 LinkedList
LinkedList 的:
get(int)源码:
public E get(
        int index) {

    checkElementIndex(
            index
    );

    return node(index).item;
}核心还是:
node(index)因此需要根据位置:
从 first 往后找

或者

从 last 往前找LinkedList 的:
indexOf(Object)同样需要遍历:
public int indexOf(
        Object object) {

    int index =
            0;

    if (object == null) {

        for (
                Node<E> node = first;
                node != null;
                node = node.next
        ) {

            if (node.item == null) {

                return index;
            }

            index++;
        }

    } else {

        for (
                Node<E> node = first;
                node != null;
                node = node.next
        ) {

            if (
                    object.equals(
                            node.item
                    )
            ) {

                return index;
            }

            index++;
        }
    }

    return -1;
}所以:
ArrayList.indexOf()
    ↓
遍历数组


LinkedList.indexOf()
    ↓
遍历链表两者本质都需要线性查找。
2.5.3 for 循环和 Iterator
遍历集合通常有:
普通 for 循环

Iterator两种方式。
如果使用这种方式遍历 LinkedList:
for (
        int i = 0;
        i < list.size();
        i++
) {

    list.get(i);
}每次:
get(i)都会再次执行:
node(i)例如:
Node<E> node(
        int index) {

    if (
            index
                    < (
                    size >> 1
            )
    ) {

        Node<E> node =
                first;

        for (
                int i = 0;
                i < index;
                i++
        ) {

            node =
                    node.next;
        }

        return node;

    } else {

        Node<E> node =
                last;

        for (
                int i = size - 1;
                i > index;
                i--
        ) {

            node =
                    node.prev;
        }

        return node;
    }
}也就是说:
外层 for
    ↓
不断 get(index)
    ↓
每次重新遍历链表性能会非常差。
如果使用 Iterator:
LinkedList<String> list =
        new LinkedList<>();

for (
        Iterator<String> iterator =
                list.iterator();
        iterator.hasNext();
) {

    iterator.next();
}迭代器会沿着节点:
next依次向后遍历,而不是每次重新从:
first

或者

last查找。
调用过程:
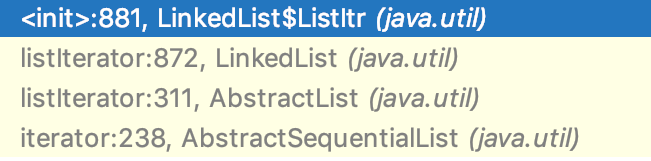
LinkedList 最终会创建:
ListItrpublic ListIterator<E> listIterator(
int index) {
checkPositionIndex(
index
);
return new ListItr(
index
);
}内部迭代器:
private class ListItr
        implements ListIterator<E> {

    private Node<E> lastReturned;

    private Node<E> next;

    private int nextIndex;

    private int expectedModCount =
            modCount;

    ListItr(
            int index) {

        next =
                (
                        index == size
                )
                        ? null
                        : node(index);

        nextIndex =
                index;
    }

    public boolean hasNext() {

        return nextIndex
                < size;
    }

    public E next() {

        checkForComodification();

        if (!hasNext()) {

            throw new NoSuchElementException();
        }

        lastReturned =
                next;

        next =
                next.next;

        nextIndex++;

        return lastReturned.item;
    }
}初始化以后:
next
    ↓
当前节点每次执行:
next()只需要:
next = next.next继续向后移动。
所以对于 LinkedList:
不要使用
for + get(index)的方式进行遍历,更适合使用 Iterator 或 foreach。
原笔记中的结论:
普通索引 for 循环
    ↓
ArrayList 明显更适合


Iterator 遍历
    ↓
两者差距会明显缩小2.6 两者的使用场景
ArrayList 和 LinkedList 的底层结构不同:
ArrayList
    ↓
动态数组


LinkedList
    ↓
双向链表因此使用场景也有所区别。
2.6.1 ArrayList
当需要频繁:
随机访问元素

根据索引读取

遍历大量数据

排序

查找时,可以优先考虑:
ArrayList例如学生管理系统中:
学生列表
    ↓
排序

查找

快速访问指定位置就比较适合使用 ArrayList。
2.6.2 LinkedList
当需要频繁操作:
链表两端

插入节点

删除节点

队列

双端队列时,可以考虑:
LinkedList例如:
消息队列可以使用 LinkedList 保存消息并进行头尾操作。
2.6.3 对比总结
| 对比项 | ArrayList | LinkedList |
|---|---|---|
| 底层结构 | 动态数组 | 双向链表 |
RandomAccess | 支持 | 不支持 |
get(index) | 快 | 需要遍历 |
| 尾部追加 | 快,扩容时需要复制数组 | 快,需要创建 Node |
| 头部插入 | 需要移动大量元素 | 修改头节点关系 |
| 中间插入 | 需要移动数组元素 | 先遍历找到节点,再修改链接 |
| 头部删除 | 需要移动大量元素 | 快 |
| 中间删除 | 需要移动数组元素 | 先查找节点,再解除链接 |
| 尾部删除 | 快 | 快 |
| 索引 for 遍历 | 适合 | 不适合 |
| Iterator 遍历 | 适合 | 适合 |
不能简单记成:
ArrayList
    ↓
查询快、增删慢


LinkedList
    ↓
查询慢、增删快因为实际性能还和:
操作位置

是否需要查找节点

是否发生数组扩容

遍历方式有关。
更准确地理解:
ArrayList
    ↓
擅长随机访问
    ↓
大多数常规 List 场景都比较合适


LinkedList
    ↓
擅长已知节点后的链接操作
以及链表两端操作