
Collection
字数: 0 字 时长: 0 分钟
1. Collection 体系
Collection 是 Java 集合框架中最核心的接口之一。
它主要用来表示:
一组对象的集合整体体系可以简单理解成:
Iterable
    ↑
Collection
    ├── List
    │   ├── ArrayList
    │   ├── LinkedList
    │   └── Vector
    │       └── Stack
    │
    ├── Set
    │   ├── HashSet
    │   ├── LinkedHashSet
    │   └── TreeSet
    │
    └── Queue
        ├── PriorityQueue
        └── Deque
            ├── ArrayDeque
└── LinkedList需要注意:
Map虽然也属于 Java 集合框架的一部分,但:
Map 并没有继承 Collection。
所以整体上可以看成两套体系:
Java 集合框架

├── Collection
│   ├── List
│   ├── Set
│   └── Queue
│
└── Map
    ├── HashMap
    ├── LinkedHashMap
    ├── TreeMap
└── ConcurrentHashMap1.1 List
List 的特点:
元素有顺序

允许重复元素

可以通过索引访问常见实现:
ArrayList

LinkedList

Vector例如:
List<String> list =
        new ArrayList<>();

list.add(
        "张无忌"
);

list.add(
        "赵敏"
);

list.add(
        "张无忌"
);结果中:
"张无忌"可以出现多次。
1.2 Set
Set 的主要特点:
元素不能重复常见实现:
HashSet

LinkedHashSet

TreeSet例如:
Set<String> set =
        new HashSet<>();

set.add(
        "张无忌"
);

set.add(
        "赵敏"
);

set.add(
        "张无忌"
);第二次添加:
张无忌不会产生新的重复元素。
不同 Set 对顺序的处理也不同:
HashSet
    ↓
不保证遍历顺序


LinkedHashSet
    ↓
维护插入顺序


TreeSet
    ↓
按照排序规则排列1.3 Queue
Queue 表示:
队列通常用于按照一定规则处理元素。
普通队列一般遵循:
FIFO
先进先出常见实现:
PriorityQueue

LinkedList

ArrayDeque例如:
Queue<String> queue =
        new ArrayDeque<>();

queue.offer(
        "张无忌"
);

queue.offer(
        "赵敏"
);

queue.offer(
        "周芷若"
);普通队列可以理解成:
队尾加入
    ↓
队首取出1.4 Deque
Deque:
Double Ended Queue
双端队列它继承:
Queue支持从:
队首

队尾两端操作元素。
所以既可以作为:
队列也可以作为:
栈使用。
常见实现:
ArrayDeque

LinkedList例如:
Deque<String> deque =
new ArrayDeque<>();作为队列:
deque.offerLast(
        "张无忌"
);

deque.pollFirst();作为栈:
deque.push(
        "张无忌"
);

deque.pop();2. Collection 公共方法
List、Set、Queue 都继承了:
Collection所以它们拥有一组公共方法。
Collection 接口常见方法可以分成:
添加

删除

查询

数量

批量操作

转换数组2.1 add()
向集合中添加一个元素:
boolean add(E e);例如:
List<String> list =
        new ArrayList<>();

list.add(
        "张无忌"
);通常:
添加成功
    ↓
true具体行为由不同集合实现决定。
例如:
List
    ↓
允许重复


Set
    ↓
不允许重复所以:
Set<String> set =
        new HashSet<>();

set.add(
        "张无忌"
);

boolean result =
        set.add(
                "张无忌"
);第二次添加:
result = false2.2 remove()
删除集合中的指定元素:
boolean remove(Object o);例如:
list.remove(
        "张无忌"
);如果成功删除:
true如果集合中不存在:
false2.3 contains()
判断集合中是否包含某个元素:
boolean contains(Object o);例如:
boolean result =
        list.contains(
                "赵敏"
);结果:
存在
    ↓
true


不存在
    ↓
false具体如何判断元素相同,和集合的实现有关。
例如 HashSet 会依赖:
hashCode()

equals()2.4 size()
获取集合中的元素数量:
int size();例如:
int size =
list.size();注意:
size表示:
当前实际元素数量并不是底层数组的:
容量例如 ArrayList:
size
    ↓
实际保存多少个元素


elementData.length
    ↓
底层数组容量两者不是一个概念。
2.5 isEmpty()
判断集合是否为空:
boolean isEmpty();例如:
if (
        list.isEmpty()
) {

    System.out.println(
            "集合为空"
    );
}本质上就是判断:
size == 02.6 clear()
清空集合:
void clear();例如:
list.clear();执行之后:
size = 0集合中的元素全部被移除。
2.7 addAll()
将另一个集合中的元素全部添加进来:
boolean addAll(
        Collection<? extends E> c
);例如:
List<String> list1 =
        new ArrayList<>();

list1.add(
        "张无忌"
);

List<String> list2 =
        new ArrayList<>();

list2.add(
        "赵敏"
);

list2.add(
        "周芷若"
);

list1.addAll(
        list2
);结果:
list1

[张无忌, 赵敏, 周芷若]2.8 containsAll()
判断当前集合是否包含另一个集合中的:
所有元素方法:
boolean containsAll(
        Collection<?> c
);例如:
boolean result =
        list1.containsAll(
                list2
);只有当:
list2 中的所有元素都存在于:
list1中时才返回:
true2.9 removeAll()
删除两个集合中都存在的元素:
boolean removeAll(
        Collection<?> c
);例如:
List<String> list1 =
        new ArrayList<>();

list1.add(
        "张无忌"
);

list1.add(
        "赵敏"
);

list1.add(
        "周芷若"
);

List<String> list2 =
        new ArrayList<>();

list2.add(
        "赵敏"
);

list2.add(
        "周芷若"
);

list1.removeAll(
        list2
);结果:
[张无忌]可以理解成:
当前集合
    ↓
减去另一个集合中的元素2.10 retainAll()
只保留两个集合中:
共同存在的元素方法:
boolean retainAll(
        Collection<?> c
);例如:
list1.retainAll(
        list2
);可以理解成:
取交集例如:
list1
    ↓
[张无忌, 赵敏, 周芷若]


list2
    ↓
[赵敏, 周芷若]执行:
list1.retainAll(
        list2
);结果:
[赵敏, 周芷若]2.11 toArray()
将 Collection 转换成数组:
Object[] toArray();例如:
Object[] array =
list.toArray();也可以指定数组类型:
String[] array =
        list.toArray(
                new String[0]
);转换关系:
Collection
    ↓
Array3. 常用方法总结
| 方法 | 作用 |
|---|---|
add(E e) | 添加元素 |
remove(Object o) | 删除指定元素 |
contains(Object o) | 判断元素是否存在 |
size() | 获取元素数量 |
isEmpty() | 判断集合是否为空 |
clear() | 清空集合 |
addAll(Collection c) | 批量添加 |
containsAll(Collection c) | 判断是否包含另一集合全部元素 |
removeAll(Collection c) | 删除两个集合共有的元素 |
retainAll(Collection c) | 只保留两个集合共有的元素 |
toArray() | 转换成数组 |
整体可以记成:
Collection
    ↓
集合体系的核心接口

├── List
│   └── 有序、可重复
│
├── Set
│   └── 不允许重复
│
└── Queue
└── 队列结构而:
Map属于 Java 集合框架,但:
不继承 Collection4. Iterator 和 Iterable 的区别
在 Java 中,对 List 进行遍历时,常见的方式主要有三种。
4.1 三种遍历方式
第一种:普通 for 循环。
for (int i = 0; i < list.size(); i++) {
    System.out.print(
            list.get(i)
                    + ","
    );
}第二种:使用 Iterator。
Iterator<String> iterator =
        list.iterator();

while (
        iterator.hasNext()
) {

    System.out.print(
            iterator.next()
                    + ","
    );
}第三种:使用 for-each。
for (
        String str : list
) {

    System.out.print(
            str
                    + ","
    );
}第一种普通 for 循环比较容易理解。
第二种使用的是:
Iterator第三种虽然写的是:
for-each但对于 Iterable 对象来说,底层同样会通过:
Iterator完成遍历。
例如:
for (
        String str : list
) {

    System.out.print(
            str
                    + ","
    );
}编译以后,大致可以理解成:
Iterator<String> iterator =
        list.iterator();

while (
        iterator.hasNext()
) {

    String str =
            iterator.next();

    System.out.print(
            str
                    + ","
    );
}所以:
for-each 本质上是一种语法糖,让我们在遍历集合时可以写更少、更清晰的代码。
整体关系:
for-each
    ↓
iterator()
    ↓
Iterator
    ↓
hasNext()
    ↓
next()4.2 Iterator
Iterator 是一个接口。
JDK 1.2 时引入,用来改进早期的:
Enumeration相比 Enumeration:
Iterator
    ↓
方法命名更加简洁

并支持 remove()Enumeration 中常见的方法:
hasMoreElements()

nextElement()Iterator 则变成:
hasNext()

next()Iterator 的核心定义:
public interface Iterator<E> {

    /**
     * 是否还有下一个元素
     */
    boolean hasNext();

    /**
     * 返回下一个元素
     */
    E next();

    /**
     * 删除最近一次 next() 返回的元素
     */
    default void remove() {

        throw new UnsupportedOperationException(
                "remove"
        );
    }
}三个核心方法:
hasNext()
    ↓
判断是否还有下一个元素


next()
    ↓
返回下一个元素
并让迭代位置向后移动


remove()
    ↓
删除最近一次 next() 返回的元素其中:
remove()是可选操作。
如果某个迭代器不支持删除,就可能抛出:
UnsupportedOperationException4.3 Iterable
如果仔细观察:
ArrayList

LinkedList的继承关系,会发现它们并没有直接实现:
Iterator反而会看到:
Iterable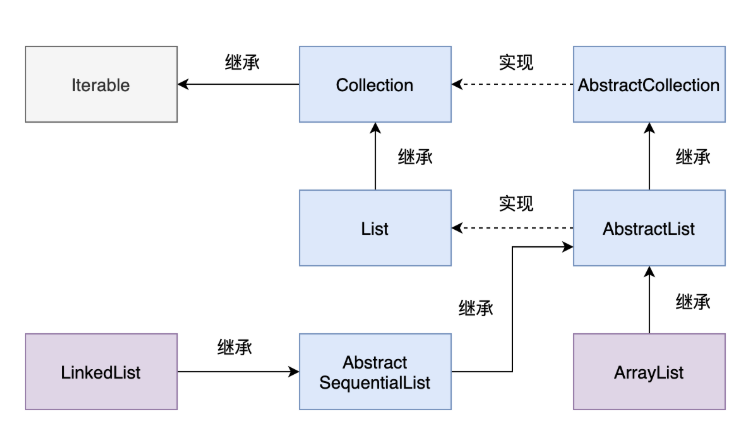
Iterable 的核心定义:
public interface Iterable<T> {

    Iterator<T> iterator();
}也就是说:
Iterable 表示一个对象具备“可迭代”的能力,而 Iterator 才是真正负责“如何迭代”的对象。
关系可以理解成:
Iterable
    ↓
我支持迭代


iterator()
    ↓
给你一个 Iterator


Iterator
    ↓
具体告诉你怎么遍历Collection 本身继承了:
Iterable所以:
List

Set

Queue这些 Collection 体系下的集合,都具备迭代能力。
关系:
Iterable
    ↑
Collection
    ├── List
    ├── Set
└── Queue4.3.1 为什么需要 Iterable
回头看 Iterator 的使用方式:
Iterator<String> iterator =
        list.iterator();

while (
        iterator.hasNext()
) {

    System.out.println(
            iterator.next()
    );
}这里:
list.iterator()正好对应 Iterable 中定义的:
Iterator<T> iterator();以 ArrayList 为例,它提供:
public Iterator<E> iterator() {

    return new Itr();
}也就是说:
ArrayList
    ↓
iterator()
    ↓
创建 Itr
    ↓
返回 Iterator其中:
Itr是 ArrayList 的内部类,并实现:
Iterator4.3.2 ArrayList 的 Itr
ArrayList 内部定义了自己的迭代器:
private class Itr
        implements Iterator<E> {

    // 下一个元素的索引
    int cursor;

    // 最近一次返回元素的索引
    int lastRet =
            -1;

    // 预期的结构修改次数
    int expectedModCount =
            modCount;

    /**
     * 是否存在下一个元素
     */
    public boolean hasNext() {

        return cursor
                != size;
    }

    /**
     * 获取下一个元素
     */
    @SuppressWarnings("unchecked")
    public E next() {

        Object[] elementData =
                ArrayList.this.elementData;

        int index =
                cursor;

        if (
                index >= size
        ) {

            throw new NoSuchElementException();
        }

        // 游标向后移动
        cursor =
                index + 1;

        // 记录最近返回元素的位置
        lastRet =
                index;

        return (E) elementData[
                index
        ];
    }

    /**
     * 删除最近一次 next() 返回的元素
     */
    public void remove() {

        if (
                expectedModCount
                        != modCount
        ) {

            throw new ConcurrentModificationException();
        }

        if (
                lastRet < 0
        ) {

            throw new IllegalStateException();
        }

        try {

            ArrayList.this.remove(
                    lastRet
            );

            // 删除以后重新调整游标
            cursor =
                    lastRet;

            lastRet =
                    -1;

            expectedModCount =
                    modCount;

        } catch (
                IndexOutOfBoundsException e
        ) {

            throw new ConcurrentModificationException();
        }
    }
}可以看到:
ArrayList
    ↓
自己负责保存数据


Itr
    ↓
自己负责如何遍历 ArrayList这里就体现了:
Iterable和:
Iterator职责的区别。
4.5 为什么不把 Iterator 和 Iterable 合并
如果直接把:
hasNext()

next()

remove()全部放到 Iterable 中,看起来好像也能实现遍历。
但这样会把:
是否可以被迭代和:
具体怎么迭代混在一起。
从英文含义也可以理解:
Iterable
    ↓
-able
    ↓
表示“可以被迭代”


Iterator
    ↓
-or
    ↓
表示“执行迭代的人 / 对象”所以两者分别负责:
Iterable
    ↓
提供迭代能力


Iterator
    ↓
负责具体迭代过程这样就可以让同一个集合拥有:
多种不同的迭代方式而不是把某一种遍历方式直接写死在集合本身。
4.6 Iterable 和 for-each
原则上,只要一个对象实现了:
Iterable就可以使用:
for-each进行遍历。
例如:
for (
        String element : list
) {

    System.out.println(
            element
    );
}背后仍然通过:
list.iterator()获取 Iterator。
所以整个关系可以记成:
Iterable
    ↓
iterator()
    ↓
Iterator
    ↓
hasNext()
    ↓
next()4.6.1 Map 为什么不能直接使用 for-each
Map 并没有实现:
Iterable所以不能直接:
for (
        Map.Entry<K, V> entry : map
) {
}通常需要先通过:
map.entrySet()

map.keySet()

map.values()转换成可以遍历的 Collection。
例如遍历 Entry:
for (
        Map.Entry<String, Integer> entry
                : map.entrySet()
) {

    System.out.println(
            entry.getKey()
                    + "="
                    + entry.getValue()
    );
}因为:
entrySet()
    ↓
Set
    ↓
Collection
    ↓
Iterable所以可以使用:
for-each遍历。
4.7 Iterable 的 forEach()
JDK 8 在 Iterable 中增加了:
forEach()方法。
源码:
default void forEach(
        Consumer<? super T> action) {

    Objects.requireNonNull(
            action
    );

    for (
            T element : this
    ) {

        action.accept(
                element
        );
    }
}首先:
Objects.requireNonNull(
        action
);检查:
Consumer 不能为空如果为:
null就会抛出:
NullPointerException然后使用:
for-each遍历当前 Iterable 中的所有元素。
每遍历一个元素,就执行:
action.accept(
        element
);4.7.1 使用 Lambda
例如:
List<Integer> list =
        new ArrayList<>(
                Arrays.asList(
                        1,
                        2,
                        3
                )
        );

list.forEach(
        integer ->
                System.out.println(
                        integer
                )
);这里:
integer -> System.out.println(integer)实际上就是一个:
Consumer<Integer>4.7.2 不使用 Lambda
如果不用 Lambda:
List<Integer> list =
        new ArrayList<>(
                Arrays.asList(
                        1,
                        2,
                        3
                )
        );

list.forEach(
        new Consumer<Integer>() {

            @Override
            public void accept(
                    Integer integer) {

                System.out.println(
                        integer
                );
            }
        }
);所以:
Iterable.forEach()
    ↓
接收 Consumer
    ↓
遍历每一个元素
    ↓
调用 accept()4.8. LinkedList 的迭代器
LinkedList 的迭代方式和 ArrayList 不完全相同。
它最终会通过:
ListIterator完成遍历。
例如:
public ListIterator<E> listIterator(
        int index) {

    checkPositionIndex(
            index
    );

    return new ListItr(
            index
    );
}其中:
ListItr是 LinkedList 自己的内部迭代器。
4.9 ListIterator
这里又出现了另外一个接口:
ListIterator它继承:
Iterator核心定义:
public interface ListIterator<E>
        extends Iterator<E> {

    boolean hasNext();

    E next();

    boolean hasPrevious();

    E previous();
}Iterator 主要支持:
向后遍历ListIterator 则进一步支持:
向后遍历

向前遍历所以可以理解成:
Iterator
    ↓
基础迭代器


ListIterator
    ↓
专门用于 List
    ↓
支持双向遍历还有一个区别:
Iterator
    ↓
Collection 体系普遍可以使用


ListIterator
    ↓
只用于 List例如:
ArrayList
LinkedList可以使用 ListIterator。
而:
HashSet就不能使用 ListIterator。
4.10 为什么集合不直接实现 Iterator
为什么不直接让:
ArrayList

LinkedList自己实现 Iterator?
而要专门使用:
内部类实现 Iterator?
一个重要原因就是:
同一个集合可能存在多种不同的遍历方式。
例如 LinkedList:
正向遍历

反向遍历就可以对应不同的 Iterator。
如果集合本身直接实现 Iterator,那么:
集合对象和:
某一次迭代状态就会混在一起。
而现在的设计:
集合
    ↓
负责保存数据


Iterator
    ↓
负责保存某一次遍历状态更加清晰。
并且每次:
list.iterator()都可以获得:
一个新的 Iterator这样不同的遍历过程可以互不影响。
4.11 DescendingIterator
LinkedList 作为:
Deque时,还支持:
descendingIterator()进行逆序遍历。
它内部同样使用:
Iterator实现。
例如可以简单理解为:
private class DescendingIterator
        implements Iterator<E> {

    private final ListItr iterator =
            new ListItr(
                    size()
            );

    public boolean hasNext() {

        return iterator.hasPrevious();
    }

    public E next() {

        return iterator.previous();
    }

    public void remove() {

        iterator.remove();
    }
}可以看到:
DescendingIterator
    ↓
内部使用 ListIterator而 ListIterator 本身支持:
previous()所以 DescendingIterator 就可以不断:
从后向前进行遍历。
使用方式:
Iterator<String> iterator =
        list.descendingIterator();

while (
        iterator.hasNext()
) {

    System.out.println(
            iterator.next()
    );
}正常 Iterator:
first
    ↓
next
    ↓
next
    ↓
lastDescendingIterator:
last
    ↓
previous
    ↓
previous
    ↓
first4.12 Iterator 和 Iterable 总结
两者最核心的区别:
| 对比项 | Iterable | Iterator |
|---|---|---|
| 作用 | 表示对象可以被迭代 | 负责具体迭代过程 |
| 核心方法 | iterator() | hasNext()、next()、remove() |
| Collection 是否继承 | 是 | 否 |
| 是否支持 for-each | 实现 Iterable 后可以 | for-each 底层使用 Iterator |
| 是否保存遍历状态 | 否 | 是 |
| 一个集合能否创建多个 | 提供能力 | 可以创建多个 Iterator |
整体关系:
Iterable
    ↓
表示“可以遍历”
    ↓
iterator()
    ↓
返回 Iterator
    ↓
负责“怎么遍历”Collection 中:
Iterable
    ↑
Collection
    ├── List
    ├── Set
└── QueueList 中还可以进一步使用:
Iterator
    ↑
ListIterator
    ↓
支持双向遍历而 LinkedList 还可以通过:
descendingIterator()实现:
逆序遍历最简单地记:
Iterable 负责提供 Iterator,Iterator 负责真正遍历元素。
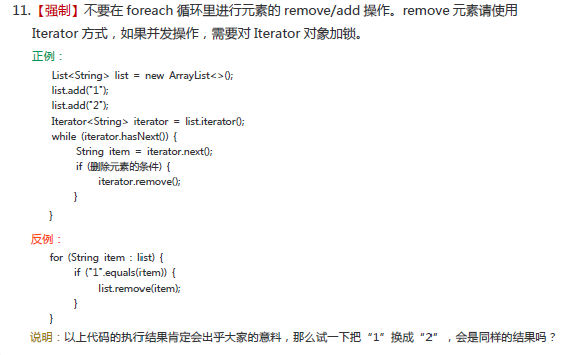
5. Java foreach 循环陷阱
为什么阿里的 Java 开发手册会强调:
不要在 foreach 循环中直接使用集合自身的
remove()/add()方法修改集合。
5.1 关于 fail-fast
5.1.1 什么是 fail-fast
先来看一下 fail-fast 的含义。
In systems design, a fail-fast system is one which immediately reports at its interface any condition that is likely to indicate a failure. Fail-fast systems are usually designed to stop normal operation rather than attempt to continue a possibly flawed process.
大致意思就是:
fail-fast 是一种通用的系统设计思想,一旦检测到可能发生错误,就立即抛出异常,不再继续执行后面的逻辑。
例如:
public void test(
        XiaoZhao xiaozhao) {

    if (xiaozhao == null) {

        throw new RuntimeException(
                "xiaozhao 不能为空"
        );
    }

    System.out.println(
            xiaozhao.toString()
    );
}一旦检测到:
xiaozhao == null就立即:
抛出异常
    ↓
停止当前正常流程后面的:
xiaozhao.toString();也就不会继续执行,从而避免出现更严重的问题。
很多时候我们会把 fail-fast 和 Java 集合框架联系在一起,但实际上:
fail-fast 并不是 Java 集合框架特有的机制,而是一种通用的错误检测思想。
5.2 for-each 删除元素报错
5.2.1 问题示例
之所以把 fail-fast 放到集合框架中介绍,是因为这个问题在集合遍历时非常容易遇到。
例如:
List<String> list =
        new ArrayList<>();

list.add(
        "周芷若"
);

list.add(
        "小昭"
);

list.add(
        "张无忌真他妈的帅"
);

for (
        String str : list
) {

    if (
            "小昭".equals(
                    str
            )
    ) {

        list.remove(
                str
        );
    }
}

System.out.println(
        list
);这段代码看起来好像没有问题:
遍历集合
    ↓
找到“小昭”
    ↓
删除“小昭”但运行后会报错:
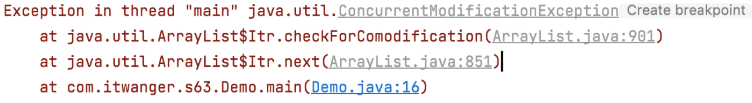
异常:
ConcurrentModificationException根据异常堆栈,可以定位到类似这样的代码:
final void checkForComodification() {

    if (
            modCount
                    != expectedModCount
    ) {

        throw new ConcurrentModificationException();
    }
}也就是说:
modCount和:
expectedModCount不一致以后,触发了:
ConcurrentModificationException5.2.2 for-each 的本质
为什么会执行:
checkForComodification()?
因为前面已经讲过:
for-each 本质上是语法糖,对于 Iterable 集合,底层会通过 Iterator 完成遍历。
原代码:
for (
        String str : list
) {

    if (
            "小昭".equals(
                    str
            )
    ) {

        list.remove(
                str
        );
    }
}编译以后可以大致理解成:
Iterator<String> iterator =
        list.iterator();

while (
        iterator.hasNext()
) {

    String str =
            iterator.next();

    if (
            "小昭".equals(
                    str
            )
    ) {

        list.remove(
                str
        );
    }
}整个关系:
for-each
    ↓
iterator()
    ↓
Iterator
    ↓
hasNext()
    ↓
next()再看 ArrayList 的:
iterator()源码:
public Iterator<E> iterator() {

    return new Itr();
}返回的是 ArrayList 内部类:
Itr而 Itr 实现了:
Iterator5.2.3 Itr 的实现
ArrayList 内部的迭代器大致如下:
private class Itr
        implements Iterator<E> {

    // 下一个元素索引
    int cursor;

    // 最近一次返回元素的索引
    int lastRet =
            -1;

    // 创建迭代器时记录当前 modCount
    int expectedModCount =
            modCount;

    public boolean hasNext() {

        return cursor
                != size;
    }

    @SuppressWarnings("unchecked")
    public E next() {

        // 检查集合是否发生结构性修改
        checkForComodification();

        int index =
                cursor;

        Object[] elementData =
                ArrayList.this.elementData;

        if (
                index >= elementData.length
        ) {

            throw new ConcurrentModificationException();
        }

        cursor =
                index + 1;

        lastRet =
                index;

        return (E) elementData[
                index
        ];
    }
}创建:
new Itr()时:
expectedModCount =
modCount;也就是说:
Iterator 创建时
    ↓
记录当前集合的结构性修改次数ArrayList 中:
modCount用于记录:
结构性修改次数例如:
添加元素

删除元素都会影响集合结构。
而 Iterator 自己保存:
expectedModCount表示:
我创建时认为集合应该处于什么状态遍历过程中:
checkForComodification();会不断检查:
modCount
    ↓
集合当前修改次数


expectedModCount
    ↓
Iterator 预期修改次数如果:
modCount != expectedModCount说明:
Iterator 遍历过程中
    ↓
集合结构被其他操作修改于是:
立即抛出 ConcurrentModificationException这就是:
fail-fast在集合迭代器中的体现。
5.3 分析代码执行逻辑
再来看之前的代码:
List<String> list =
        new ArrayList<>();

list.add(
        "周芷若"
);

list.add(
        "小昭"
);

list.add(
        "张无忌真他妈的帅"
);

for (
        String str : list
) {

    if (
            "小昭".equals(
                    str
            )
    ) {

        list.remove(
                str
        );
    }
}

System.out.println(
        list
);5.3.1 创建 Iterator
在开始 for-each 之前:
Iterator 被创建此时:
expectedModCount =
modCount;也就是:
expectedModCount记录了当前集合的结构状态。
5.3.2 遍历过程中删除元素
遍历到:
小昭以后执行:
list.remove(
        str
);注意这里调用的是:
List 自己的 remove()而不是:
Iterator.remove()ArrayList 发生删除以后:
modCount
    ↓
发生变化但是 Iterator 中保存的:
expectedModCount并没有同步变化。
于是:
modCount
        !=
expectedModCount5.3.3 下一次 next()
继续遍历时会再次调用:
iterator.next();而 next() 中会执行:
checkForComodification();检查:
final void checkForComodification() {

    if (
            modCount
                    != expectedModCount
    ) {

        throw new ConcurrentModificationException();
    }
}此时两者已经不相等:
modCount
    ↓
集合已经被修改


expectedModCount
    ↓
还是 Iterator 创建时记录的值最终:
ConcurrentModificationException被抛出。
所以问题的核心其实就是:
Iterator 正在遍历
    ↓
你却绕过 Iterator
    ↓
直接修改集合结构
    ↓
Iterator 检测到状态不一致
    ↓
fail-fast这也是为什么 Java 开发规范通常不建议:
for-each
+
Collection.remove()这种组合。
5.4 如何正确删除元素
5.4.1 remove 后 break
一种方式是:
删除以后立即 break例如:
List<String> list =
        new ArrayList<>();

list.add(
        "周芷若"
);

list.add(
        "小昭"
);

list.add(
        "张无忌真他妈的帅"
);

for (
        String str : list
) {

    if (
            "小昭".equals(
                    str
            )
    ) {

        list.remove(
                str
        );

        break;
    }
}

System.out.println(
        list
);删除以后:
break;循环立即结束。
因此不会再次执行:
Iterator.next()也就不会再触发:
checkForComodification()但是这种方式有明显局限:
如果集合中有多个符合条件的元素需要全部删除,break 就不合适了。
所以它并不是通用解决方案。
5.4.2 普通 for 循环
也可以使用普通 for 循环:
List<String> list =
        new ArrayList<>();

list.add(
        "周芷若"
);

list.add(
        "小昭"
);

list.add(
        "张无忌真他妈的帅"
);

for (
        int i = 0;
        i < list.size();
        i++
) {

    String str =
            list.get(i);

    if (
            "小昭".equals(
                    str
            )
    ) {

        list.remove(
                str
        );
    }
}这种方式没有使用 Iterator,所以不会触发 Iterator 的:
fail-fast检查。
但是它同样存在问题。
假设原来的 List:
0 → 周芷若

1 → 小昭

2 → 张无忌真他妈的帅执行:
list.remove(
        "小昭"
);以后变成:
0 → 周芷若

1 → 张无忌真他妈的帅原来下标:
2的元素移动到了:
1但是循环中的:
i++又会把 i 变成:
2于是:
原来移动到 index = 1 的元素就可能被跳过。
所以:
使用索引 for 循环删除元素时,需要自己处理下标变化问题。
5.4.3 使用 Iterator
更直接的方式是:
使用 Iterator 自己的 remove()例如:
List<String> list =
        new ArrayList<>();

list.add(
        "周芷若"
);

list.add(
        "小昭"
);

list.add(
        "张无忌真他妈的帅"
);

Iterator<String> iterator =
        list.iterator();

while (
        iterator.hasNext()
) {

    String str =
            iterator.next();

    if (
            "小昭".equals(
                    str
            )
    ) {

        iterator.remove();
    }
}为什么:
Iterator.remove()可以正常删除?
看一下核心逻辑:
public void remove() {

    if (
            lastRet < 0
    ) {

        throw new IllegalStateException();
    }

    checkForComodification();

    try {

        // 删除最近一次 next() 返回的元素
        ArrayList.this.remove(
                lastRet
        );

        // 调整游标
        cursor =
                lastRet;

        lastRet =
                -1;

        // 同步修改次数
        expectedModCount =
                modCount;

    } catch (
            IndexOutOfBoundsException e
    ) {

        throw new ConcurrentModificationException();
    }
}重点就在:
expectedModCount =
modCount;Iterator 删除元素以后:
集合 modCount
    ↓
发生变化同时:
Iterator expectedModCount
    ↓
同步更新因此:
modCount
        ==
expectedModCount后续继续遍历时,就不会因为这次合法删除触发 fail-fast。
整个过程:
iterator.next()
    ↓
找到目标元素
    ↓
iterator.remove()
    ↓
集合删除元素
    ↓
modCount 改变
    ↓
expectedModCount 同步更新
    ↓
继续遍历5.5 小结
为什么不建议在 foreach 中直接删除元素?
因为:
for-each
    ↓
底层使用 IteratorIterator 在遍历时会保存:
expectedModCount集合本身维护:
modCount正常情况下:
modCount
        ==
expectedModCount如果遍历过程中直接调用:
list.remove()集合发生结构性修改:
modCount
    ↓
变化但是:
expectedModCount
    ↓
没有同步于是下一次 Iterator 检查时:
modCount
        !=
expectedModCount最终:
ConcurrentModificationException正确删除方式:
Iterator
    ↓
next()
    ↓
判断元素
    ↓
iterator.remove()因为 Iterator 自己删除以后会:
expectedModCount =
modCount;重新同步状态。
所以最核心的一句话就是:
foreach 遍历集合时,不要直接调用集合自身的
remove()修改集合结构;需要边遍历边删除时,应使用 Iterator 的remove()。