
PriorityQueue
字数: 0 字 时长: 0 分钟
1. PriorityQueue 概述
PriorityQueue 是 Java 中基于:
优先级堆实现的优先队列。
它能够以较高效率完成元素的插入和删除,并自动维护元素之间的优先级关系。
插入和删除操作的时间复杂度通常为:
O(log n)普通队列一般遵循:
FIFO
先进先出而 PriorityQueue 并不是按照元素进入队列的先后顺序出队,而是:
按照元素的优先级决定出队顺序。
也就是说:
元素入队
    ↓
根据优先级调整位置
    ↓
维护堆结构


元素出队
    ↓
优先级最高的元素先出队1.1 基本使用
例如:
public static void main(
        String[] args) {

    // 创建 PriorityQueue
    PriorityQueue<String> priorityQueue =
            new PriorityQueue<>();

    // 添加元素
    priorityQueue.offer(
            "灭绝师太"
    );

    priorityQueue.offer(
            "周芷若"
    );

    priorityQueue.offer(
            "张无忌"
    );

    // 按优先级依次取出元素
    System.out.println(
            "PriorityQueue 中的元素:"
    );

    while (
            !priorityQueue.isEmpty()
    ) {

        System.out.print(
                priorityQueue.poll()
                        + " "
        );
    }
}输出:
PriorityQueue 中的元素:
周芷若 张无忌 灭绝师太首先创建:
PriorityQueue<String>然后通过:
offer()添加三个元素。
最后不断调用:
poll()按照 PriorityQueue 的优先级顺序依次取出元素。
1.2 自定义优先级
再来看一个例子:
PriorityQueue<String> priorityQueue =
        new PriorityQueue<>(
                Comparator.reverseOrder()
        );

priorityQueue.offer(
        "灭绝师太"
);

priorityQueue.offer(
        "周芷若"
);

priorityQueue.offer(
        "张无忌"
);

System.out.println(
        "PriorityQueue 中的元素:"
);

while (
        !priorityQueue.isEmpty()
) {

    System.out.print(
            priorityQueue.poll()
                    + " "
    );
}这里使用:
Comparator.reverseOrder()指定 PriorityQueue 按照与自然顺序相反的规则进行比较。
输出:
PriorityQueue 中的元素:
灭绝师太 张无忌 周芷若和前一个例子的结果正好相反。
所以 PriorityQueue 中元素之间的优先级,可以通过:
自然顺序

或者

Comparator决定。
2. PriorityQueue 的作用
PriorityQueue 的主要作用是:
维护一组元素的优先级,使元素能够按照指定的优先级顺序被取出。
当调用:
poll()时,会从队首取出:
按照当前比较规则优先级最高的元素PriorityQueue 可以用于:
任务调度

事件处理

需要按照优先级处理数据的算法在一些经典算法中,也经常会使用 PriorityQueue,例如:
Dijkstra 算法

Prim 算法

Huffman 编码2.1 Dijkstra 算法
Dijkstra 算法是一种用于计算:
带权图最短路径的算法。
它采用贪心策略:
选择当前距离源点最近的顶点
    ↓
以该顶点为中心进行扩展
    ↓
更新其他顶点的距离
    ↓
继续选择当前最近的顶点经过多次扩展,可以得到源点到其他顶点的最短路径。
2.2 Prim 算法
Prim 算法用于求解:
最小生成树在一个加权连通图中,寻找一棵生成树,使得:
所有边的权值之和最小基本过程:
从任意顶点开始
    ↓
不断扩展生成树
    ↓
每次选择距离当前生成树最近的顶点
    ↓
加入生成树2.3 Huffman 编码
Huffman 编码是一种基于:
霍夫曼树的压缩算法。
主要思想:
出现频率高的字符
    ↓
使用较短编码


出现频率低的字符
    ↓
使用较长编码从而达到:
压缩数据的目的。
解压缩时再根据编码逐步恢复原始内容。
由于 PriorityQueue 底层基于:
堆实现,因此在数据量较大时,也可以保持较好的时间复杂度。
3. PriorityQueue 与堆
PriorityQueue 中涉及元素之间的:
大小关系

优先级关系元素之间的比较可以通过:
自然顺序
Natural Ordering也可以通过:
Comparator决定。
元素本身也可以实现:
Comparable接口来定义自然顺序。
PriorityQueue 内部通过:
堆维护元素之间的优先级关系。
默认情况下,可以理解为:
小顶堆也可以通过 Comparator 改变比较规则,实现类似:
大顶堆的效果。
3.1 完全二叉树
堆本质上是一棵:
完全二叉树
Complete Binary Tree完全二叉树的特点是:
除最后一层以外
    ↓
其他层全部填满


最后一层
    ↓
节点从左向右排列例如:
        1
      /   \
     2     3
    / \   /
4 5 63.2 小顶堆和大顶堆
堆是一种完全二叉树。
小顶堆:
父节点
    ↓
小于或等于子节点因此:
根节点
    ↓
整个堆中最小的元素例如:
      1
     / \
    2   3
   / \ / \
4 5 6 7这是一个小顶堆。
大顶堆则相反:
父节点
    ↓
大于或等于子节点根节点是最大的元素。
例如:
        8
      /   \
     7     5
    / \   / \
6 4 2 13.3 使用数组表示堆
因为完全二叉树的结构非常规则,所以:
堆可以直接使用数组保存,而不需要额外保存左右子节点引用。
例如:
[10, 20, 15, 30, 40]对应的完全二叉树:
      10
     /  \
   20    15
  /  \
30 40如果使用从 0 开始的数组下标:
        0
      /   \
     1     2
    / \
3 4父子节点之间存在固定关系:
leftIndex
=
parentIndex * 2 + 1


rightIndex
=
parentIndex * 2 + 2


parentIndex
=
(nodeIndex - 1) / 2例如:
parentIndex = 0那么:
leftIndex
=
0 × 2 + 1
=
1


rightIndex
=
0 × 2 + 2
=
2所以:
数组下标和:
完全二叉树中的节点位置可以直接对应起来。
假设数组:
[10, 20, 15, 30, 40]对应:
      10
     /  \
   20    15
  /  \
30 40满足:
10 <= 20

10 <= 15

20 <= 30

20 <= 40因此符合:
小顶堆的性质。
再结合图来看:
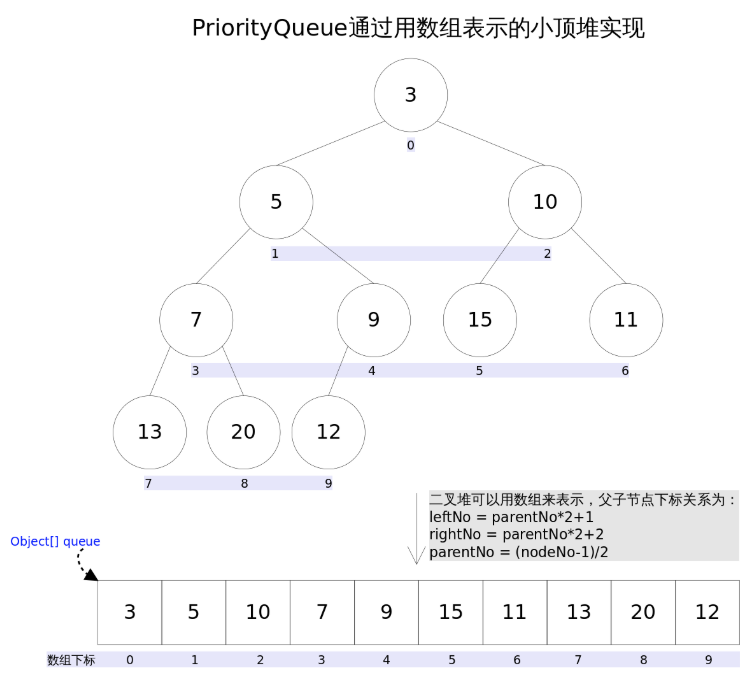
父节点和子节点之间的关系:
leftNo = parentNo * 2 + 1

rightNo = parentNo * 2 + 2

parentNo = (nodeNo - 1) / 2通过这三个公式,就可以快速计算:
父节点下标

左子节点下标

右子节点下标这也是为什么 PriorityQueue 可以直接使用数组保存堆结构。
4. 方法剖析
4.1 add() 和 offer()
add(E e)和:
offer(E e)语义基本相同:
向优先队列中插入元素Queue 接口中,两者对插入失败的处理方式不同:
add()
    ↓
失败时抛出异常


offer()
    ↓
失败时返回 false对于 PriorityQueue 来说,这两个方法在正常添加元素时没有本质区别。
插入过程:
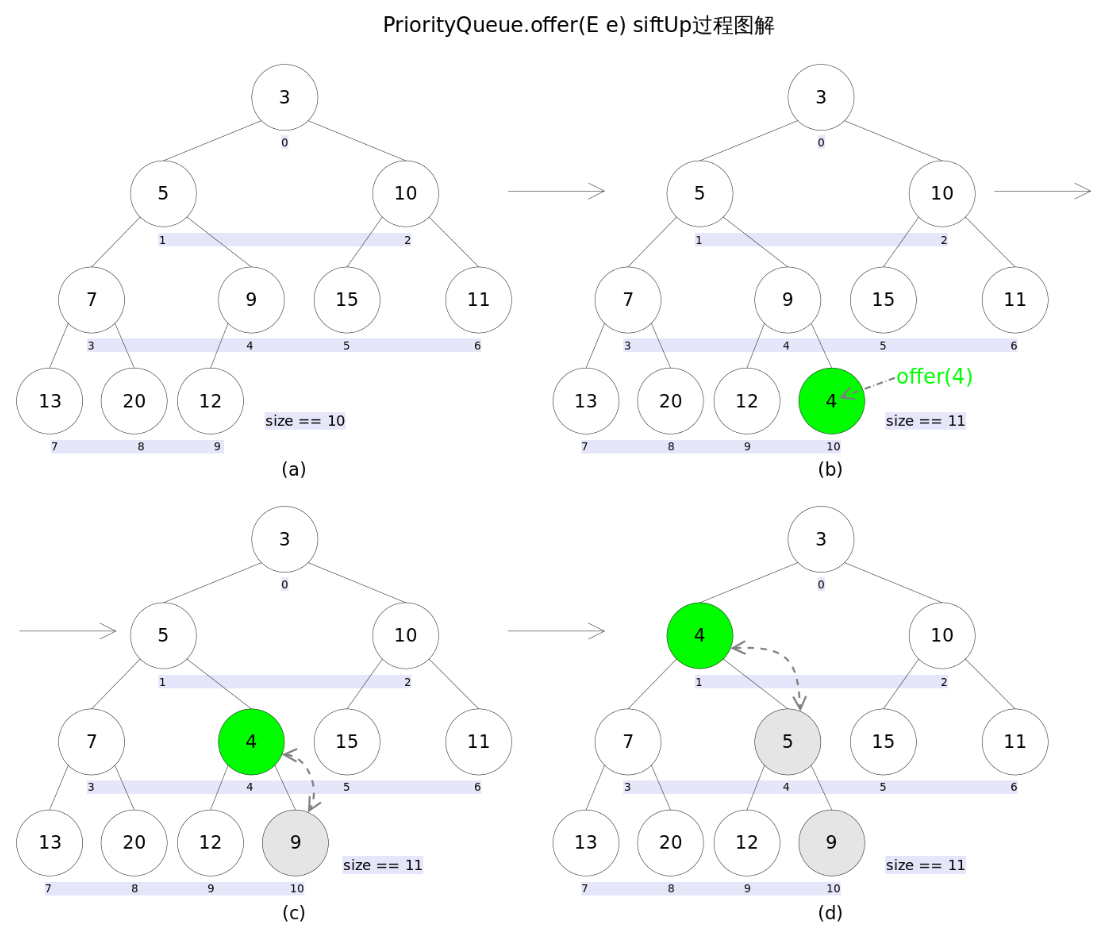
新元素加入以后,可能会破坏:
堆结构所以需要重新调整。
offer() 源码:
public boolean offer(
        E e) {

    // 不允许 null
    if (e == null) {

        throw new NullPointerException();
    }

    modCount++;

    int index =
            size;

    // 容量不足则扩容
    if (
            index
                    >= queue.length
    ) {

        grow(
                index + 1
        );
    }

    size =
            index + 1;

    // 第一个元素
    if (index == 0) {

        queue[0] =
                e;

    } else {

        // 向上调整
        siftUp(
                index,
                e
        );
    }

    return true;
}其中:
grow()和 ArrayList 中的扩容思路类似:
创建更大的数组
    ↓
复制原数组元素这里真正重要的是:
siftUp()它负责:
插入新元素以后,从当前位置不断向上调整,使堆重新满足优先级规则。
4.2 siftUp()
private void siftUp(
        int index,
        E element) {

    while (index > 0) {

        // parentIndex = (nodeIndex - 1) / 2
        int parent =
                (
                        index - 1
                ) >>> 1;

        Object parentElement =
                queue[parent];

        if (
                comparator.compare(
                        element,
                        (E) parentElement
                ) >= 0
        ) {

            break;
        }

        // 父节点下移
        queue[index] =
                parentElement;

        // 继续向上比较
        index =
                parent;
    }

    queue[index] =
            element;
}整个调整过程:
新元素放在 index
    ↓
找到 parent
    ↓
新元素与 parent 比较如果:
新元素优先级更高就继续向上移动。
直到满足:
element >= parent为止。
也就是:
从插入位置开始,让新元素逐层向上调整,直到重新满足堆结构。
这里的比较规则可以来自:
元素自然顺序

或者

Comparator4.3 element() 和 peek()
element()和:
peek()都是:
获取但不删除队首元素区别:
element()
    ↓
队列为空时抛出异常


peek()
    ↓
队列为空时返回 null对于默认的小顶堆:
堆顶
    ↓
整个堆中的最小元素堆使用数组保存,而堆顶对应:
queue[0]所以直接获取:
queue[0]即可。
示意图:
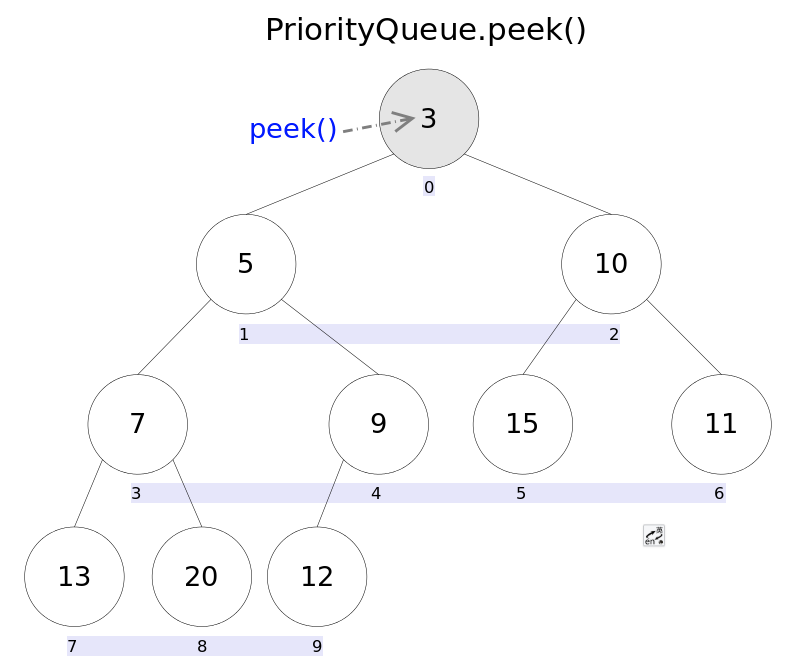
源码:
public E peek() {

    if (size == 0) {

        return null;
    }

    return (E) queue[0];
}核心就是:
queue[0]
    ↓
堆顶元素4.4 remove() 和 poll()
remove()和:
poll()都是:
获取并删除队首元素区别:
remove()
    ↓
失败时抛出异常


poll()
    ↓
失败时返回 null删除堆顶元素以后:
堆结构发生变化所以需要重新调整。
示意图:
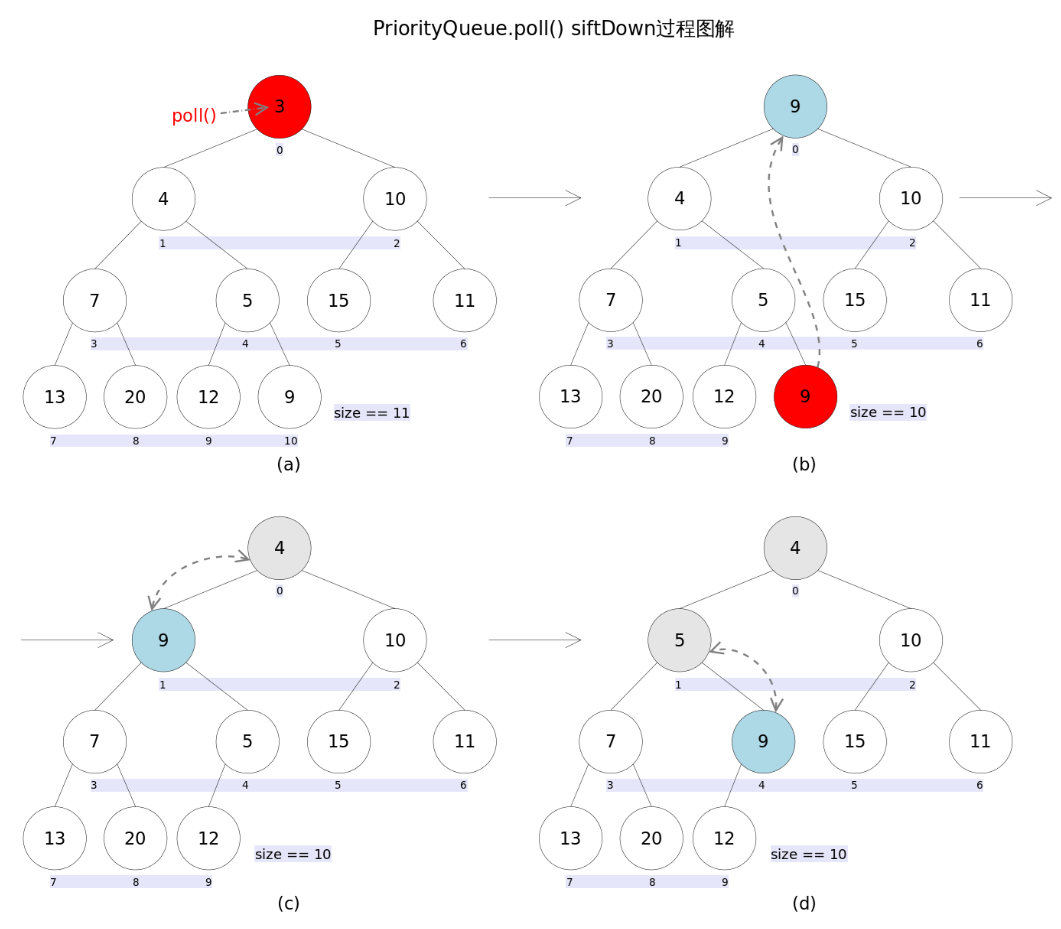
源码:
public E poll() {

    if (size == 0) {

        return null;
    }

    int lastIndex =
            --size;

    modCount++;

    // 保存原堆顶元素
    E result =
            (E) queue[0];

    // 获取最后一个元素
    E last =
            (E) queue[lastIndex];

    queue[lastIndex] =
            null;

    // 将最后一个元素放到堆顶后向下调整
    if (lastIndex != 0) {

        siftDown(
                0,
                last
        );
    }

    return result;
}整个过程:
保存 queue[0]
    ↓
取出最后一个元素
    ↓
删除最后一个位置
    ↓
把最后一个元素放到堆顶
    ↓
siftDown()
    ↓
重新调整堆
    ↓
返回原来的堆顶元素重点就是:
siftDown()4.5 siftDown()
siftDown() 的作用:
从指定位置开始,让元素不断向下调整,与左右子节点中优先级更高的节点进行比较,直到重新满足堆结构。
源码:
private void siftDown(
        int index,
        E element) {

    int half =
            size >>> 1;

    while (
            index < half
    ) {

        // 左子节点
        int child =
                (
                        index << 1
                ) + 1;

        Object childElement =
                queue[child];

        // 右子节点
        int right =
                child + 1;

        // 找到左右子节点中优先级更高的那个
        if (
                right < size
                        && comparator.compare(
                        (E) childElement,
                        (E) queue[right]
                ) > 0
        ) {

            childElement =
                    queue[
                            child = right
                    ];
        }

        // 当前元素已经满足堆结构
        if (
                comparator.compare(
                        element,
                        (E) childElement
                ) <= 0
        ) {

            break;
        }

        // 子节点上移
        queue[index] =
                childElement;

        index =
                child;
    }

    queue[index] =
            element;
}整个过程:
从 index 开始
    ↓
找到左右子节点
    ↓
选择其中优先级更高的一个
    ↓
与当前元素比较如果当前元素已经满足:
堆结构就停止。
否则:
子节点上移
    ↓
当前元素继续向下直到找到合适的位置。
4.6 remove(Object o)
remove(Object o)用于删除 PriorityQueue 中:
与 o 相等的某一个元素如果存在多个相同元素:
只删除其中一个这个方法并不是 Queue 接口独有的方法,而是来自:
Collection删除任意位置的元素以后,同样可能破坏:
堆结构所以需要调整。
主要分为两种情况:
1. 删除的是最后一个元素
    ↓
直接删除
    ↓
不需要调整


2. 删除的不是最后一个元素
    ↓
使用最后一个元素补到删除位置
    ↓
调用 siftDown()
    ↓
重新调整示意图:
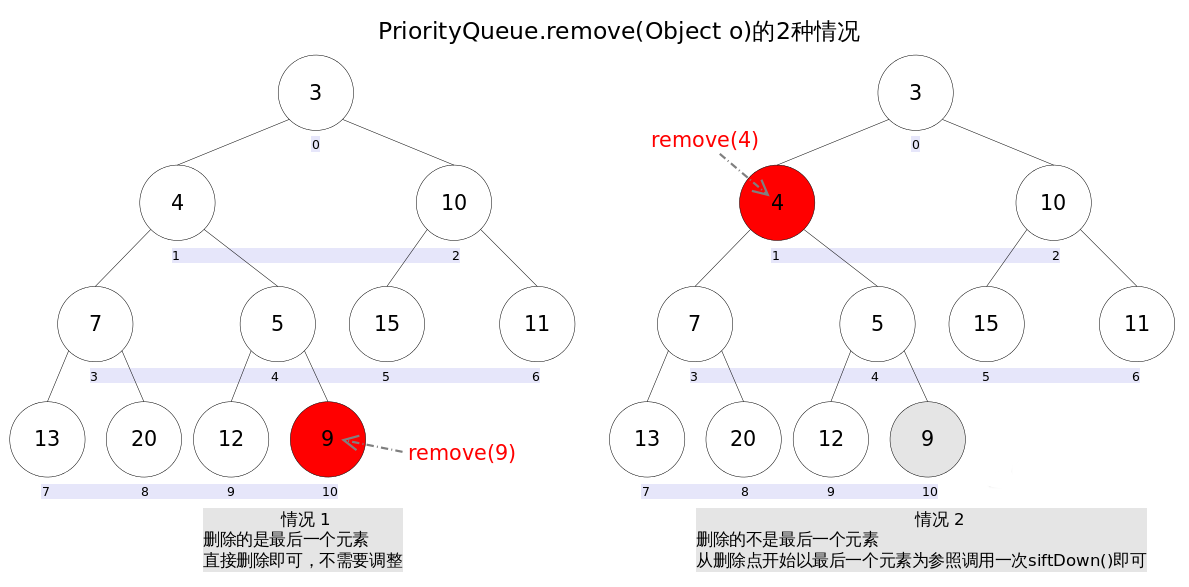
源码:
public boolean remove(
        Object o) {

    // 找到第一个与 o 相等的元素
    int index =
            indexOf(o);

    if (index == -1) {

        return false;
    }

    int lastIndex =
            --size;

    // 删除的是最后一个元素
    if (
            lastIndex
                    == index
    ) {

        queue[index] =
                null;

    } else {

        // 保存最后一个元素
        E moved =
                (E) queue[lastIndex];

        queue[lastIndex] =
                null;

        // 从删除位置向下调整
        siftDown(
                index,
                moved
        );

        // ......
    }

    return true;
}5. 小结
PriorityQueue 是一种非常常用的数据结构,本质上是:
基于堆实现的优先队列它的底层使用:
数组保存堆中的元素,并通过堆的性质维护元素之间的优先级。
整体结构:
PriorityQueue
    ↓
数组
    ↓
完全二叉树
    ↓
堆主要特点:
- 底层使用数组保存元素,通过堆结构维护元素之间的优先级。
- 取出元素时按照优先级顺序取出,可以按照从小到大,也可以通过比较规则改变顺序。
- 元素之间的大小关系可以通过
Comparable的自然顺序,或者构造时传入的Comparator决定。
插入元素:
offer()
    ↓
siftUp()
    ↓
向上调整删除堆顶元素:
poll()
    ↓
最后一个元素移动到堆顶
    ↓
siftDown()
    ↓
向下调整因此 PriorityQueue 能够在保持较高效率的同时,始终维护:
队首元素
    ↓
当前优先级最高的元素