
面向对象
字数: 0 字 时长: 0 分钟
1. Object和类,万物皆对象
1.1 概述(面向过程和面向对象)
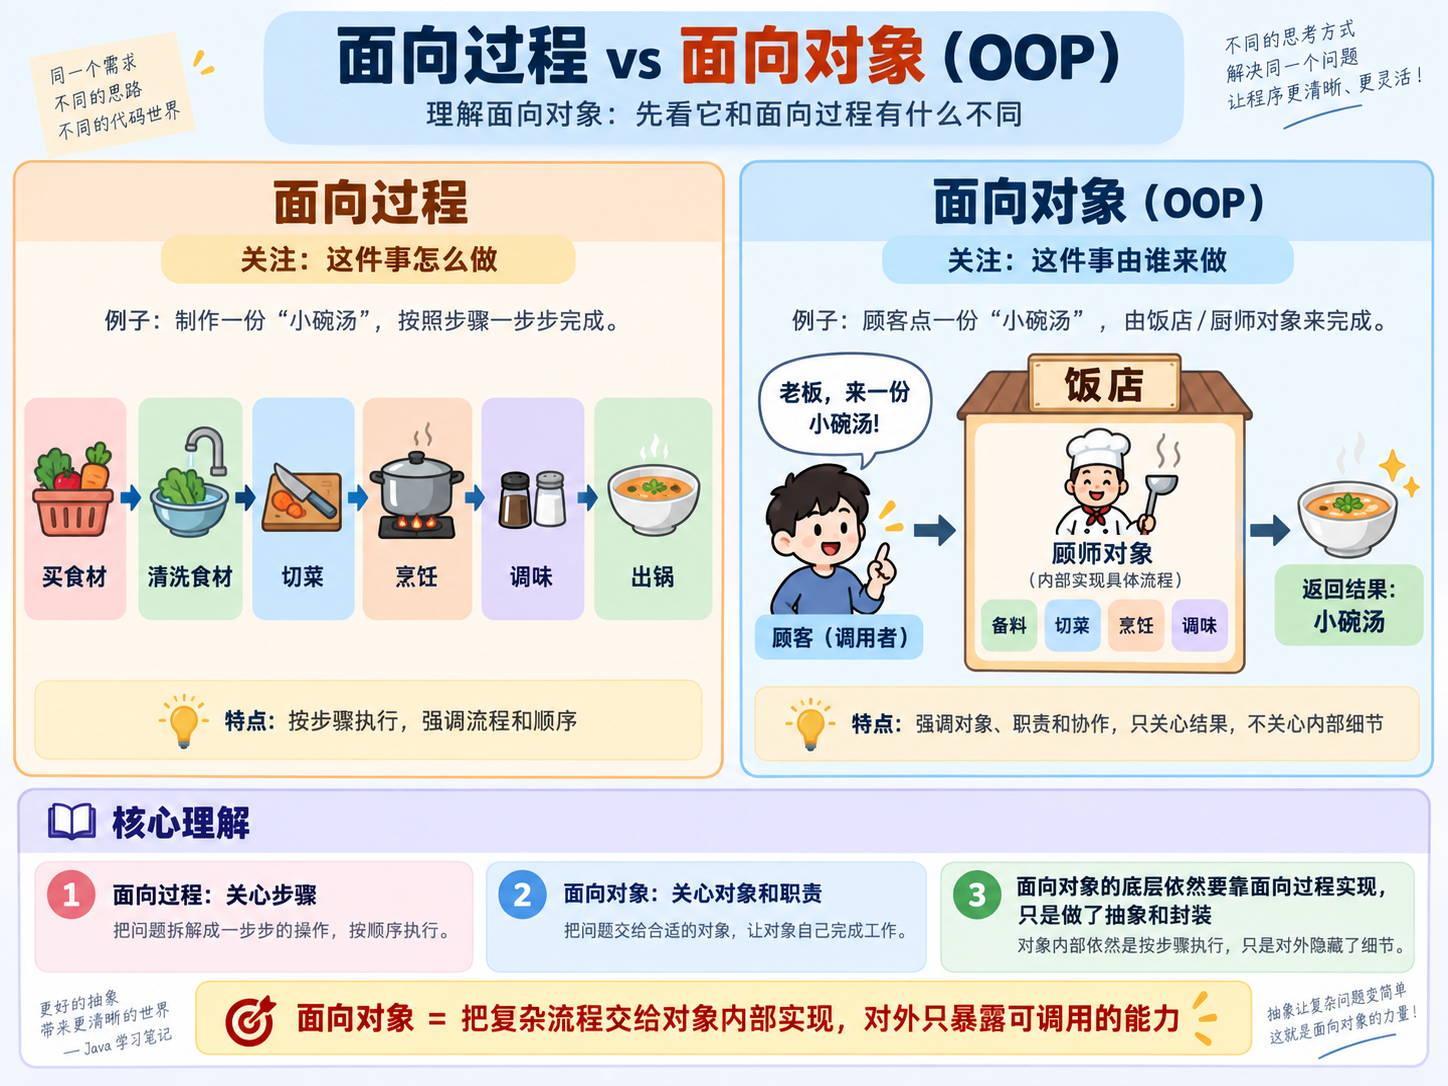
OOP 的英文全称是 Object-Oriented Programming,也就是面向对象编程。
要理解面向对象,可以先和传统的面向过程进行对比。
举个简单的例子。
有一天,你突然想吃一碗小碗汤,这时候大概有两种选择:
- 自己买豆腐皮、肉、蒜苔等食材,然后按照步骤自己做。
- 直接去饭店,对老板说一句:“来一份小碗汤。”
第一种更接近面向过程,第二种更接近面向对象。
面向过程更关注:
事情应该按照什么步骤完成。
例如自己做小碗汤:
买食材
  ↓
清洗食材
  ↓
切菜
  ↓
炒制
  ↓
加水
  ↓
调味
  ↓
出锅程序需要按照既定流程,一步一步完成任务。
而面向对象更关注:
这件事情应该由谁来完成。
例如去饭店吃饭,你只需要告诉老板:
我要一份小碗汤至于食材怎么准备、怎么炒、什么时候加调料,这些具体过程并不需要你关心。
如果突然不想吃小碗汤了,还可以告诉老板:
小碗汤还没做的话,帮我换成宫保鸡丁。你关心的是最终需要什么结果,而具体实现过程由对应的对象负责。
因此,两种思想可以简单理解为:
面向过程
    ↓
关注步骤和流程
    ↓
“这件事情应该怎么做?”


面向对象
    ↓
关注对象和职责
    ↓
“这件事情应该由谁来做?”面向对象的核心思想,就是将数据和相关操作组织到一个个对象中,每个对象负责自己的职责。
对象之间如果需要协作,就通过方法调用进行交互:
对象 A
  ↓
调用对象 B 的方法
  ↓
对象 B 完成自己的工作
  ↓
返回结果调用者通常不需要关心对象内部到底是如何实现的,只需要知道:
你能做什么
我应该怎么调用你
调用之后能得到什么结果这也体现了面向对象中非常重要的思想:
对外提供能力,对内隐藏实现。
不过,面向对象并不是完全脱离执行流程。
对象内部的方法最终仍然需要通过变量、判断、循环、方法调用等一系列语句完成具体任务。
因此,可以把面向对象理解为:
在具体执行流程的基础上,通过类和对象进一步进行抽象、封装和职责划分,让大型程序更加容易组织、维护和扩展。
Java 是一门典型的面向对象编程语言,后面会逐步学习:
类与对象
封装
继承
多态
抽象
接口这些都是 Java 面向对象编程中的核心内容。
1.2 类
在面向对象编程中,对象可以是现实世界中真实存在的事物,比如一条狗、一个人;也可以是抽象或虚拟的事物,比如游戏角色、订单、账户等。
Java 使用 类(Class) 来描述这些对象。
一个对象通常包含两部分:
- 状态:通过字段(Field)描述,例如人的姓名、年龄、性别。
- 行为:通过方法(Method)描述,例如人可以吃饭、睡觉。
可以把类理解为创建对象的“模板”,而对象则是根据这个模板创建出来的具体实例。
例如定义一个简单的 Person 类:
package com.kerwim.ObjAndClass;

public class Person {

    // 姓名
    private String name;

    // 年龄
    private int age;

    // 性别
    private int sex;

    // 吃饭
    private void eat() {
    }

    // 睡觉
    private void sleep() {
    }

    // 打豆豆
    private void dadoudou() {
    }
}一个类通常可以包含:
- 字段(Field)
- 方法(Method)
- 构造方法(Constructor)
在 Person 类中,有三个字段:
private String name;
private int age;
private int sex;这些定义在类中、方法外部的变量称为成员变量。
而定义在方法内部的变量,则称为局部变量(Local Variable)。
例如:
public void eat() {

    // 局部变量
    String food = "米饭";
}这里:
name、age、sex → 成员变量

food → 局部变量如果成员变量属于具体对象,而不是使用 static 修饰,那么也称为实例变量(Instance Variable)。
例如:
Person person = new Person();执行 new Person() 后,会创建一个 Person 对象,而 name、age、sex 这些实例变量也会作为该对象的一部分拥有对应的存储空间。
这也是“实例变量”这个名字的由来:
类
 ↓
new
 ↓
对象实例
 ↓
拥有自己的实例变量Person 中还有三个方法:
eat()
sleep()
dadoudou()它们用于描述 Person 对象能够执行的行为,也就是:
吃饭
睡觉
打豆豆那么问题来了:
这个类为什么没有构造方法?
在源码中,我们确实没有手动写构造方法:
public class Person {
}但是,如果一个类没有显式声明任何构造方法,Java 编译器会自动提供一个无参构造方法。
可以理解为编译器帮我们补上了:
public Person() {
}因此,前面的 Person 类可以理解为:
package com.kerwim.ObjAndClass;

public class Person {

    private String name;
    private int age;
    private int sex;

    // 编译器自动提供的无参构造方法
    public Person() {
    }

    private void eat() {
    }

    private void sleep() {
    }

    private void dadoudou() {
    }
}构造方法有几个明显的特点:
方法名与类名相同

没有返回值类型

创建对象时自动调用例如:
Person person = new Person();其中:
new Person()就会调用 Person() 构造方法。
需要注意:
只有在类中没有声明任何构造方法时,Java 编译器才会自动提供默认的无参构造方法。
如果我们自己定义了构造方法:
public Person(String name) {
    this.name = name;
}那么编译器就不会再自动提供:
public Person() {
}如果还需要无参构造方法,就必须自己显式声明。
1.3 new 一个对象
有了类之后,就可以通过 new 关键字创建对象。
Person person = new Person();这行代码表示根据 Person 类创建一个 Person 对象,并将对象的引用赋值给变量 person。
可以简单理解为:
Person            → 类

new Person()      → 创建 Person 对象

person → 保存对象引用的变量对象创建后,会在 JVM 管理的内存中为对象分配空间。
如果只是写一个简单的 Java 示例并直接运行,通常会通过 main() 方法作为程序入口。
main() 可以直接写在当前类中,也可以单独放到另外一个类中。
第一种:直接写在 Person 类中
public class Person {

    private String name;
    private int age;
    private int sex;

    private void eat() {
    }

    private void sleep() {
    }

    private void dadoudou() {
    }

    public static void main(String[] args) {

        // 创建 Person 对象
        Person person = new Person();

        // 成员变量没有手动赋值时,会使用对应类型的默认值
        System.out.println(person.name);
        System.out.println(person.age);
        System.out.println(person.sex);
    }
}输出结果:
null
0
0因为对象创建完成后,成员变量如果没有显式赋值,会先使用默认值:
引用类型    → null

int         → 0

boolean     → false

char → '\u0000'这种写法用来写 Demo、测试代码没有问题,不过真实项目中一般不会把业务类和程序入口混在一起。
第二种:单独创建一个类作为程序入口
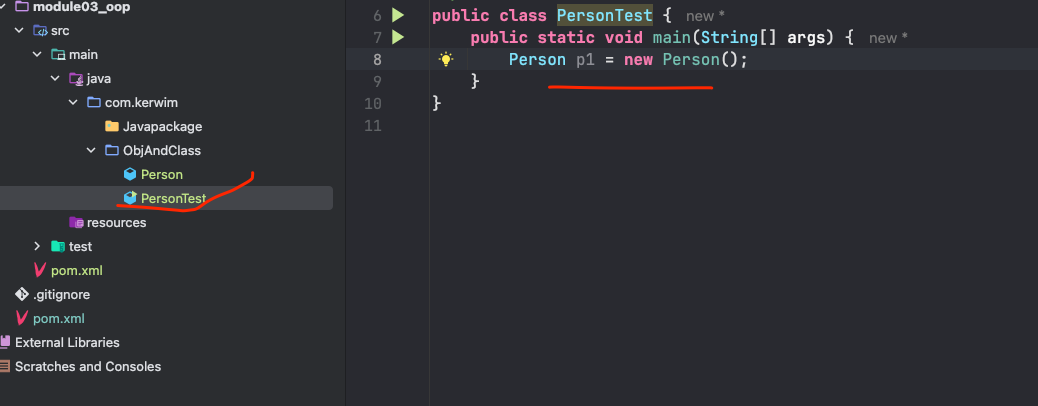
例如:
public class Person {

    private String name;
    private int age;
    private int sex;

    private void eat() {
    }

    private void sleep() {
    }

    private void dadoudou() {
    }
}再单独创建一个类:
public class Application {

    public static void main(String[] args) {

        // 创建 Person 对象
        Person person = new Person();
    }
}实际开发中更常见的是这种方式:
Person
    ↓
负责描述 Person 对象本身


Application / XxxApplication
    ↓
负责程序启动这样类的职责会更清楚,业务类就是业务类,启动类就是启动类,不会全部堆在一起。
1.4 初始化对象
在前面的例子中,我们创建了一个 Person 对象,但没有给它的成员变量手动赋值:
Person person = new Person();此时输出:
null
0
0这是因为 Java 会为对象的成员变量提供默认值:
String 等引用类型  → null
int                → 0
boolean            → false
char → '\u0000'严格来说,并不是对象“没有初始化”,而是这些成员变量没有进行显式赋值,所以使用了 Java 提供的默认值。
那我们该怎么给 Person 对象中的字段赋值呢?
1.4.1 通过对象的引用变量
最直接的方式,就是创建对象之后,通过对象的引用变量给字段赋值。
public class Person {

    private String name;
    private int age;
    private int sex;

    public static void main(String[] args) {

        // 创建 Person 对象
        Person person = new Person();

        // 通过对象引用给成员变量赋值
        person.name = "kerwim";
        person.age = 18;
        person.sex = 1;

        System.out.println(person.name);
        System.out.println(person.age);
        System.out.println(person.sex);
    }
}这里的:
person就是指向 Person 对象的引用变量。
见下图:
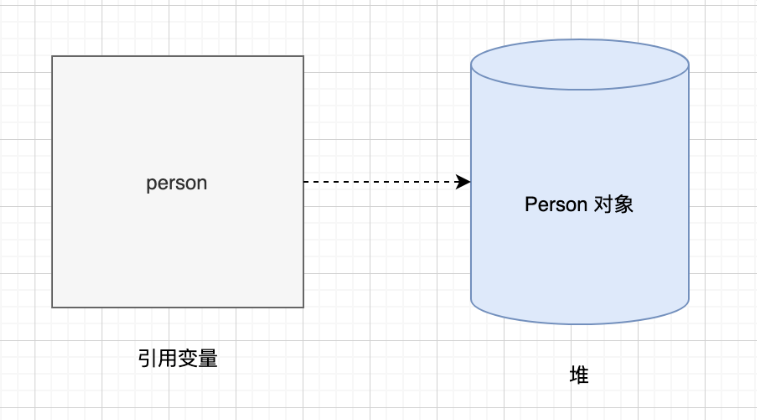
通过这个引用,就可以访问对象中的成员变量:
person.name = "kerwim";
person.age = 18;
person.sex = 1;输出结果:
kerwim
18
11.4.2 通过方法初始化
也可以专门定义一个方法,用来统一给对象中的字段赋值。
public class Person2 {

    private String name;
    private int age;
    private int sex;

    public void initialize(String n, int a, int s) {
        name = n;
        age = a;
        sex = s;
    }

    public static void main(String[] args) {

        Person2 person2 = new Person2();

        // 通过方法给对象中的字段赋值
        person2.initialize("kerwim", 18, 1);

        System.out.println(person2.name);
        System.out.println(person2.age);
        System.out.println(person2.sex);
    }
}这里新增了一个:
initialize()方法,在对象创建之后,通过传入参数统一完成字段赋值:
person2.initialize("kerwim", 18, 1);这种方式比一个字段一个字段地赋值更集中,不过实际开发中,创建对象时通常还会更多地使用构造方法、Setter 或 Builder 等方式。
1.4.3 通过构造方法初始化
还可以直接通过构造方法,在创建对象时完成字段赋值。
public class Person3 {

    private String name;
    private int age;
    private int sex;

    public Person3(String name, int age, int sex) {
        this.name = name;
        this.age = age;
        this.sex = sex;
    }

    public static void main(String[] args) {

        // 创建对象的同时完成字段赋值
        Person3 person3 = new Person3("kerwim", 18, 1);

        System.out.println(person3.name);
        System.out.println(person3.age);
        System.out.println(person3.sex);
    }
}这种方式比较常见,直接在 new 对象的时候把初始化数据传进去:
new Person3("kerwim", 18, 1);构造方法接收到参数后,再赋值给成员变量:
this.name = name;
this.age = age;
this.sex = sex;其中 this 表示当前对象,后面会单独介绍。
所以这三种方式可以简单理解为:
先创建对象,再一个个赋值
        ↓
person.name = ...


先创建对象,再调用方法赋值
        ↓
person.initialize(...)


创建对象的同时传入数据
        ↓
new Person(...)1.4.4 匿名对象
再补充一个概念:匿名对象。
通常我们创建对象时,会使用一个引用变量保存它:
Person person = new Person();而下面这种写法没有使用变量保存对象的引用:
new Person();这种对象通常称为匿名对象。
也可以直接使用匿名对象调用方法:
new Person2().initialize("kerwim", 18, 1);这里创建完对象之后立刻调用了 initialize(),但没有把这个对象保存到一个变量中。
因此,在当前代码中后面也就无法再通过一个已有变量继续访问这个对象。
匿名对象通常适合只需要临时使用一次的场景。
1.5. 关于对象一些小知识
1.5.1 抽象的历程
编程语言本身就是一种抽象。
我们不需要每次都去关心 CPU 指令、内存地址这些底层细节,而是通过变量、方法、类、对象等更高层的概念来描述和解决问题。抽象做得越好,能够组织和处理的问题也就越复杂。
Smalltalk 是早期非常有代表性的面向对象语言,对后来包括 Java 在内的很多语言都有影响。它的面向对象思想可以概括为几个基本特征:
- 万物皆对象。
- 程序可以看作多个对象之间相互协作、发送消息。
- 对象可以包含其他对象,通过组合构建更复杂的结构。
- 对象通过类创建,也就是类的实例。
- 同一类型的对象可以接收相同的请求,并表现出相应的行为。
可以简单总结为:
状态 + 行为 + 标识 = 对象其中:
状态 → 对象当前保存的数据
行为 → 对象能够执行的操作
标识 → 用来区分不同对象例如一个 Person 对象:
Person

状态:
name
age
sex

行为:
eat()
sleep()
work()面向对象做的事情,本质上就是把现实世界或者业务系统中的事物,抽象成程序中的一个个对象。
1.5.2 对象具有接口
现实中很多对象都可以按照共同的特征进行分类。
例如:
张三
李四
王五虽然是三个不同的人,但都可以归为:
Person在 Java 中,可以使用 class 定义这样一种类型:
public class Person {

    private String name;
    private int age;

    public void eat() {
    }

    public void sleep() {
    }
}Person 类描述了一类对象共同拥有的状态和行为,而通过这个类可以创建很多不同的对象:
Person person1 = new Person();
Person person2 = new Person();
Person person3 = new Person();所以从这个角度来说,类也可以理解为一种自定义的数据类型。
对象能够接收哪些请求,由它对外提供的方法决定。
例如:
person.eat();
person.sleep();调用者只需要知道:
这个对象能做什么
方法应该怎么调用至于 eat()、sleep() 内部到底怎么实现,并不需要调用者知道。
这里说的“接口”,更多指的是对象对外暴露的能力,并不单指 Java 中 interface 关键字定义的接口。
可以简单理解为:
调用者
   ↓
调用对象提供的方法
   ↓
对象自己完成内部逻辑这也是面向对象里很重要的一点:
对外提供能力,对内隐藏实现。
1.5.3 访问权限修饰符
类的编写者可以看作 API 的提供者,而使用这个类的人就是 API 的调用者。
例如 JDK 给我们提供了大量基础类:
String
ArrayList
HashMap
Thread这些类是 JDK 提供给我们的 API,我们平时写代码,本质上就是在不断调用这些 API。
当然,我们自己写一个类提供给其他模块或者其他开发者使用时,也就变成了 API 的提供者。
API 的设计通常不会把内部所有东西都暴露出去,而是只开放外部真正需要使用的部分。
这样做主要有两个好处:
- 防止调用者直接操作不应该接触的内部实现。
- 内部实现发生变化时,尽量不影响外部调用方式。
这就涉及 Java 的访问权限修饰符。
Java 中常见的访问权限有:
public
protected
默认(package-private)
private大致可以理解为:
| 修饰符 | 访问范围 |
|---|---|
public | 所有地方都可以访问 |
protected | 同包可以访问,子类也可以访问 |
| 默认 | 只能在同一个包中访问 |
private | 只能在当前类内部访问 |
例如:
public class Person {

    // 只允许 Person 内部直接访问
    private String name;

    // 对外提供访问方式
    public String getName() {
        return name;
    }
}外部代码不能直接操作:
person.name;而是通过:
person.getName();来访问。
这种做法可以把内部实现隐藏起来,只暴露需要提供给外部使用的部分。
1.5.4 组合
除了继承之外,面向对象还有一种非常常见的代码复用方式:组合(Composition)。
组合就是把一个已经存在的类,作为另一个类的成员变量。
例如:
public class Engine {

    public void start() {
        System.out.println("发动机启动");
    }
}再定义一个 Car:
public class Car {

    private Engine engine = new Engine();

    public void start() {
        engine.start();
    }
}这里:
Car 拥有 Engine因此可以说它们之间是:
has-a关系。
也就是:
Car has an Engine组合的好处是,可以直接复用已经存在的类,而不需要把所有功能重新写一遍。
实际开发中,组合的使用非常普遍。
1.5.5 继承
继承(Inheritance) 是 Java 面向对象中非常重要的一个概念。
子类可以通过 extends 继承父类:
public class Animal {

    protected String name;

    public void eat() {
        System.out.println("吃东西");
    }
}定义一个子类:
public class Dog extends Animal {

    public void bark() {
        System.out.println("汪汪");
    }
}Dog 继承 Animal 后,就可以使用父类中允许子类访问的成员:
Dog dog = new Dog();

dog.eat();
dog.bark();继承可以让子类复用父类已有的代码,同时还可以在父类基础上增加自己的功能。
例如:
Animal
├── Dog
├── Cat
└── Bird又比如图形:
Shape
├── Circle
├── Rectangle
└── Triangle这些子类都属于某一种 Shape,因此这种关系通常称为:
is-a例如:
Circle is a Shape

Dog is an Animal子类不仅可以继承父类的方法,还可以重写父类已有的方法,让同一个方法在不同子类中表现出不同的行为。
这也就引出了后面的多态。
5.6 多态
多态后面还会详细介绍,这里先通过一个简单例子理解它是什么。
先定义一个父类 Shape:
public class Shape {

    public void draw() {
        System.out.println("绘制形状");
    }
}定义一个 Circle:
public class Circle extends Shape {

    @Override
    public void draw() {
        System.out.println("绘制圆形");
    }
}再定义一个 Line:
public class Line extends Shape {

    @Override
    public void draw() {
        System.out.println("绘制线条");
    }
}测试一下:
public class Test {

    public static void main(String[] args) {

        // 父类引用指向 Line 对象
        Shape shape1 = new Line();

        // 实际执行 Line 的 draw()
        shape1.draw();

        // 父类引用指向 Circle 对象
        Shape shape2 = new Circle();

        // 实际执行 Circle 的 draw()
        shape2.draw();
    }
}运行结果:
绘制线条
绘制圆形这里有一个很有意思的地方:
Shape shape1 = new Line();
Shape shape2 = new Circle();shape1 和 shape2 的引用类型都是:
Shape但是调用:
shape1.draw();
shape2.draw();最终执行的却分别是:
Line.draw()

Circle.draw()也就是说:
同样是
Shape类型的引用,因为实际指向的对象不同,调用同一个draw()方法时,可以表现出不同的行为。
这就是 Java 中的多态(Polymorphism)。
可以简单理解为:
同一个父类引用
        ↓
可以指向不同的子类对象
        ↓
调用同一个方法
        ↓
执行不同子类的实现例如:
Shape shape

      ↓

┌──────────┬──────────┬──────────┐
│ Circle   │ Line     │ Triangle │
│ draw()   │ draw()   │ draw()   │
└──────────┴──────────┴──────────┘至于多态的实现条件、向上转型、动态绑定等内容,后面再详细展开。
2. package 包
2.1 概述(什么是包)
前面的代码中,我们经常会把类命名为:
Person
Student
Hello
Arrays这些名字本身都比较常见。
如果在团队开发中,小明写了一个 Person 类,小红也写了一个 Person 类,现在又需要同时使用这两个类,就会出现类名冲突的问题。
再比如,我们自己写了一个 Arrays 类,而 JDK 中本身也存在:
java.util.ArraysJava 通过 包(package) 来解决这类命名冲突。
包可以理解为 Java 中的一种命名空间。
一个类通常都会属于某个包,而我们平时看到的:
Person只是类的简单名称。
真正能够唯一确定一个类的是:
包名 + 类名也就是全限定类名(Fully Qualified Class Name)。
例如:
ming.Person

hong.Person

mr.jun.Arrays

java.util.Arrays虽然都有可能叫 Person 或 Arrays,但因为包名不同,所以它们实际上是不同的类。
在 Java 源文件中,可以通过 package 声明当前类所属的包。
例如小明的 Person.java:
package ming;

public class Person {
}小军的 Arrays.java:
package mr.jun;

public class Arrays {
}对于 JVM 和 Java 编译器来说:
ming.Person

hong.Person是两个完全不同的类。
包还可以使用多层结构,例如:
java.util

java.util.concurrent

com.kerwim.user

com.kerwim.order不同层级之间使用:
.进行分隔。
需要注意:
包名看起来有层级,但包之间并不存在父子继承关系。
例如:
java.util

java.util.zip是两个不同的包。
java.util 中的类并不会因为名称上的层级关系,就自动拥有访问 java.util.zip 中类的权限。
如果一个类没有声明 package:
public class Person {
}那么它就属于默认包(Default Package)。
默认包容易造成代码组织混乱,在正式项目中通常不推荐使用。
Java 源文件的目录结构通常也会和包结构保持一致。
例如:
package mr.jun;

public class Arrays {
}对应的目录通常为:
src
└── mr
    └── jun
└── Arrays.java假设项目结构如下:
package_sample
└── src
    ├── hong
    │   └── Person.java
    │
    ├── ming
    │   └── Person.java
    │
    └── mr
        └── jun
└── Arrays.java那么:
hong.Person
ming.Person
mr.jun.Arrays分别对应各自的包结构。
编译后的 .class 文件通常也会保持对应的目录结构:
package_sample
└── bin
    ├── hong
    │   └── Person.class
    │
    ├── ming
    │   └── Person.class
    │
    └── mr
        └── jun
└── Arrays.class如果使用命令行,可以在 src 目录中执行:
javac -d ../bin ming/Person.java hong/Person.java mr/jun/Arrays.java其中:
-d ../bin表示将编译得到的 .class 文件按照包结构输出到 bin 目录。
不过现在实际开发基本都会使用 IntelliJ IDEA 等 IDE,源码目录、包结构以及编译输出通常都会自动处理,不需要手动执行这些命令。
2.2 包的作用域
除了用于解决类名冲突,包还和 Java 的访问权限有关。
如果字段或者方法没有使用:
public
protected
private进行修饰,那么它使用的就是默认访问权限,也叫:
package-private这种成员只能被同一个包中的类访问。
例如:
package hello;

public class Person {

    // 默认访问权限
    void hello() {
        System.out.println("Hello!");
    }
}Main 也位于 hello 包中:
package hello;

public class Main {

    public static void main(String[] args) {

        Person person = new Person();

        // Main 和 Person 在同一个包中,因此可以访问
        person.hello();
    }
}由于两个类都属于:
hello所以 Main 可以直接调用:
person.hello();如果 Main 位于其他包中,那么默认访问权限的方法就不能直接访问。
2.3 导入包
在一个类中,经常需要使用其他包中的类。
例如:
ming.Person需要使用:
mr.jun.Arrays最直接的方式就是写完整类名:
package ming;

public class Person {

    public void run() {

        // 使用完整类名
        mr.jun.Arrays arrays = new mr.jun.Arrays();
    }
}这种写法虽然没有问题,但如果一个类被频繁使用,每次都写完整包名会比较麻烦。
因此可以通过:
import提前导入类。
例如:
package ming;

import mr.jun.Arrays;

public class Person {

    public void run() {

        // 导入之后可以直接使用简单类名
        Arrays arrays = new Arrays();
    }
}也可以使用:
import mr.jun.*;表示导入 mr.jun 包中可以访问的类型。
例如:
package ming;

import mr.jun.*;

public class Person {

    public void run() {

        Arrays arrays = new Arrays();
    }
}不过:
import mr.jun.*;只会匹配当前包中的类型,并不会自动导入子包。
例如:
mr.jun

mr.jun.util是两个不同的包。
所以:
import mr.jun.*;不会自动导入:
mr.jun.util中的类。
实际开发中一般更推荐明确导入具体类:
import mr.jun.Arrays;这样代码的依赖关系会更加清楚。
Java 还支持:
import static用于导入一个类中的静态字段或者静态方法。
例如:
package main;

import static java.lang.System.out;

public class Main {

    public static void main(String[] args) {

        // 相当于 System.out.println()
        out.println("Hello, world!");
    }
}也可以写成:
import static java.lang.System.*;不过实际项目中 import static 一般只在比较适合的场景使用,不会为了少写几个字符到处使用。
当编译器遇到一个简单类名时,例如:
String
Format
Person它会根据当前代码中的包信息和 import 声明来确定这个类到底是谁。
例如:
package test;

import java.text.Format;

public class Main {

    public static void main(String[] args) {

        // 使用完整类名
        java.util.List list;

        // 通过 import 导入
        Format format = null;

        // java.lang 包中的类可以直接使用
        String text = "hello";

        System.out.println(text);
    }
}这里:
java.util.List使用的是完整类名。
Format来自:
import java.text.Format;而:
String
System位于:
java.langJava 会自动让 java.lang 包中的类型可用,所以通常不需要手动写:
import java.lang.String;
import java.lang.System;同一个包中的类也可以直接使用,不需要额外 import。
例如:
hello.Person
hello.Main在 Main 中可以直接:
Person person = new Person();不过需要注意:
自动可用的是
java.lang包本身,并不是它的所有子包。
例如:
java.lang.reflect仍然需要手动导入:
import java.lang.reflect.Method;如果两个类的简单名称相同:
mr.jun.Arrays

java.util.Arrays那么不能同时通过简单类名区分它们。
通常只能导入其中一个:
import java.util.Arrays;另一个使用完整类名:
mr.jun.Arrays arrays = new mr.jun.Arrays();这样就可以避免冲突。
2.4 包的最佳实践
为了尽量避免不同项目之间出现包名冲突,Java 项目通常使用倒置域名作为包名前缀。
例如:
org.apache

org.apache.commons

com.google

com.alibaba

com.kerwim假如自己的域名是:
noctiflorous.cn那么包名前缀就可以设计成:
cn.noctiflorous然后再按照项目和业务模块继续划分:
cn.noctiflorous.user

cn.noctiflorous.order

cn.noctiflorous.product现在实际项目中更常见的形式通常类似:
com.company.project.module例如:
com.kerwim.mall.user

com.kerwim.mall.order

com.kerwim.mall.product包名一般全部使用小写字母。
另外,自己定义类时尽量不要和 JDK 中非常常见的类重名。
例如不建议自己随意定义:
String
System
Object
Runtime
List
Arrays
BigInteger否则即使通过包名能够区分,也很容易给代码阅读和导包带来困扰。
2.5 小结
Java 中的 package 主要用于组织代码和避免类名冲突。
可以简单记住:
package
    ↓
定义类所属的包


import
    ↓
让其他包中的类可以使用简单类名


完整类名
    ↓
包名 + 类名例如:
Person只是简单类名,而:
com.kerwim.user.Person才是完整类名。
另外需要记住:
java.lang中的常用类可以直接使用,例如:
String
System
Object
Integer而其他 JDK 包中的类通常需要导入,例如:
import java.util.List;
import java.util.ArrayList;
import java.math.BigDecimal;
import java.time.LocalDateTime;包名通常推荐使用倒置域名的方式:
com.company.project再按照项目中的模块和功能继续向下划分。
3. Java变量
3.1 变量概述
变量可以理解为程序运行过程中用来保存数据的“容器”。
在 Java 中,变量在声明时需要指定对应的数据类型。Java 的数据类型主要分为两类:
基本数据类型
引用数据类型例如:
int data = 88;其中:
int   → 变量的数据类型
data  → 变量名
88 → 变量保存的值根据变量声明的位置和作用范围,可以将变量分为:
- 局部变量
- 成员变量(实例变量)
- 静态变量(类变量)
3.2 局部变量
定义在方法、构造方法或者代码块内部的变量称为局部变量。
例如:
/**
 * 局部变量
 */
public class LocalVariable {

    public static void main(String[] args) {

        // 局部变量
        int a = 10;
        int b = 10;
        int c = a + b;

        System.out.println(c);
    }
}其中:
a
b
c都是局部变量,它们只能在当前 main() 方法的作用域中使用。
局部变量有几个特点:
- 声明在方法、构造方法或代码块内部。
- 只能在所属的作用域内访问。
- 不能使用
public、protected、private等访问权限修饰符。 - 生命周期通常随着对应方法或代码块的执行开始和结束。
- 没有默认值,使用之前必须先进行初始化。
例如下面的代码无法通过编译:
public static void main(String[] args) {

    int age;

    // age 还没有初始化,无法直接使用
    System.out.println(age);
}必须先赋值:
int age = 18;

System.out.println(age);3.3 成员变量
定义在类内部、方法外部的变量称为成员变量。
如果成员变量没有使用 static 修饰,也可以称为:
实例变量(Instance Variable)或者:
字段(Field)例如:
/**
 * 成员变量
 */
public class InstanceVariable {

    // 成员变量 / 实例变量
    int data = 88;

    public static void main(String[] args) {

        // 创建对象
        InstanceVariable iv = new InstanceVariable();

        // 通过对象访问实例变量
        System.out.println(iv.data);
    }
}输出结果:
88这里:
InstanceVariable iv = new InstanceVariable();iv 是一个引用变量,它保存了 InstanceVariable 对象的引用。
通过:
iv.data就可以访问这个对象中的实例变量。
成员变量有几个特点:
- 声明在类中,但位于方法、构造方法和代码块之外。
- 每个对象都拥有自己的一份实例变量。
- 可以使用
public、protected、private等访问权限修饰符。 - 实际开发中通常会把成员变量设置为
private,再通过方法对外提供访问。 - 成员变量可以在声明时赋值,也可以通过构造方法、Setter 等方式赋值。
- 成员变量具有默认值。
常见默认值:
| 数据类型 | 默认值 |
|---|---|
byte、short、int、long | 0 |
float、double | 0.0 |
boolean | false |
char | '\u0000' |
| 引用类型 | null |
例如:
public class Person {

    private String name;
    private int age;
    private boolean enabled;

    public static void main(String[] args) {

        Person person = new Person();

        System.out.println(person.name);
        System.out.println(person.age);
        System.out.println(person.enabled);
    }
}输出:
null
0
false3.4 静态变量
使用 static 修饰的成员变量称为:
静态变量也叫:
类变量(Class Variable)例如:
/**
 * 静态变量
 */
public class StaticVariable {

    // 静态变量
    static int data = 99;

    public static void main(String[] args) {

        // 推荐通过类名访问静态变量
        System.out.println(StaticVariable.data);
    }
}输出结果:
99静态变量属于类本身,而不是某一个具体对象。
因此不需要创建对象,就可以直接通过:
类名.静态变量进行访问。
例如:
StaticVariable.data静态变量和实例变量最大的区别可以理解为:
实例变量
    ↓
属于对象
    ↓
每个对象都有自己的一份


静态变量
    ↓
属于类
    ↓
所有对象共享同一份例如:
public class User {

    // 每个对象都有自己的 name
    String name;

    // 所有 User 对象共享 count
    static int count;
}创建多个对象:
User user1 = new User();
User user2 = new User();
User user3 = new User();可以简单理解为:
user1 → name
user2 → name
user3 → name

        ↓

User.count → 所有对象共享静态变量有几个特点:
- 使用
static关键字修饰。 - 属于类,而不是某一个具体对象。
- 一个类只维护一份静态变量,所有对象共享。
- 可以通过
类名.变量名直接访问。 - 和实例变量一样具有默认值。
- 可以在声明时初始化,也可以在静态代码块中初始化。
例如:
public class Config {

    static String name;

    static {
        name = "kerwim";
    }
}3.5 常量
在 Java 中,如果一个变量的值初始化之后不允许再次修改,可以使用:
final进行修饰。
例如:
final double PI = 3.14;一旦赋值之后:
PI = 3.14159;就会编译报错。
final 变量可以是局部变量,也可以是成员变量。
而在实际开发中,我们通常把:
static final修饰的变量称为类常量。
例如:
public static final double PI = 3.1415926;常量主要有两个作用:
- 避免程序中反复出现没有含义的固定值。
- 给固定值一个有意义的名字,提高代码可读性和维护性。
例如,与其直接写:
if (direction == 0) {
}不如定义:
public static final int UP = 0;
public static final int DOWN = 1;然后使用:
if (direction == UP) {
}含义会更加清楚。
Java 编码规范通常约定:
常量名使用全大写字母,多个单词之间使用下划线分隔。
例如:
MAX_SIZE

DEFAULT_TIMEOUT

MAX_RETRY_COUNT来看一个完整示例:
/**
 * final 变量和常量
 */
public class FinalVariable {

    // final 实例变量
    final String HELLO = "你好";

    // 类常量
    static final String WORLD = "世界";

    public static void main(String[] args) {

        FinalVariable fv = new FinalVariable();

        System.out.println(fv.HELLO);

        // 静态常量推荐通过类名访问
        System.out.println(FinalVariable.WORLD);
    }
}输出结果:
你好
世界需要注意:
final String HELLO = "你好";表示这个变量初始化之后不能再重新赋值。
而:
static final String WORLD = "世界";表示它既属于类本身,又只能赋值一次,因此更符合通常所说的“常量”。
可以简单总结:
局部变量
    ↓
定义在方法、构造方法或代码块内部


实例变量
    ↓
定义在类中、方法外
属于具体对象


静态变量
    ↓
使用 static 修饰
属于类,所有对象共享


常量
    ↓
使用 final 修饰
赋值后不能再次修改4. Java方法
4.1 方法概述
方法(Method)是 Java 中用于完成某个特定功能的一段代码。
把一段逻辑封装成方法之后,可以在需要的时候重复调用,而不需要反复编写相同的代码,从而提高代码的复用性、可读性和维护性。
例如:
public static int add(int a, int b) {
    return a + b;
}调用方法:
int result = add(10, 20);

System.out.println(result);输出结果:
30方法中的代码并不会在定义时立即执行,只有在方法被调用时才会执行。
Java 中最常见的方法就是:
public static void main(String[] args) {
}main() 是普通 Java 程序的入口方法,JVM 会从这里开始执行程序。
根据不同的使用场景,Java 中还会遇到多种方法,例如:
实例方法
静态方法
抽象方法
本地方法
构造方法后面再分别介绍。
4.2 如何声明方法
一个普通 Java 方法通常由以下几个部分组成:
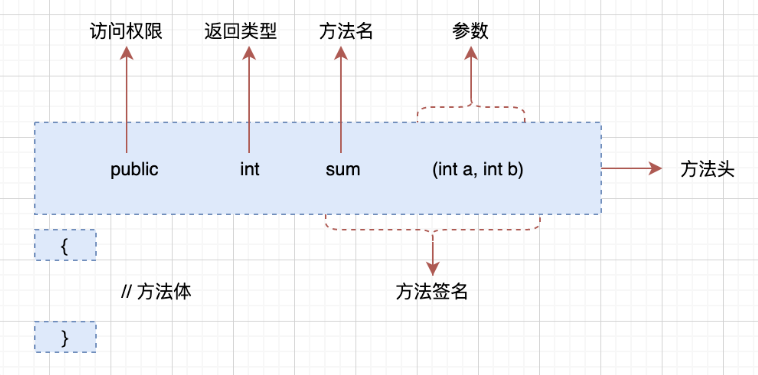
例如:
public int subtract(int a, int b) {
    return a - b;
}可以拆分为:
public       → 访问权限修饰符

int          → 返回值类型

subtract     → 方法名

(int a,
 int b)      → 参数列表

{ ... } → 方法体访问权限
访问权限决定这个方法可以在哪些地方被调用。
Java 常见的访问权限有:
public
protected
默认(package-private)
private它们的访问范围大致如下:
| 修饰符 | 访问范围 |
|---|---|
public | 所有地方都可以访问 |
protected | 同包可以访问,不同包中的子类也可以访问 |
| 默认 | 只能在同一个包中访问 |
private | 只能在当前类内部访问 |
例如:
public void eat() {
}

private void sleep() {
}eat() 可以被外部调用,而 sleep() 只能在当前类内部使用。
返回类型
返回类型表示方法执行完成后会返回什么类型的数据。
例如:
public int add(int a, int b) {
    return a + b;
}返回的是:
int如果方法不需要返回任何结果,则使用:
void例如:
public void sayHello() {
    System.out.println("Hello");
}返回值可以是基本数据类型,也可以是引用类型:
int
double
boolean

String
Person
List<String>方法名
方法名应该尽量能够体现这个方法要完成的功能。
例如:
add()
subtract()
getUser()
saveOrder()
deleteProduct()Java 方法名通常采用小驼峰命名法:
第一个单词首字母小写
后面的单词首字母大写例如:
getName()
findUserById()
calculateTotalPrice()方法名通常使用动词或者动词短语,让人看到名字就大概知道这个方法是干什么的。
参数列表
参数用于给方法传递数据,写在方法名后面的 () 中。
例如:
public int add(int a, int b) {
    return a + b;
}这里:
int a
int b就是两个参数。
每个参数由:
参数类型 + 参数名组成。
多个参数之间使用逗号分隔:
public void createUser(
        String name,
        int age,
        String email) {
}如果方法不需要参数,括号可以为空:
public void sayHello() {
}方法签名
在 Java 中,方法签名主要由:
方法名 + 参数类型列表组成。
例如:
add(int, int)就是下面这个方法的签名:
public int add(int a, int b) {
    return a + b;
}需要注意:
返回值类型并不属于 Java 方法签名的一部分。
因此下面两个方法不能同时存在:
public int getData() {
    return 1;
}

public String getData() {
    return "1";
}虽然返回值类型不同,但它们的方法名和参数列表完全相同,因此编译器无法区分。
而下面这种写法是允许的:
public int add(int a, int b) {
    return a + b;
}

public double add(double a, double b) {
    return a + b;
}虽然方法名相同,但参数类型不同,因此属于两个不同的方法。
这种现象称为:
方法重载(Overload)后面会单独介绍。
方法体
方法体就是:
{
    // 具体代码
}用于编写真正需要执行的业务逻辑。
例如:
public int subtract(int a, int b) {

    // 执行减法运算
    int result = a - b;

    // 返回计算结果
    return result;
}整个方法的结构可以简单记成:
访问权限 返回类型 方法名(参数列表) {
    方法体
}例如:
public int add(int a, int b) {
    return a + b;
}4.3 方法的分类
从使用角度来看,方法可以简单分为两类:
- Java 或第三方类库已经提供好的方法。
- 开发者根据实际需求自己编写的方法。
4.3.1 预先定义的方法
Java 标准类库中已经提供了大量可以直接调用的方法,这些方法也可以称为标准类库方法。
例如:
String.length()

String.equals()

String.compareTo()

System.out.println()这些方法都已经由 JDK 提前实现好了,我们只需要按照要求传入参数并调用即可。
例如:
public class PredefinedMethodDemo {

    public static void main(String[] args) {

        // 调用 PrintStream 提供的 println() 方法
        System.out.println("kerwim,一名 Java 牛马");
    }
}其中:
System.out.println(...)最终调用的是 PrintStream 类提供的 println() 方法。
而:
main()比较特殊,它不是我们主动调用的普通类库方法,而是 Java 程序约定的入口方法,程序启动时由 JVM 调用。
使用 IntelliJ IDEA 等开发工具时,可以直接查看一个方法的声明、参数以及 Javadoc。
例如把鼠标放在 println() 方法上,就可以看到类似下面的信息:
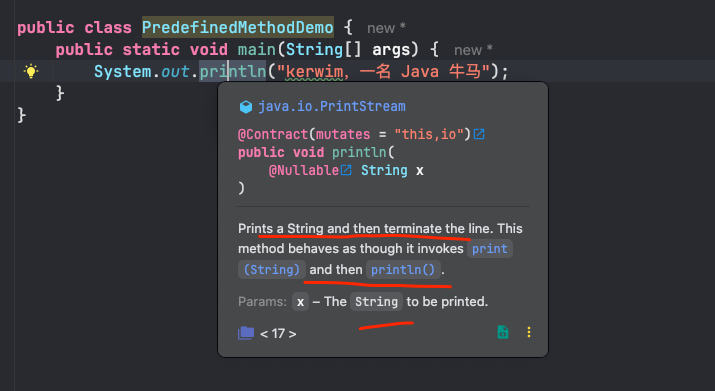
例如其中一个 println() 方法的声明:
public void println(String x)可以看出:
public     → 访问权限

void       → 没有返回值

println    → 方法名

String x → 参数标准类库最大的好处就是:
很多常见功能已经有人帮我们实现好了,直接调用即可,不需要每次重新编写。
Java 本身提供了非常丰富的标准类库,除此之外,实际开发中还会大量使用第三方类库。
例如:
Apache Commons

Hutool

Gson

Druid这些类库本质上也是别人提前帮我们封装好的代码。
实际开发并不是所有东西都要自己重新实现,合理使用成熟的类库可以明显提高开发效率。
当然,只会调用 API 还不够。随着经验增加,还需要逐渐理解常用 API 的设计思想和源码实现,这对排查问题、封装公共组件以及提升代码设计能力都会有帮助。
4.3.2 用户自定义方法
当现有方法无法直接满足我们的需求时,就可以自己定义方法。
例如定义一个方法,用于判断一个整数是奇数还是偶数:
/**
 * 判断一个整数是奇数还是偶数
 *
 * @param num 需要判断的数字
 */
public static void findEvenOdd(int num) {

    if (num % 2 == 0) {
        System.out.println(num + " 是偶数");
    } else {
        System.out.println(num + " 是奇数");
    }
}这个方法可以拆开来看:
public          → 访问权限

static          → 静态方法

void            → 没有返回值

findEvenOdd     → 方法名

int num → 参数方法定义完成后,就可以在需要的地方调用。
例如:
public class EvenOddDemo {

    public static void main(String[] args) {

        // 调用自定义方法
        findEvenOdd(10);
        findEvenOdd(11);
    }

    /**
     * 判断一个整数是奇数还是偶数
     *
     * @param num 需要判断的数字
     */
    public static void findEvenOdd(int num) {

        if (num % 2 == 0) {
            System.out.println(num + " 是偶数");
        } else {
            System.out.println(num + " 是奇数");
        }
    }
}输出结果:
10 是偶数
11 是奇数这里的:
findEvenOdd()使用了 static 修饰,因此它是一个静态方法。
静态方法属于类本身,不依赖某个具体对象,因此可以直接通过:
类名.方法名()进行调用:
EvenOddDemo.findEvenOdd(10);在同一个类的静态方法中,也可以直接写:
findEvenOdd(10);不需要先:
new EvenOddDemo();再调用。
所以可以简单理解为:
标准类库方法
    ↓
别人已经写好
    ↓
我们直接调用


自定义方法
    ↓
现有方法不能满足需求
    ↓
自己编写并调用4.4 什么是实例方法?
没有使用 static 关键字修饰,并且定义在类中的普通方法,称为实例方法。
实例方法属于对象,因此在调用实例方法之前,通常需要先创建类的对象。
例如:
public class InstanceMethodExample {

    public static void main(String[] args) {

        // 创建对象
        InstanceMethodExample example =
                new InstanceMethodExample();

        // 通过对象调用实例方法
        System.out.println(example.add(1, 2));
    }

    /**
     * 实例方法
     */
    public int add(int a, int b) {
        return a + b;
    }
}这里的:
add()就是一个实例方法。
调用时需要先创建:
new InstanceMethodExample();然后通过对象调用:
example.add(1, 2);实例方法可以直接访问当前对象中的实例变量和其他实例方法。
实际开发中经常见到的 Getter 和 Setter,通常也是实例方法。
例如:
public class Person {

    private String name;
    private int age;
    private int sex;

    /**
     * 获取 name
     */
    public String getName() {
        return name;
    }

    /**
     * 设置 name
     */
    public void setName(String name) {
        this.name = name;
    }

    /**
     * 获取 age
     */
    public int getAge() {
        return age;
    }

    /**
     * 设置 age
     */
    public void setAge(int age) {
        this.age = age;
    }

    /**
     * 获取 sex
     */
    public int getSex() {
        return sex;
    }

    /**
     * 设置 sex
     */
    public void setSex(int sex) {
        this.sex = sex;
    }
}通常:
Getter → 用于获取字段的值

Setter → 用于修改字段的值命名上一般遵循:
get + 字段名

set + 字段名例如:
getName()
setName()

getAge()
setAge()不过对于 boolean 类型的字段,Getter 也经常写成:
isEnabled()可以简单理解为:
实例方法
    ↓
属于对象
    ↓
通常需要先创建对象
    ↓
对象.方法()4.5 什么是静态方法?
使用 static 关键字修饰的方法称为静态方法。
静态方法属于类本身,而不是某一个具体对象,因此调用时不需要先创建对象。
例如:
/**
 * 静态方法
 */
public class StaticMethodExample {

    public static void main(String[] args) {

        // 在同一个类中可以直接调用静态方法
        System.out.println(add(1, 2));
    }

    /**
     * 静态方法
     */
    public static int add(int a, int b) {
        return a + b;
    }
}这里:
main()和:
add()都是静态方法。
不同的是,main() 是 Java 程序约定的入口方法,而 add() 是我们自己定义的普通静态方法。
静态方法可以直接通过类名调用:
StaticMethodExample.add(1, 2);不需要:
new StaticMethodExample();可以简单理解为:
实例方法
    ↓
属于对象
    ↓
对象.方法()


静态方法
    ↓
属于类
    ↓
类名.方法()很多工具类都会提供大量静态方法,因为这些方法通常只负责完成某个功能,并不依赖某个具体对象的状态。
例如 Hutool 中就提供了很多这样的工具方法。
以计算 MD5 为例:
SecureUtil.md5("kerwim");以前可能需要自己去查找并编写一套 MD5 处理代码,而使用成熟的工具类后,可以直接调用已经封装好的方法。
这也是工具类常见的设计方式:
工具类
    ↓
提供大量 static 方法
    ↓
直接通过类名调用需要注意:
静态方法不能直接访问普通实例变量和实例方法,因为它属于类,而普通实例成员属于具体对象。
例如:
public class Person {

    private String name;

    public static void printName() {

        // 编译错误
        // System.out.println(name);
    }
}因为调用:
Person.printName();时,并没有确定具体是哪一个 Person 对象,所以自然也无法确定应该访问哪个对象的 name。
4.6 什么是抽象方法?
使用 abstract 修饰,并且没有方法体的方法,称为抽象方法。
例如:
abstract void display();抽象方法只规定:
这个方法必须存在但并不规定:
这个方法具体应该怎么实现抽象方法通常定义在抽象类中。
例如:
/**
 * 抽象类
 */
abstract class AbstractDemo {

    /**
     * 抽象方法
     */
    abstract void display();
}只要一个普通类继承了抽象类,并且自己不是抽象类,就必须实现父类中的抽象方法。
例如:
/**
 * 实现抽象方法
 */
public class MyAbstractDemo extends AbstractDemo {

    /**
     * 重写父类中的抽象方法
     */
    @Override
    void display() {
        System.out.println("重写了抽象方法");
    }

    public static void main(String[] args) {

        MyAbstractDemo demo =
                new MyAbstractDemo();

        demo.display();
    }
}输出结果:
重写了抽象方法这里父类:
AbstractDemo只规定:
display()必须存在。
而具体怎么实现,则交给子类决定:
@Override
void display() {
    System.out.println("重写了抽象方法");
}可以简单理解为:
抽象方法
    ↓
只定义“要做什么”
    ↓
不提供具体实现


子类
    ↓
继承抽象类
    ↓
实现“具体怎么做”例如:
abstract class Shape {

    abstract void draw();
}可以定义不同的子类:
class Circle extends Shape {

    @Override
    void draw() {
        System.out.println("画圆形");
    }
}class Rectangle extends Shape {
@Override
void draw() {
System.out.println("画矩形");
}
}父类只规定:
所有 Shape 都必须能够 draw()至于怎么画,则由不同的子类自己实现。
除了抽象类之外,接口中也可以声明抽象方法。抽象类和接口后面会单独详细介绍。
5. Java 可变参数
5.1 可变参数概述
可变参数(Varargs)是 Java 5 引入的功能,它允许一个方法接收任意数量的同类型参数。
语法如下:
数据类型... 参数名例如:
/**
 * 可变参数示例
 */
public class VariableParametersDemo {

    public static void main(String[] args) {

        print("我");
        print("我", "是");
        print("我", "是", "靓");
        print("我", "是", "靓", "崽");
    }

    public static void print(String... strs) {

        // 遍历所有传入的参数
        for (String str : strs) {
            System.out.print(str);
        }

        System.out.println();
    }
}输出结果:
我
我是
我是靓
我是靓崽这里的:
String... strs表示 print() 方法可以接收:
0 个 String
1 个 String
2 个 String
3 个 String
...因此下面这些写法都是合法的:
print();

print("我");

print("我", "是");

print("我", "是", "靓", "崽");关于可变参数,阿里巴巴开发手册中也有相关规约:
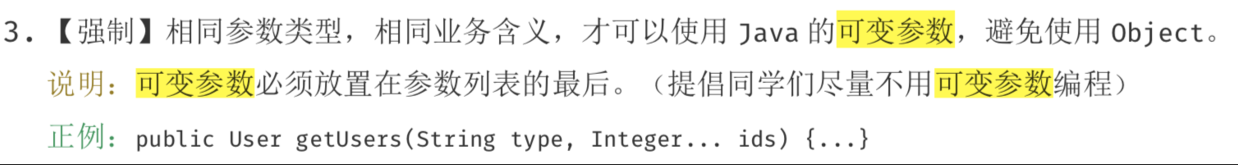
需要注意:
可变参数必须放在参数列表的最后,并且一个方法最多只能声明一个可变参数。
例如:
public void test(String name, int... nums) {
}这是合法的。
而:
public void test(int... nums, String name) {
}无法通过编译。
IDE 也会直接提示错误:
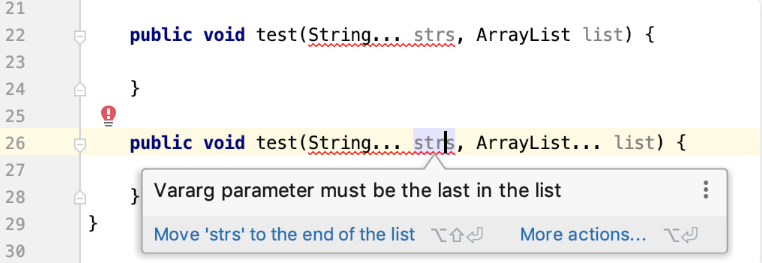
5.2 可变参数的本质
可变参数看起来比较特殊,但本质上其实还是数组。
例如:
public static void print(String... strs) {
}在方法内部:
strs本质上可以按照:
String[]来使用。
可以简单理解为,当调用:
print("我", "是", "靓", "崽");时,编译器会帮助我们组织成类似:
new String[] {
        "我",
        "是",
        "靓",
        "崽"
}然后把这个数组传给方法。
因此,可变参数方法也可以直接接收一个数组:
/**
 * 可变参数示例
 */
public class VariableParametersDemo2 {

    public static void main(String[] args) {

        print(new String[]{"我"});

        print(new String[]{"我", "是"});

        print(new String[]{"我", "是", "靓"});

        print(new String[]{"我", "是", "靓", "崽"});
    }

    public static void print(String... strs) {

        for (String str : strs) {
            System.out.print(str);
        }

        System.out.println();
    }
}所以:
print("我", "是");和:
print(new String[]{"我", "是"});对于可变参数方法来说都可以正常调用。
但是反过来不行。
如果方法本身声明的是普通数组:
public static void print(String[] strs) {
}那么只能:
print(new String[]{"我", "是"});不能直接写:
print("我", "是");因此可以简单记成:
可变参数
    ↓
本质是数组
    ↓
既可以传多个独立参数
也可以直接传数组5.3 可变参数的常见应用
当一个方法需要接收数量不确定、类型相同的参数时,可变参数就比较方便。
Java 标准类库中就有很多类似的设计。
例如 String.format():
System.out.println(
        String.format("年纪是: %d", 18)
);

System.out.println(
        String.format(
                "年纪是: %d 名字是: %s",
                18,
                "kerwim"
        )
);输出结果:
年纪是: 18
年纪是: 18 名字是: kerwim其中:
%d → 十进制整数

%s → 字符串String.format() 可以接收数量不固定的格式化参数,这就是可变参数非常典型的使用场景。
实际项目中的日志框架也经常使用类似的设计。
例如 SLF4J:
protected Logger logger =
        LoggerFactory.getLogger(getClass());

logger.debug(
        "名字是 {}",
        member.getName()
);

logger.debug(
        "名字是 {},年龄是 {}",
        member.getName(),
        member.getAge()
);通过:
{}作为占位符,然后把实际参数依次传进去。
相关 API 中也可以看到可变参数形式的方法,例如:
public void debug(
        String format,
        Object... arguments
);这样就可以根据日志中的占位符数量,传入不同数量的参数。
5.4 可变参数的注意事项
虽然可变参数使用起来比较方便,但也有一些需要注意的地方。
1)必须放在参数列表最后
例如:
public static void print(
        String prefix,
        String... strs) {
}这是合法的。
而下面这种写法:
public static void print(
        String... strs,
        String suffix) {
}无法通过编译。
因此:
普通参数
普通参数
普通参数
可变参数是合法的参数顺序。
2)一个方法只能有一个可变参数
下面这种写法是不允许的:
public static void print(
        String... strs,
        Integer... nums) {
}因为编译器无法判断参数应该如何进行划分。
3)避免容易产生歧义的可变参数重载
例如:
public static void print(String... strs) {

    for (String str : strs) {
        System.out.print(str);
    }
}

public static void print(Integer... ints) {

    for (Integer num : ints) {
        System.out.print(num);
    }
}此时调用:
print(null);编译器就无法确定应该调用:
print(String... strs)还是:
print(Integer... ints)因此会出现方法调用歧义。
如果确实存在这种重载,就需要明确告诉编译器参数类型。
例如:
public static void main(String[] args) {

    String[] strs = null;

    Integer[] ints = null;

    print(strs);

    print(ints);
}

public static void print(String... strs) {

    // 使用前注意判空
}

public static void print(Integer... ints) {

    // 使用前注意判空
}这样编译器就能够根据变量类型确定应该调用哪个方法。
不过需要注意:
String[] strs = null;传入的确实是 null。
如果方法内部直接:
for (String str : strs) {
}就会抛出:
NullPointerException所以需要先进行判空:
public static void print(String... strs) {

    if (strs == null) {
        return;
    }

    for (String str : strs) {
        System.out.println(str);
    }
}5.5 小结
可变参数最核心的特点可以简单记成:
String... strs
      ↓
本质是 String[]
      ↓
可以传 0 ~ N 个参数
      ↓
也可以直接传 String[]使用时还需要记住两个规则:
一个方法最多只能有一个可变参数

可变参数必须位于参数列表最后可变参数适合参数数量确实不固定的场景,但也不要为了少写几个参数就到处使用,否则容易让方法调用变得不够明确。
6. Java native 本地方法
6.1 概述
6.1 本地方法概述
之前我们学习的大多数方法,方法体都是使用 Java 代码编写的。
但 Java 中还有一类比较特殊的方法,叫做:
本地方法(Native Method)也就是使用:
native关键字修饰的方法。
例如 Thread 类中的:
private native void start0();Object 类中也有多个本地方法:
public final native Class<?> getClass();

public native int hashCode();

protected native Object clone()
throws CloneNotSupportedException;可以看到,native 方法只有方法声明,没有普通 Java 方法那样的方法体。
例如:
public native int hashCode();而不是:
public int hashCode() {
    // Java 代码实现
}这类方法的具体实现通常不由 Java 代码完成,而是通过 JVM 或底层本地代码来实现。
之所以需要 native 方法,是因为有些功能需要直接和:
操作系统
底层硬件
JVM
C / C++ 本地库进行交互,而这些事情单纯依靠 Java 代码并不一定方便完成。
Java 想要调用这些本地代码,就需要一套连接 Java 和本地代码的机制。
这套机制就是:
JNI
Java Native Interface
Java 本地接口所以理解 native 方法之前,先认识 JNI 会比较容易。
6.2 JNI:Java Native Interface
在介绍 native 方法之前,先了解一下 JNI。
JNI 全称:
Java Native Interface中文一般叫:
Java 本地接口正常情况下,我们直接使用 Java 就可以完成大部分开发工作,但有些场景需要 Java 和本地代码进行交互,例如:
- Java 标准类库无法直接提供某些底层能力。
- 已经存在使用 C、C++ 等语言编写的本地库,需要在 Java 中继续使用。
- 需要调用操作系统、驱动、硬件设备等平台相关能力。
- 某些底层功能已经由高性能本地库实现,希望直接复用,而不是重新使用 Java 实现。
这些问题归根到底就是:
Java 如何调用由其他语言编写的本地代码?
JNI 就是为了解决这个问题而提供的一套标准接口。
从 Java 1.1 开始,JNI 成为 Java 平台的一部分,它允许 Java 代码和本地代码之间进行交互,最常见的就是:
Java
↓
JNI
↓
C / C++
↓
操作系统 / 本地库 / 硬件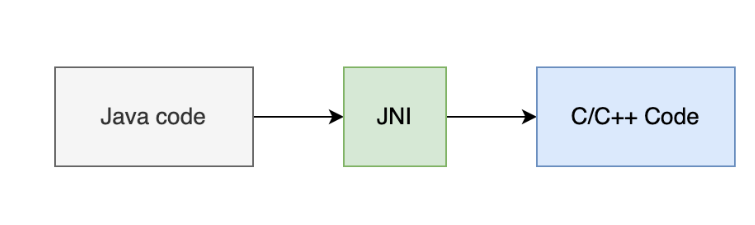
例如 Java 中声明一个本地方法:
public native void nativeMethod();Java 代码本身并没有提供这个方法的方法体,真正的实现可以由 C、C++ 等本地代码完成。
因此可以简单理解:
Java 方法
↓
JNI
↓
本地方法
↓
操作系统或本地库JNI 并不是只能单向调用。
除了:
Java → 本地代码本地代码也可以通过 JNI 提供的接口:
本地代码 → JVM → Java 对象 / Java 方法所以 JNI 实际上承担的是 Java 世界和本地代码之间的桥梁。
6.2.1 JNI 与跨平台
Java 一个非常重要的特点就是跨平台:
Write Once, Run Anywhere普通 Java 字节码只要存在对应平台的 JVM,一般就可以运行。
但是引入 JNI 后,情况就不一样了。
例如:
Windows → .dll
Linux → .so
macOS → .dylib不同操作系统使用的本地库格式和底层实现可能不同。
因此使用 JNI 后,本地代码通常需要针对不同的平台分别编译。
也就是说:
纯 Java
↓
跨平台能力较强
Java + JNI
↓
Java 部分仍然跨平台
↓
本地代码需要适配不同平台JNI 规定的是 Java 与本地代码之间的调用方式,而不是让编译好的 C/C++ 本地库本身自动拥有跨平台能力。
6.2.2 JNI 的缺点
JNI 能够让 Java 获得更强的底层访问能力,但也会带来一些问题。
1. 降低跨平台能力
使用本地库之后,需要针对:
Windows
Linux
macOS
不同 CPU 架构分别提供对应的本地实现。
2. 增加开发和维护成本
项目中同时存在:
Java
C / C++
JNI调试、编译和部署都会比纯 Java 项目复杂。
3. 本地代码可能影响 JVM 稳定性
普通 Java 代码受到 JVM 的内存管理和安全机制保护。
而 C/C++ 可以直接操作:
指针
内存
本地资源如果本地代码出现:
非法内存访问
内存越界
野指针严重时可能导致整个 JVM 进程直接崩溃。
4. JNI 调用本身也存在开销
JNI 并不意味着:
用了 C/C++ 就一定比 Java 快Java 和本地代码之间切换本身也存在调用成本。
现代 JVM 的 JIT 编译器已经可以对很多 Java 代码进行非常强的优化,因此一般不会为了所谓的“性能更高”就随意把普通 Java 方法改成 JNI。
更常见的使用场景还是:
复用已有本地库
访问操作系统底层能力
调用硬件或驱动
使用 Java 难以直接实现的底层功能因此实际项目中,如果确实需要使用 JNI,通常会把本地调用集中封装在少量类中:
业务代码
↓
Java 封装层
↓
JNI
↓
Native Library尽量避免本地代码和业务代码到处耦合。
6.2.3 补充:现代 Java
JNI 目前仍然是 Java 与本地代码交互的重要机制,JDK 自身也存在大量 native 方法。
不过现代 Java 还提供了:
Foreign Function & Memory API也就是 FFM API,用于更方便地访问本地函数和本地内存。
它可以看作 Java 在本地代码交互方面提供的一套更新的方案。
不过对于理解:
native以及 JDK 中大量历史实现来说,JNI 仍然是必须了解的基础。
所以这里先记住它们之间的关系:
native
↓
声明这是一个本地方法
JNI
↓
Java 与本地代码之间进行交互的一套标准机制6.3 使用 C 语言实现本地方法
前面已经知道,native 方法本身只负责声明,真正的实现可以放在 Java 之外。
下面通过一个最简单的 Hello JNI 示例,用 C 语言实现 Java 中声明的本地方法。
整个过程大致如下:
Java 声明 native 方法
↓
编译 Java 文件
↓
生成 JNI 头文件 .h
↓
使用 C 实现 native 方法
↓
编译 C 代码生成动态链接库
↓
Java 加载动态链接库
↓
调用 native 方法具体步骤:
① 编写包含 native 方法的 Java 类
② 使用 javac 编译 Java 类
③ 使用 javac -h 生成 JNI 头文件
④ 使用 C / C++ 实现头文件中声明的本地方法
⑤ 编译 C / C++ 代码,生成动态链接库
⑥ Java 加载动态链接库并调用 native 方法本节使用 macOS 演示。
为了把重点放在 JNI 本身,这个例子暂时不声明 package,所有文件放在同一个 testjni 目录下操作。
例如:
/Users/mac/Documents/LearnCode/framework-learn-javase/
module03_oop/src/main/java/com/kerwim/testjni后面的命令都在 testjni 目录中执行。
6.3.1 编写 HelloJNI.java
创建:
HelloJNI.java内容如下:
public class HelloJNI {
static {
// 加载名为 hello 的本地动态库
// macOS 下对应 libhello.dylib
System.loadLibrary("hello");
}
/**
* 声明本地方法
*/
private native void helloJNI();
public static void main(String[] args) {
// 创建对象并调用本地方法
new HelloJNI().helloJNI();
}
}重点有两个地方。
首先:
private native void helloJNI();使用 native 声明这个方法。
可以看到,它只有:
方法声明没有:
方法体也就是说:
private native void helloJNI();真正的实现并不写在 Java 中,后面会使用 C 语言实现。
第二个是:
System.loadLibrary("hello");它的作用是加载本地动态链接库。
这里传入的是:
hello而不是完整文件名。
JVM 会根据当前操作系统映射成对应的动态库名称,例如:
macOS
↓
libhello.dylib
Linux
↓
libhello.so
Windows
↓
hello.dll这里使用静态代码块:
static {
System.loadLibrary("hello");
}是为了在类初始化时先加载动态库。
否则调用:
helloJNI();时,如果 JVM 找不到对应的本地实现,就会抛出:
UnsatisfiedLinkError所以整个关系其实是:
helloJNI()
↓
Java 中只有 native 声明
↓
System.loadLibrary("hello")
↓
加载 libhello.dylib
↓
在动态库中找到对应的 C 实现6.3.2 编译 HelloJNI.java
进入 testjni 目录:
cd /Users/mac/Documents/LearnCode/framework-learn-javase/module03_oop/src/main/java/com/kerwim/testjni执行:
javac HelloJNI.java编译成功后会生成:
HelloJNI.class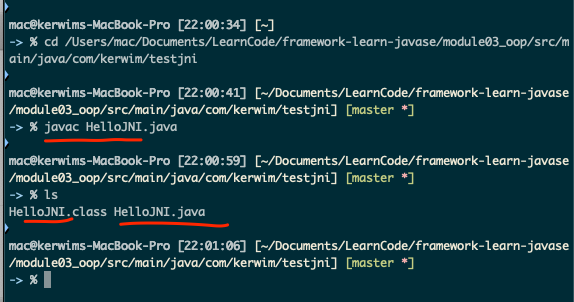
此时目录大致变成:
testjni
├── HelloJNI.java
└── HelloJNI.class6.3.3 生成 JNI 头文件
早期 Java 可以使用:
javah -jni HelloJNI生成 JNI 头文件。
不过:
javah在 JDK 9 中已经被废弃,并在后续 JDK 中移除。
现代 JDK 直接使用:
javac -h . HelloJNI.java其中:
-h .表示:
将生成的 JNI 头文件输出到当前目录。
执行完成后,会得到:
HelloJNI.h因此目录变成:
testjni
├── HelloJNI.java
├── HelloJNI.class
└── HelloJNI.h实际上:
javac -h . HelloJNI.java本身也会完成 Java 编译,因此实际操作时可以直接执行这条命令,不一定需要提前单独执行一次 javac HelloJNI.java。
打开生成的 HelloJNI.h,可以看到类似下面的内容:
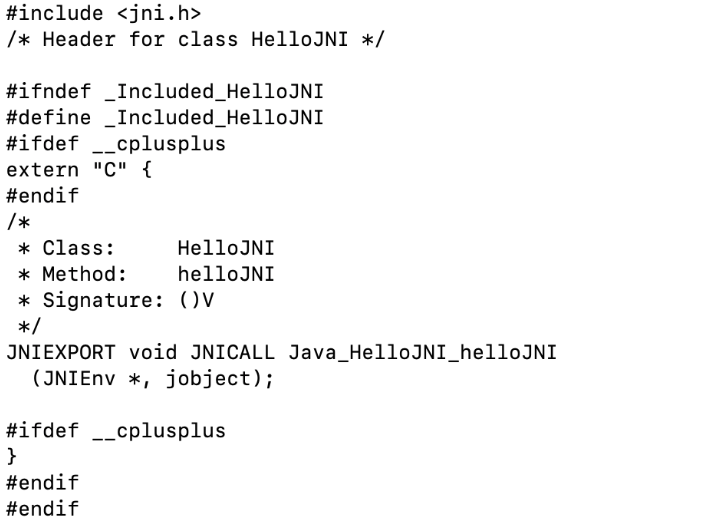
核心部分大致类似:
JNIEXPORT void JNICALL Java_HelloJNI_helloJNI
(JNIEnv *, jobject);第一次看 JNI 头文件可能比较陌生,不过这里暂时不用研究里面所有细节。
现在只需要知道:
这个
.h文件由 JDK 根据 Java 中的 native 方法自动生成,C 代码按照它规定的函数签名进行实现即可。
另外不要自己猜 JNI 函数名。
如果 Java 类存在包名,例如:
package com.kerwim.testjni;那么生成出来的函数名还会包含包路径。
所以实际开发中直接以:
javac -h生成的头文件为准。
6.3.4 使用 C 语言实现本地方法
接下来创建:
HelloJNI.c引入刚才生成的头文件,并实现 helloJNI() 对应的本地函数:
#include <stdio.h>
#include <jni.h>
#include "HelloJNI.h"
/**
* 实现 Java 中的 HelloJNI.helloJNI()
*/
JNIEXPORT void JNICALL Java_HelloJNI_helloJNI(
JNIEnv *env,
jobject obj) {
printf("Hello, JNI!\n");
}这里:
#include <jni.h>引入 JNI 提供的核心头文件。
而:
#include "HelloJNI.h"引入刚才通过:
javac -h自动生成的头文件。
真正实现本地方法的是:
JNIEXPORT void JNICALL Java_HelloJNI_helloJNI(
JNIEnv *env,
jobject obj)它对应 Java 中的:
private native void helloJNI();可以简单理解为:
Java
HelloJNI.helloJNI()
↓
JNI
↓
C
Java_HelloJNI_helloJNI()其中两个参数:
JNIEnv *env表示 JNI 提供的运行环境,可以通过它调用 JNI 的各种功能。
jobject obj表示调用当前实例方法的 Java 对象,也就是类似 Java 中的:
this因为我们的:
helloJNI()是实例方法,所以这里是 jobject。
这些参数后面真正深入 JNI 时再详细研究。
6.3.5 编写编译脚本 compile.sh
C 文件不能直接被 JVM 执行,还需要将它编译成 macOS 可以加载的动态链接库:
libhello.dylib创建:
compile.sh内容如下:
#!/bin/bash
# 出现错误时立即停止脚本
set -e
# 编译 C 文件并生成 macOS 动态链接库
gcc \
-I"$JAVA_HOME/include" \
-I"$JAVA_HOME/include/darwin" \
-dynamiclib \
-o libhello.dylib \
HelloJNI.c这里几个参数分别表示:
-I"$JAVA_HOME/include"告诉 C 编译器 JNI 公共头文件所在的位置。
例如:
jni.h就在这里。
而:
-I"$JAVA_HOME/include/darwin"表示加入 macOS 平台相关的 JNI 头文件目录。
darwin 是 macOS 对应的平台目录。
然后:
-dynamiclib表示在 macOS 上生成动态链接库。
最后:
-o libhello.dylib指定最终生成的文件名:
libhello.dylib因此不需要再额外执行:
cp libhello.dylib .因为这个命令已经直接把动态库生成到了当前目录。
需要保证环境变量:
JAVA_HOME已经正确配置。
可以通过:
echo $JAVA_HOME查看。
在 macOS 上也可以使用:
/usr/libexec/java_home查看当前 JDK 路径。
6.3.6 执行编译脚本
执行:
sh compile.sh如果没有报错,当前目录会生成:
libhello.dylib此时目录大致如下:
testjni
├── HelloJNI.java
├── HelloJNI.class
├── HelloJNI.h
├── HelloJNI.c
├── compile.sh
└── libhello.dylib到这里:
Java 声明
C 实现
动态库都已经准备完成。
6.3.7 运行 HelloJNI
最后运行 Java 程序。
为了明确告诉 JVM:
动态库就在当前目录可以执行:
java -Djava.library.path=. HelloJNI程序启动后:
static {
System.loadLibrary("hello");
}会找到:
libhello.dylib随后执行:
new HelloJNI().helloJNI();JVM 会通过 JNI 找到 C 中对应的实现:
Java_HelloJNI_helloJNI(...)最终输出:
Hello, JNI!整个执行过程可以串起来看:
HelloJNI.java
↓
native void helloJNI()
↓
javac -h
↓
HelloJNI.h
↓
HelloJNI.c
↓
gcc / clang
↓
libhello.dylib
↓
System.loadLibrary("hello")
↓
Java 调用 helloJNI()
↓
JNI 找到本地实现
↓
C 执行 printf()
↓
Hello, JNI!这样就完成了一次最基本的:
Java → JNI → C调用。
6.4 JNI 调用 C 的流程图
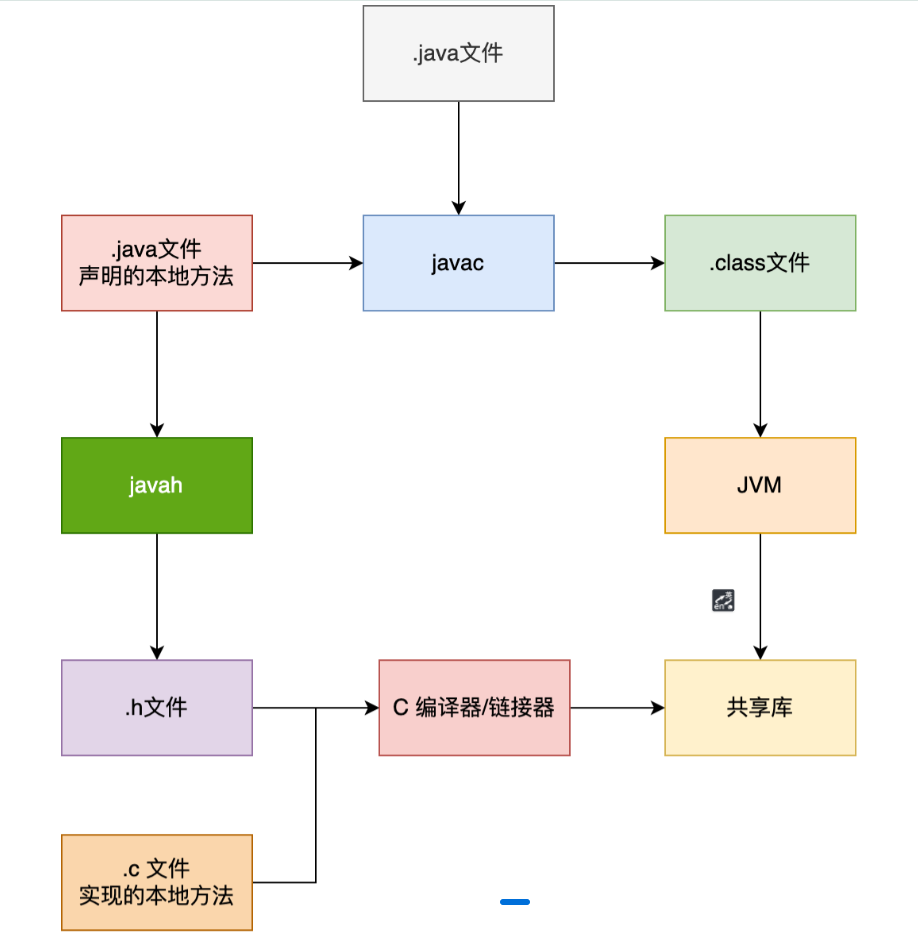
这张图描述的就是 Java 调用本地方法时,从源码到动态库再到 JVM 执行的完整流程。
整体可以分成两条线:
Java 代码
↓
.class
↓
JVM
以及
native 方法声明
↓
.h 头文件
↓
C / C++ 实现
↓
动态链接库
↓
JVM 加载先看 Java 这一边。
我们在 .java 文件中声明本地方法:
private native void helloJNI();然后通过:
javac HelloJNI.java编译 Java 源代码,生成:
HelloJNI.class.class 文件最终由 JVM 加载和执行。
但是 native 方法只有声明:
private native void helloJNI();没有 Java 方法体,所以 JVM 运行到这里时,还需要去外部寻找真正的方法实现。
另一边就是本地方法的实现。
早期 JDK 可以使用:
javah HelloJNI根据 Java 中声明的 native 方法生成:
HelloJNI.h头文件中会声明 JNI 对应的 C 函数。
然后我们自己编写:
HelloJNI.c实现这个函数:
JNIEXPORT void JNICALL Java_HelloJNI_helloJNI(
JNIEnv *env,
jobject obj) {
printf("Hello, JNI!\n");
}接着通过 C 编译器和链接器:
HelloJNI.h
+
HelloJNI.c
↓
C 编译器 / 链接器
↓
共享库最终生成不同操作系统对应的动态链接库:
Windows → hello.dll
Linux → libhello.so
macOS → libhello.dylibJava 程序启动后,通过:
System.loadLibrary("hello");把这个动态库加载到 JVM 中。
因此,当 Java 执行:
helloJNI();时,真正的调用过程就是:
Java 代码
↓
native 方法
↓
JNI
↓
动态链接库
↓
C / C++ 实现所以图中最关键的两条路线可以概括成:
.java
↓
javac
↓
.class
↓
JVM以及:
native 方法
↓
JNI 头文件
↓
C / C++ 实现
↓
编译、链接
↓
共享库
↓
JVM 加载需要注意的是,图中的:
javah属于旧版 JDK 的做法。
现代 JDK 已经改成:
javac -h . HelloJNI.java也就是说现在通常可以直接:
.java
↓
javac -h
↓
.class + .h再继续编写 C/C++ 实现并生成动态链接库。
6.5 native 关键字
到这里,native 关键字就比较好理解了。
native 用来修饰方法,表示:
这个方法在 Java 中只有声明,具体实现由 JVM 或本地代码提供。
最常见的情况,就是通过 JNI 调用 C、C++ 编写的本地代码。
例如:
public native int hashCode();或者:
private native void start0();这类方法只有方法声明,没有 Java 方法体。
可以简单理解为:
Java
↓
native 方法
↓
JNI / JVM
↓
本地代码6.5.1 native的基本语法
例如:
public native int getValue();使用 native 时需要注意:
native只能修饰方法,不能修饰字段。native写在返回类型之前,与public、private、static等修饰符的前后顺序通常没有强制要求。native方法没有 Java 方法体,以;结束。native方法不能同时使用abstract修饰。- 返回值和参数都可以使用正常的 Java 类型。
例如:
public native int getValue();
private native void start0();
protected native Object clone()
throws CloneNotSupportedException;下面这种写法是不允许的:
public native void test() {
// native 方法不能有 Java 方法体
}应该写成:
public native void test();实际开发中,我们经常会在 JDK 源码里看到 native 方法,例如:
Object.getClass()
Object.hashCode()
Object.clone()
Thread.start0()对于普通 Java 开发来说,看到这些方法时,通常先知道:
这个方法是做什么的以及:
它的具体实现不在普通 Java 源码中就足够了。
除非需要研究 JVM、JNI、本地库或者 JDK 底层实现,否则一般没有必要继续追到 C/C++ 层。
需要注意的是,native 方法并不一定是“操作系统帮我们实现”。
更准确地说,它的实现可能来自:
JVM
JDK 自带的本地库
操作系统相关代码
第三方 C / C++ 动态库所以最终可以简单记成:
native
↓
Java 中只声明
↓
具体实现位于 Java 代码之外7. Java构造方法
7.1 概述(构造方法)
![[Pasted image 20260913205430.png]]
在 Java 中,构造方法(Constructor)是一种比较特殊的方法,主要用来在创建对象时完成初始化。
每次使用:
new创建对象时,都会调用对应的构造方法。
例如:
Person person = new Person();这里:
Person()就是构造方法。
构造方法有几个明显的特点:
方法名必须和类名相同
没有返回值类型
不能写 void
创建对象时自动调用例如:
public class Person {
public Person() {
System.out.println("Person 对象被创建");
}
}执行:
Person person = new Person();时,会自动调用:
Person()输出:
Person 对象被创建如果一个类中没有显式声明任何构造方法,Java 编译器会自动提供一个默认无参构造方法。
例如:
public class Person {
}可以理解为编译器自动补充了:
public class Person {
public Person() {
}
}但是需要注意:
只有当类中一个构造方法都没有声明时,编译器才会自动提供默认无参构造。
如果我们自己定义了有参构造:
public class Person {
private String name;
public Person(String name) {
this.name = name;
}
}那么编译器就不会再自动提供:
public Person() {
}此时下面的代码会编译报错:
Person person = new Person();必须按照已经存在的构造方法创建对象:
Person person = new Person("kerwim");构造方法最常见的作用,就是在对象创建时给成员变量设置初始值。
例如:
public class Person {
private String name;
private int age;
public Person(String name, int age) {
this.name = name;
this.age = age;
}
}创建对象:
Person person = new Person("kerwim", 18);对象一创建出来,就已经有了对应的初始状态:
name = kerwim
age = 18所以可以简单理解为:
new
↓
创建对象
↓
调用构造方法
↓
完成对象初始化构造方法通常可以分为:
无参构造方法
有参构造方法不过“无参”和“有参”只是按照参数数量来区分,构造方法本身还可以继续涉及:
构造方法重载
this()
super()
构造方法调用顺序后面再分别介绍。
7.2 创建构造方法的规则
构造方法虽然看起来和普通方法很像,但它有自己的一套规则。
主要有以下几点:
- 构造方法的名称必须和类名完全相同。
- 构造方法没有返回值类型,连
void也不能写。 - 构造方法不能使用
abstract、static、final、synchronized修饰。 - 构造方法可以使用
public、protected、private或默认访问权限。 - 一个类可以定义多个构造方法,只要参数列表不同,也就是构造方法可以重载。
构造方法的基本格式:
public class ClassName {
// 无参构造
public ClassName() {
}
// 有参构造
public ClassName(String name) {
}
}7.2.1 为什么不能使用 abstract?
abstract 表示方法只声明、不提供具体实现,需要由子类重写。
例如:
public abstract void test();但构造方法的作用就是:
创建对象
↓
执行初始化逻辑创建当前对象时必须能够真正执行构造方法,所以构造方法不能是抽象的。
另外,构造方法本身也不会被子类继承和重写。
因此下面这种写法是不允许的:
public abstract Person();7.2.2 为什么不能使用 static?
static 修饰的成员属于类本身:
Person.test();而构造方法是用于创建和初始化具体对象的:
new Person();两者的含义本身就是不同的,因此构造方法不能使用 static 修饰。
下面这种写法无法通过编译:
public static Person() {
}7.2.3 为什么不能使用 final?
final 修饰方法的主要作用是:
不允许子类重写这个方法。
例如:
public final void test() {
}但是构造方法本来就:
不会被继承
也不能被重写所以给构造方法加 final 没有意义,Java 语法也不允许这样做。
public final Person() {
}无法通过编译。
7.2.4 为什么不能使用 synchronized?
Java 也不允许直接使用 synchronized 修饰构造方法:
public synchronized Person() {
}会直接编译报错。
构造对象时,这个对象本身还处于初始化过程中,因此 Java 没有提供“同步构造方法”这种语法。
如果构造过程中确实存在需要同步的代码,可以在构造方法内部使用同步代码块:
public Person() {
synchronized (SomeClass.class) {
// 需要同步执行的代码
}
}不过普通业务代码中很少需要这样做。
7.2.5 构造方法不能写 void
这一点比较容易写错。
假设有一个 Demo 类:
public class Demo {
void Demo() {
}
}乍一看:
void Demo()名称和类名完全一样,好像是一个构造方法。
但实际上它只是一个普通方法。
因为它写了返回值类型:
void只要存在返回值类型,它就不是构造方法。
真正的构造方法应该写成:
public class Demo {
public Demo() {
}
}也就是说:
Demo()是构造方法。
而:
void Demo()是一个名字恰好叫 Demo 的普通方法。
有意思的是,如果类中只有:
void Demo() {
}那么从 Java 编译器的角度来看,这个类仍然没有声明任何构造方法。
因此编译器还会自动提供默认无参构造。
可以理解为:
public class Demo {
// 编译器自动提供的默认无参构造
public Demo() {
}
// 我们自己写的普通方法
void Demo() {
}
}所以:
Demo demo = new Demo();调用的是:
public Demo()而不是:
void Demo()7.2.6 构造方法可以使用访问权限修饰符
构造方法可以使用:
public
protected
默认(package-private)
private不同的访问权限会决定:
哪些地方可以通过这个构造方法创建对象。
例如:
public class Person {
public Person() {
}
}public 构造方法可以在外部正常创建对象:
Person person = new Person();如果改成:
public class Person {
private Person() {
}
}那么类的外部就不能直接:
new Person();这种写法在一些特殊设计中很常见,例如:
单例模式
工具类
静态工厂方法例如工具类经常会把构造方法设为 private:
public class StringUtils {
private StringUtils() {
}
public static boolean isEmpty(String str) {
return str == null || str.isEmpty();
}
}这样就可以阻止外部创建没有意义的工具类对象:
// 无法调用
// new StringUtils();所以构造方法的访问权限并不只是普通的语法问题,它还可以控制:
对象能不能被创建
对象可以在哪里被创建7.3 创建构造方法的规则
构造方法虽然看起来和普通方法很像,但它有自己的一套规则。
主要有以下几点:
- 构造方法的名称必须和类名完全相同。
- 构造方法没有返回值类型,连
void也不能写。 - 构造方法不能使用
abstract、static、final、synchronized修饰。 - 构造方法可以使用
public、protected、private或默认访问权限。 - 一个类可以定义多个构造方法,只要参数列表不同,也就是构造方法可以重载。
构造方法的基本格式:
public class ClassName {
// 无参构造
public ClassName() {
}
// 有参构造
public ClassName(String name) {
}
}7.3.1 为什么不能使用 abstract?
abstract 表示方法只声明、不提供具体实现,需要由子类实现。
例如:
public abstract void test();但构造方法的作用是在创建对象时执行初始化逻辑:
创建对象
↓
调用构造方法
↓
完成初始化构造方法必须能够真正执行,因此不能声明为抽象方法。
另外,构造方法本身不会被子类继承,也不存在构造方法重写。
所以下面的写法是不允许的:
public abstract Person();7.3.2 为什么不能使用 static?
static 修饰的成员属于类本身,例如:
Person.test();而构造方法的作用是创建和初始化某一个具体对象:
new Person();构造方法依赖对象创建过程,因此不能使用 static 修饰。
下面这种写法无法通过编译:
public static Person() {
}7.3.3 为什么不能使用 final?
final 修饰普通方法时,表示:
子类不能重写这个方法。
例如:
public final void test() {
}但构造方法本身就不会被继承,也不能被重写。
因此给构造方法加 final 没有意义,Java 语法也不允许这样写:
public final Person() {
}7.3.4 为什么不能使用 synchronized?
Java 不允许直接使用 synchronized 修饰构造方法:
public synchronized Person() {
}这种写法会编译报错。
构造对象时,对象本身还处于初始化阶段,因此 Java 没有提供“同步构造方法”这种语法。
如果构造过程中确实有部分代码需要同步,可以在构造方法内部使用同步代码块:
public Person() {
synchronized (SomeClass.class) {
// 需要同步执行的代码
}
}不过普通业务代码中很少需要这样处理。
7.3.5 构造方法不能写 void
这一点比较容易写错。
假设有一个 Demo 类:
public class Demo {
void Demo() {
}
}乍一看:
void Demo()方法名和类名完全一样,好像是一个构造方法。
但实际上它只是一个普通方法。
因为它写了返回值类型:
void只要存在返回值类型,它就不是构造方法。
真正的构造方法应该写成:
public class Demo {
public Demo() {
}
}也就是说:
Demo()才是构造方法。
而:
void Demo()只是一个名字恰好叫 Demo 的普通方法。
如果类中只有:
void Demo() {
}那么从编译器的角度来看,这个类仍然没有显式声明任何构造方法。
因此编译器仍然会自动提供默认无参构造。
可以理解为:
public class Demo {
// 编译器自动提供的默认无参构造
public Demo() {
}
// 自己定义的普通方法
void Demo() {
}
}所以:
Demo demo = new Demo();调用的是:
public Demo()而不是:
void Demo()7.3.6 构造方法可以使用访问权限修饰符
构造方法可以使用:
public
protected
默认(package-private)
private不同的访问权限决定了:
哪些地方可以调用这个构造方法创建对象。
例如:
public class Person {
public Person() {
}
}public 构造方法可以在类的外部正常调用:
Person person = new Person();如果构造方法改成:
public class Person {
private Person() {
}
}那么类的外部就不能直接:
new Person();这种写法在一些特殊设计中比较常见,例如:
单例模式
工具类
静态工厂方法比如工具类通常不需要创建对象,就可以把构造方法设为 private:
public class StringUtils {
private StringUtils() {
}
public static boolean isEmpty(String str) {
return str == null || str.isEmpty();
}
}这样外部就无法:
new StringUtils();而只能直接使用静态方法:
StringUtils.isEmpty("kerwim");所以构造方法的访问权限不仅决定“能不能访问构造方法”,还决定了:
对象能不能被外部创建
对象可以在哪些位置被创建7.4 有参构造方法
带有参数的构造方法称为有参构造方法。
参数可以有一个,也可以有多个。
有参构造方法最常见的作用,就是在创建对象的时候,直接给对象的成员变量设置初始值。
例如:
/**
* 有参构造方法
*/
public class ParamConstructorPerson {
private String name;
private int age;
/**
* 有参构造
*/
public ParamConstructorPerson(
String name,
int age) {
this.name = name;
this.age = age;
}
public void out() {
System.out.println(
"姓名:" + name
+ ",年龄:" + age
);
}
public static void main(String[] args) {
ParamConstructorPerson p1 =
new ParamConstructorPerson(
"kerwim",
18
);
p1.out();
ParamConstructorPerson p2 =
new ParamConstructorPerson(
"kevin",
16
);
p2.out();
}
}输出结果:
姓名:kerwim,年龄:18
姓名:kevin,年龄:16这里的构造方法:
public ParamConstructorPerson(
String name,
int age) {
this.name = name;
this.age = age;
}有两个参数:
name
age因此在创建对象时,可以直接传入不同的数据:
new ParamConstructorPerson("kerwim", 18);
new ParamConstructorPerson("kevin", 16);这样每个对象在创建完成之后,就已经有了自己的初始状态:
p1
├── name = kerwim
└── age = 18
p2
├── name = kevin
└── age = 16这里的:
this.name = name;左边的:
this.name表示当前对象的成员变量。
右边的:
name表示构造方法接收到的参数。
也就是:
把传进来的 name
赋值给当前对象的 nameage 也是一样:
this.age = age;如果没有有参构造,也可以先创建对象,再通过 Setter 赋值。
例如:
Person person = new Person();
person.setName("kerwim");
person.setAge(18);而使用有参构造,可以直接写成:
Person person =
new Person("kerwim", 18);两种方式都可以给对象设置数据,只是使用场景不同。
可以简单理解为:
无参构造
↓
先创建对象
↓
之后再设置数据
有参构造
↓
创建对象的同时
↓
直接设置初始数据需要注意:
如果类中只声明了有参构造方法,编译器就不会再自动提供默认无参构造。
例如:
public class Person {
public Person(String name) {
}
}这时:
new Person();会编译报错。
只能按照已有的构造方法创建对象:
new Person("kerwim");如果既需要有参构造,也需要无参构造,就需要自己同时声明:
public class Person {
public Person() {
}
public Person(String name) {
}
}7.5 重载构造方法
和普通方法一样,构造方法也可以进行重载(Overload)。
所谓构造方法重载,就是:
在同一个类中定义多个构造方法,但它们的参数列表必须不同。
这里的“参数列表不同”不仅包括参数数量不同,也包括:
参数类型不同
参数顺序不同编译器会根据创建对象时传入的参数,决定调用哪一个构造方法。
例如:
/**
* 构造方法重载
*/
public class OverloadingConstructorPerson {
private String name;
private int age;
private int sex;
/**
* 三个参数的构造方法
*/
public OverloadingConstructorPerson(
String name,
int age,
int sex) {
this.name = name;
this.age = age;
this.sex = sex;
}
/**
* 两个参数的构造方法
*/
public OverloadingConstructorPerson(
String name,
int age) {
this.name = name;
this.age = age;
}
public void out() {
System.out.println(
"姓名:" + name
+ ",年龄:" + age
+ ",性别:" + sex
);
}
public static void main(String[] args) {
OverloadingConstructorPerson p1 =
new OverloadingConstructorPerson(
"kerwim",
18,
1
);
p1.out();
OverloadingConstructorPerson p2 =
new OverloadingConstructorPerson(
"kevin",
16
);
p2.out();
}
}当创建对象时传入三个参数:
new OverloadingConstructorPerson(
"kerwim",
18,
1
);编译器会匹配:
public OverloadingConstructorPerson(
String name,
int age,
int sex)而传入两个参数:
new OverloadingConstructorPerson(
"kevin",
16
);则会匹配:
public OverloadingConstructorPerson(
String name,
int age)所以可以理解为:
new Person("kerwim", 18)
↓
匹配 Person(String, int)
new Person("kerwim", 18, 1)
↓
匹配 Person(String, int, int)构造方法重载的作用,就是让创建对象的方式更加灵活。
例如同一个 Person 类,可以同时提供:
public Person() {
}
public Person(String name) {
}
public Person(String name, int age) {
}
public Person(String name, int age, int sex) {
}这样就可以根据需要选择不同的方式创建对象:
new Person();
new Person("kerwim");
new Person("kerwim", 18);
new Person("kerwim", 18, 1);需要注意:
构造方法的重载和普通方法重载规则基本一致,判断依据是参数列表,而不是返回值。
因为构造方法本身就没有返回值类型。
后面还可以通过:
this(...)在一个构造方法中调用另一个构造方法,减少重复代码。
7.6 构造方法和普通方法的区别
7.6.1 概述
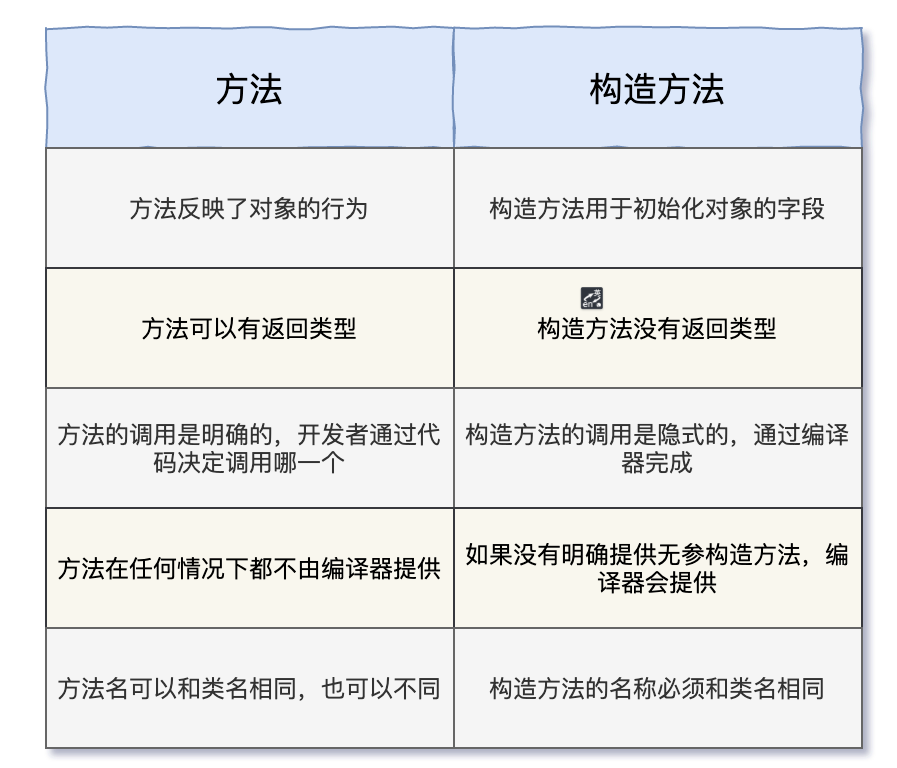
构造方法虽然写法上和普通方法比较像,但两者的用途完全不同。
普通方法主要描述对象能做什么,而构造方法主要负责对象创建时如何初始化。
可以直接对比来看:
| 对比项 | 普通方法 | 构造方法 |
|---|---|---|
| 主要作用 | 描述对象的行为,执行具体功能 | 创建对象时完成初始化 |
| 方法名 | 可以自由命名 | 必须和类名完全相同 |
| 返回值 | 可以有返回值,也可以使用 void | 没有返回值类型,连 void 都不能写 |
| 调用方式 | 通过对象、类名或其他方法主动调用 | 使用 new 创建对象时调用 |
| 是否自动提供 | 编译器不会自动提供普通方法 | 类中没有任何构造方法时,编译器会提供默认无参构造 |
| 是否可以重载 | 可以 | 可以 |
| 是否可以继承 | 普通实例方法可以被继承 | 构造方法不能被继承 |
| 是否可以重写 | 满足条件时可以被子类重写 | 不能被重写 |
static | 可以使用 | 不能使用 |
final | 可以使用 | 不能使用 |
abstract | 可以使用 | 不能使用 |
例如有一个 Person 类:
public class Person {
private String name;
/**
* 构造方法
*/
public Person(String name) {
this.name = name;
}
/**
* 普通方法
*/
public void sayHello() {
System.out.println("你好,我是 " + name);
}
}创建对象:
Person person = new Person("kerwim");执行:
new Person("kerwim");时,会调用:
Person(String name)完成对象初始化。
对象创建完成之后,再主动调用普通方法:
person.sayHello();整个过程可以理解为:
new Person("kerwim")
↓
调用构造方法
↓
初始化 name = "kerwim"
↓
Person 对象创建完成
↓
person.sayHello()
↓
执行普通方法7.6.2 构造方法负责初始化,普通方法负责行为
例如:
public class Car {
private String brand;
/**
* 创建汽车时初始化品牌
*/
public Car(String brand) {
this.brand = brand;
}
/**
* 汽车创建之后可以执行的行为
*/
public void start() {
System.out.println(brand + " 启动");
}
}使用:
Car car = new Car("BMW");
car.start();可以把两者的职责简单区分为:
构造方法
↓
这个对象创建出来时是什么状态?
普通方法
↓
这个对象创建出来之后能做什么?7.6.3 构造方法没有返回值类型
普通方法可以写:
public String getName() {
return name;
}也可以没有返回值:
public void sayHello() {
}但构造方法只能写:
public Person() {
}不能写:
public void Person() {
}因为一旦写了:
void它就变成了一个名字叫 Person 的普通方法,而不再是构造方法。
7.6.4 构造方法由 new 触发调用
普通方法需要我们主动调用:
person.sayHello();构造方法则是在创建对象时被调用:
Person person = new Person();这里真正调用的构造方法就是:
Person()所以不是“编译器自动调用构造方法”,更准确地说是:
使用
new创建对象时,会执行所匹配的构造方法。
编译器主要负责根据参数列表确定使用哪个构造方法,并在类没有声明任何构造方法时提供默认无参构造。
7.6.5 默认构造方法只会在特定情况下提供
普通方法无论有没有定义,编译器都不会主动帮我们添加。
但是构造方法比较特殊。
如果一个类中没有声明任何构造方法:
public class Person {
}编译器会自动提供一个默认无参构造,可以理解为:
public class Person {
public Person() {
}
}但是只要自己定义了任意构造方法:
public class Person {
public Person(String name) {
}
}编译器就不会再提供:
public Person() {
}7.6.6构造方法不能继承和重写
普通方法可以发生继承和重写:
class Animal {
public void eat() {
System.out.println("吃东西");
}
}class Dog extends Animal {
@Override
public void eat() {
System.out.println("狗吃东西");
}
}但是构造方法:
Animal()不会被:
Dog继承。
Dog 有自己的构造方法:
public Dog() {
}不过子类构造方法在执行时,会直接或间接调用父类构造方法,这部分后面讲 super() 时再详细介绍。
所以构造方法和普通方法最核心的区别可以记成:
构造方法
↓
对象创建时执行
↓
负责初始化对象
普通方法
↓
对象创建后按需调用
↓
负责完成具体功能一句话概括:
构造方法决定对象“出生时是什么样”,普通方法决定对象“出生后能做什么”。
7.7 复制对象
7.7.1 概述
有时候我们需要根据一个已经存在的对象,再创建一个内容相同的新对象。
例如:
Person p1 = new Person("kerwim", 18);希望再得到一个:
Person p2并且:
p1 和 p2 是两个不同的对象
但它们保存的数据相同需要先注意,下面这种写法并不是复制对象:
Person p2 = p1;它只是把 p1 中保存的引用赋值给了 p2。
此时:
p1 ──┐
├──→ 同一个 Person 对象
p2 ──┘也就是说:
p1 == p2结果为:
true如果真正需要创建一个新的对象,常见方式有:
- 通过复制构造方法
- 手动复制对象字段
- 通过
Object.clone()复制
7.7.2 通过复制构造方法
可以专门定义一个构造方法,让它接收一个同类型对象,然后把原对象中的数据复制到新对象中。
这种构造方法通常称为:
复制构造方法(Copy Constructor)例如:
package com.kerwim.Constructor;
/**
* 通过构造方法复制对象
*/
public class CopyConstructorPerson {
private String name;
private int age;
/**
* 普通有参构造
*/
public CopyConstructorPerson(
String name,
int age) {
this.name = name;
this.age = age;
}
/**
* 复制构造方法
*/
public CopyConstructorPerson(
CopyConstructorPerson person) {
this.name = person.name;
this.age = person.age;
}
public void out() {
System.out.println(
"姓名:" + name
+ ",年龄:" + age
);
}
public static void main(String[] args) {
CopyConstructorPerson p1 =
new CopyConstructorPerson(
"kerwim",
18
);
p1.out();
// 根据 p1 创建一个新的对象
CopyConstructorPerson p2 =
new CopyConstructorPerson(p1);
p2.out();
}
}输出:
姓名:kerwim,年龄:18
姓名:kerwim,年龄:18这里:
new CopyConstructorPerson(p1);会创建一个新的对象,然后执行:
this.name = person.name;
this.age = person.age;把 p1 中的数据复制过去。
因此:
p1
↓
Person{name="kerwim", age=18}
p2
↓
Person{name="kerwim", age=18}虽然数据一样,但:
System.out.println(p1 == p2);结果是:
false因为它们是两个不同的对象。
复制构造方法的好处是:
复制逻辑集中在类内部,由类自己决定哪些字段应该复制以及应该怎么复制。
7.7.3 手动复制对象字段
第二种方式比较直接:
创建一个新对象,然后把原对象中的字段一个个赋值给新对象。
例如:
package com.kerwim.Constructor;
/**
* 手动复制对象字段
*/
public class CopyValuePerson {
private String name;
private int age;
public CopyValuePerson(
String name,
int age) {
this.name = name;
this.age = age;
}
public CopyValuePerson() {
}
public void out() {
System.out.println(
"姓名:" + name
+ ",年龄:" + age
);
}
public static void main(String[] args) {
CopyValuePerson p1 =
new CopyValuePerson(
"kerwim",
18
);
p1.out();
// 创建新的对象
CopyValuePerson p2 =
new CopyValuePerson();
// 手动复制字段
p2.name = p1.name;
p2.age = p1.age;
p2.out();
}
}这里:
p2.name = p1.name;
p2.age = p1.age;就是把 p1 中的字段值逐个复制给 p2。
这种方式比较简单直观,但如果字段很多:
name
age
sex
email
phone
address
...就需要一个个复制,代码会比较啰嗦,也容易漏字段。
实际开发中,如果字段是 private,并且复制代码不在当前类内部,还需要通过:
Getter / Setter或者其他方法完成复制。
7.7.4 通过 Object.clone() 复制对象
Java 的 Object 类还提供了:
protected native Object clone()
throws CloneNotSupportedException;用于复制对象。
如果一个类需要使用 Object.clone(),通常需要实现:
Cloneable接口。
例如:
package com.kerwim.Constructor;
/**
* 通过 Object.clone() 复制对象
*/
public class ClonePerson implements Cloneable {
private String name;
private int age;
public ClonePerson(
String name,
int age) {
this.name = name;
this.age = age;
}
@Override
public ClonePerson clone()
throws CloneNotSupportedException {
return (ClonePerson) super.clone();
}
public void out() {
System.out.println(
"姓名:" + name
+ ",年龄:" + age
);
}
public static void main(String[] args)
throws CloneNotSupportedException {
ClonePerson p1 =
new ClonePerson(
"kerwim",
18
);
p1.out();
// 克隆一个新的对象
ClonePerson p2 = p1.clone();
p2.out();
System.out.println(p1 == p2);
}
}输出:
姓名:kerwim,年龄:18
姓名:kerwim,年龄:18
false这里:
ClonePerson p2 = p1.clone();会创建一个新的 ClonePerson 对象。
需要注意:
Cloneable本身并没有定义clone()方法,它只是一个标记接口。
也就是说:
public interface Cloneable {
}它的作用主要是告诉 Object.clone():
这个类允许被克隆如果没有实现 Cloneable:
public class ClonePerson {
}然后调用:
super.clone();就会抛出:
CloneNotSupportedException7.7.5 浅拷贝和深拷贝
复制对象时还需要注意一个重要问题:
浅拷贝(Shallow Copy)
深拷贝(Deep Copy)Object.clone() 默认执行的是浅拷贝。
如果对象中只有:
int
long
double
boolean这类基本数据类型,理解起来比较简单,字段的值会被直接复制。
但是如果对象中还包含其他对象:
public class Person {
private String name;
private Address address;
}浅拷贝之后可能是:
p1 ──→ Person
│
└── address ──┐
│
↓
Address
p2 ──→ Person
│
└── address ──┘也就是说:
Person 对象复制了一份
但两个 Person 中的 address
仍然可能指向同一个 Address 对象这就是浅拷贝。
如果希望:
Person 复制一份
Address 也复制一份则需要进行深拷贝。
这一块后面涉及对象复制时再详细展开即可。
7.7.6 三种方式对比
可以简单对比一下:
| 方式 | 特点 |
|---|---|
| 复制构造方法 | 逻辑清晰,可以自己控制复制哪些字段 |
| 手动复制字段 | 简单直接,但字段多时代码比较繁琐 |
clone() | 可以快速复制对象,但需要实现 Cloneable,默认还是浅拷贝 |
一般来说:
简单对象
↓
复制构造方法 / 手动复制
需要使用 Java Clone 机制
↓
clone()
存在嵌套引用对象
↓
需要额外考虑浅拷贝和深拷贝最重要的一点是区分:
Person p2 = p1;和:
Person p2 = new Person(p1);前者:
只是复制引用
两个变量指向同一个对象后者:
真正创建了一个新的对象
只是对象中的数据来自 p18. Java 访问权限修饰符
8.1 概述
在面向对象编程中,一个类通常不会把内部所有内容都暴露给外部。
例如有两个场景:
场景 1:
工程师 A 编写了一个 ClassA,但不希望其他包中的类都能够访问它。
场景 2:
ClassA 中有两个方法:
fun1()
fun2()工程师只希望外部可以调用 fun1(),而 fun2() 只允许类内部使用。
这时候就需要使用 Java 的访问权限修饰符控制类、方法和字段的可见范围。
Java 提供了四种访问权限:
public
protected
默认(package-private)
private它们的访问范围可以先看下面这张表:
| 修饰符 | 当前类 | 同一个包 | 不同包的子类 | 不同包的其他类 |
|---|---|---|---|---|
public | ✅ | ✅ | ✅ | ✅ |
protected | ✅ | ✅ | ✅ | ❌ |
| 默认 | ✅ | ✅ | ❌ | ❌ |
private | ✅ | ❌ | ❌ | ❌ |
访问范围从大到小大致为:
public
↓
protected
↓
默认(package-private)
↓
private需要注意,**顶级类(Top-level Class)**只能使用:
public
默认访问权限例如:
public class Kerwim {
}或者:
class Kerwim {
}顶级类不能直接使用:
private
protected但是类中的:
成员变量
方法
构造方法
内部类可以根据具体规则使用不同的访问权限修饰符。
访问权限控制的核心目的就是:
只暴露外部真正需要使用的内容,把内部实现隐藏起来。
这也是 Java 封装思想的一部分。
8.2 修饰类
对于普通的顶级类来说,可以使用两种访问权限:
public
默认(package-private)8.2.1 默认访问权限
如果类前面什么都不写:
class People {
}那么这个类就是默认访问权限,也叫:
package-private表示:
这个类只能被同一个包中的其他类访问。
例如:
public class Main {
public static void main(String[] args) {
People people = new People("Tom");
System.out.println(people.getName());
}
}People:
class People {
private String name;
public People(String name) {
this.name = name;
}
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}
}如果:
Main
People位于同一个包中,那么 Main 可以正常访问 People。
例如:
com.kerwim.demo
├── Main.java
└── People.java此时:
People people = new People("Tom");没有问题。
但是如果两个类位于不同的包:
com.kerwim.main.Main
com.kerwim.people.People而 People 仍然是:
class People {
}那么 Main 就无法访问它。
IDE 会提示类似下面的错误:
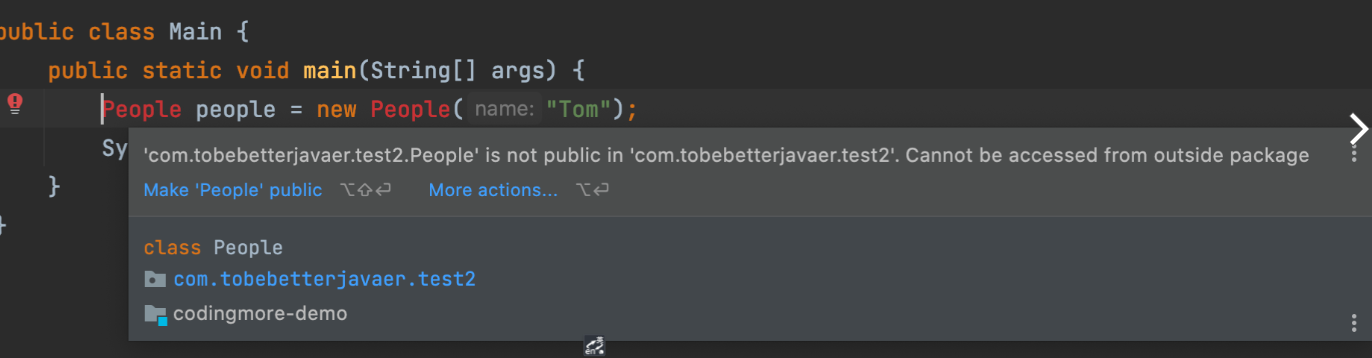
原因就是:
People
↓
默认访问权限
↓
只允许同包访问如果希望其他包也可以使用 People,就需要改成:
public class People {
}8.2.2 public 修饰类
使用:
public修饰的类可以被其他包中的代码访问。
例如:
package com.kerwim.people;
public class People {
private String name;
public People(String name) {
this.name = name;
}
public String getName() {
return name;
}
}另外一个包:
package com.kerwim.main;
import com.kerwim.people.People;
public class Main {
public static void main(String[] args) {
People people = new People("Tom");
System.out.println(people.getName());
}
}这样就可以正常访问。
所以对于顶级类,可以简单记成:
class People
↓
只允许同包访问
public class People
↓
其他包也可以访问8.3 修饰方法和变量
类中的字段和方法可以使用:
public
protected
默认(package-private)
private四种访问权限。
8.3.1 public
public 的访问范围最大。
被 public 修饰的字段或者方法,只要类本身能够被访问,就可以在其他地方访问。
例如:
public class People {
public String name;
public String getName() {
return name;
}
}外部可以直接调用:
People people = new People();
people.name = "kerwim";
System.out.println(people.getName());不过实际开发中,成员变量通常不会直接声明成 public,更常见的是:
private String name;然后通过方法对外提供访问。
8.3.2 private
private 的访问范围最小。
被 private 修饰的字段或者方法:
只能在当前类内部直接访问。
例如:
public class People {
private String name;
private void test() {
System.out.println("private method");
}
}在 People 内部可以访问:
public void print() {
System.out.println(name);
test();
}但是其他类不能直接:
people.name;
people.test();这也是封装中最常见的写法:
public class People {
private String name;
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}
}外部不能直接修改:
people.name;而是通过:
people.setName("kerwim");
people.getName();访问。
8.3.3 默认访问权限
如果字段或者方法前面没有任何访问权限修饰符:
String getName() {
return name;
}那么它就是默认访问权限:
package-private例如:
public class People {
private String name;
public People(String name) {
this.name = name;
}
// 默认访问权限
String getName() {
return name;
}
// 默认访问权限
void setName(String name) {
this.name = name;
}
}如果 People 和 Main 位于同一个包:
com.kerwim.demo
├── People
└── Main那么:
people.getName();
people.setName("kerwim");都可以正常调用。
但是如果:
People
Main位于不同包中,就无法直接访问这些方法。
IDE 会提示类似下面的错误:
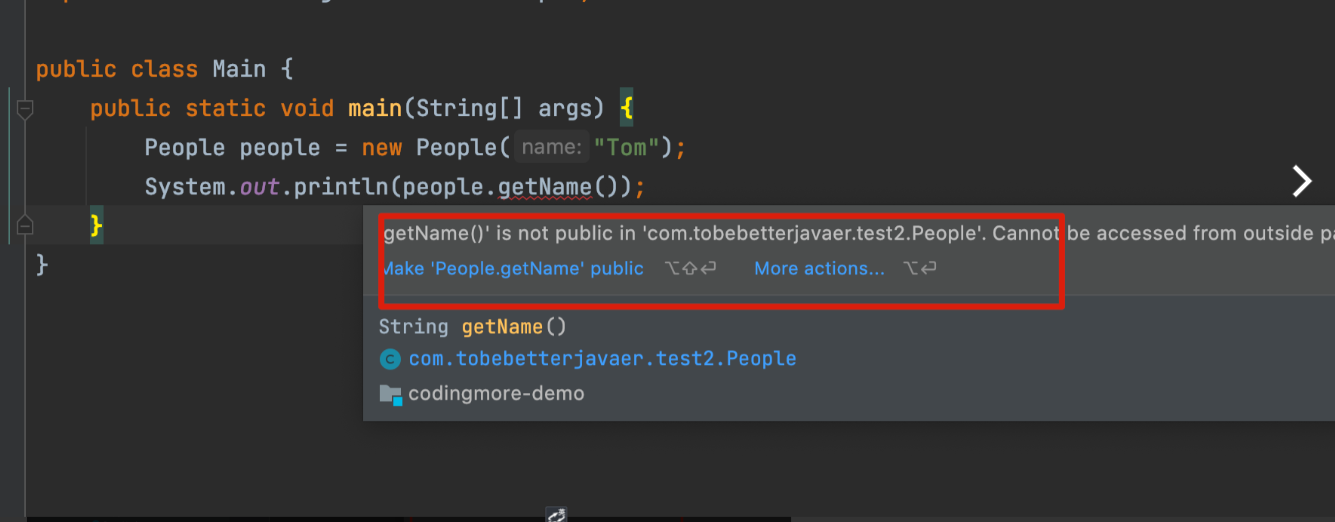
所以默认访问权限可以理解为:
同一个包
↓
可以访问
不同的包
↓
不能访问8.3.4 protected
protected 比默认访问权限稍微特殊一些。
它允许:
当前类
同一个包中的其他类
不同包中的子类访问。
例如:
public class People {
private String name;
public People(String name) {
this.name = name;
}
protected String getName() {
return name;
}
protected void setName(String name) {
this.name = name;
}
}如果 Main 和 People 位于同一个包中,那么即使 Main 不是 People 的子类,也可以调用:
people.getName();
people.setName("kerwim");但是如果 Main 和 People 位于不同包,并且 Main 也没有继承 People,那么就不能直接调用。
例如:
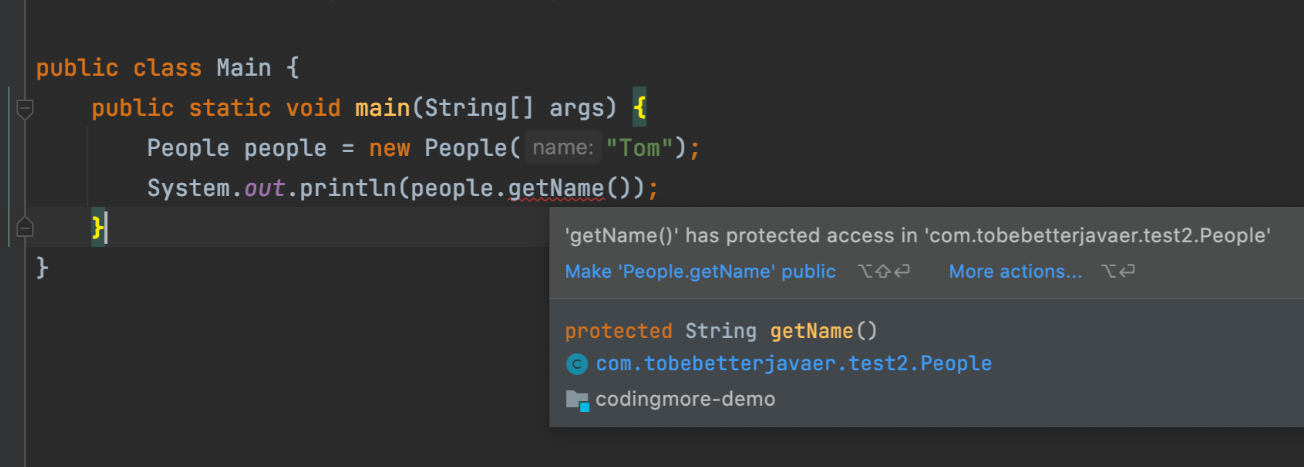
如果是不同包中的子类:
public class Student extends People {
public Student(String name) {
super(name);
}
public void print() {
// 可以访问继承而来的 protected 方法
System.out.println(getName());
}
}这里:
Student extends People因此即使 Student 和 People 不在同一个包中,子类仍然可以访问继承得到的 protected 成员。
不过这里有一个容易忽略的细节。
不同包中的子类,访问 protected 成员时,主要是通过继承关系访问,而不是获得了随意操作任意父类对象的权限。
所以可以先简单记成:
protected
↓
同包可以访问
↓
不同包时,需要通过子类继承关系访问最后再把四种权限放在一起:
| 修饰符 | 当前类 | 同包 | 不同包子类 | 不同包普通类 |
|---|---|---|---|---|
public | ✅ | ✅ | ✅ | ✅ |
protected | ✅ | ✅ | ✅ | ❌ |
| 默认 | ✅ | ✅ | ❌ | ❌ |
private | ✅ | ❌ | ❌ | ❌ |
可以简单记:
private
↓
只给自己
默认
↓
给同一个包
protected
↓
给同包 + 子类
public
↓
对外公开另外补充两个和 Java 源文件有关的规则。
1. package 的作用
Java 中的包主要用于:
组织和管理代码
避免类名冲突
配合访问权限控制例如:
com.kerwim.user.User
com.kerwim.order.User虽然两个类都叫:
User但因为包名不同,所以它们是两个不同的类。
2. public 顶级类和 Java 文件名
一个 .java 文件中可以定义多个顶级类,但最多只能有一个:
public 顶级类如果存在 public 顶级类,那么源文件名必须和这个类名一致。
例如:
public class People {
}
class Student {
}
class Teacher {
}文件名必须是:
People.java其中:
Student
Teacher都是默认访问权限,因此包外无法直接访问。
如果一个 .java 文件中没有 public 顶级类,那么文件名不要求必须和某个类名完全一致,不过实际开发中通常还是会保持:
一个主要类
一个 Java 文件
文件名和主要类名一致这样代码结构会更加清楚。
9. Java 代码初始化块
9.1 概述
Java 中除了可以在声明成员变量时直接赋值:
public class Bike {
private int speed = 100;
}还可以使用**初始化块(Initialization Block)**完成对象或类的初始化工作。
初始化块主要分为两种:
实例初始化块
静态初始化块写法分别是:
public class Demo {
// 实例初始化块
{
System.out.println("实例初始化块");
}
// 静态初始化块
static {
System.out.println("静态初始化块");
}
}两者最大的区别是:
实例初始化块
↓
每创建一个对象都会执行一次
静态初始化块
↓
类初始化时执行
↓
通常只执行一次9.2 实例初始化块
实例初始化块就是直接定义在类中的普通代码块:
public class Bike {
{
System.out.println("实例初始化块");
}
}它没有:
方法名
返回值
参数每次创建对象时都会执行。
例如:
public class Bike {
{
System.out.println("创建 Bike 对象");
}
public static void main(String[] args) {
new Bike();
new Bike();
}
}输出:
创建 Bike 对象
创建 Bike 对象因为创建了两个对象,所以实例初始化块执行了两次。
普通的成员变量初始化,可以直接写:
public class Bike {
private int speed = 100;
}但如果初始化逻辑需要多条语句,初始化块就比较方便。
例如初始化一个集合:
package com.kerwim.initializationblock;
import java.util.ArrayList;
import java.util.List;
public class Bike {
private List<String> list;
{
// 创建集合
list = new ArrayList<>();
// 添加初始化数据
list.add("kerwim");
list.add("kevin");
}
public static void main(String[] args) {
Bike bike = new Bike();
System.out.println(bike.list);
}
}输出:
[kerwim, kevin]当然,现在 Java 也可以直接通过其他方式完成集合初始化,例如:
private List<String> list =
new ArrayList<>(
List.of("kerwim", "kevin")
);所以初始化块并不是“必须使用”的东西。
它更适合:
初始化过程需要多条语句
多个构造方法存在共同初始化逻辑
需要在构造方法执行主体之前完成一些初始化9.3 实例初始化块和构造方法的执行顺序
来看一个简单的例子:
public class Car {
{
System.out.println("实例初始化块");
}
public Car() {
System.out.println("构造方法");
}
public static void main(String[] args) {
new Car();
}
}输出:
实例初始化块
构造方法所以从实际执行结果来看:
实例初始化块会在构造方法的方法体之前执行。
这个地方比较容易产生误解。
并不是说初始化块和构造方法是两个完全独立的过程。
编译之后,实例变量初始化和实例初始化块中的代码,会被编译器安排到构造方法的初始化过程中执行。
可以大致理解为,原来的代码:
public class Car {
private int speed = 100;
{
System.out.println("实例初始化块");
}
public Car() {
System.out.println("构造方法");
}
}在构造对象时的效果类似:
public Car() {
// 先完成父类构造
super();
// 实例变量初始化
speed = 100;
// 实例初始化块
System.out.println("实例初始化块");
// 原构造方法中的代码
System.out.println("构造方法");
}这里最重要的是记住实际执行顺序:
父类构造过程
↓
当前类实例变量初始化
↓
当前类实例初始化块
↓
当前类构造方法主体因此前面的输出才会是:
实例初始化块
构造方法而不是:
构造方法
实例初始化块9.4 多个初始化块的执行顺序
一个类中可以存在多个实例初始化块。
它们和实例变量初始化一样,会按照源码中出现的先后顺序执行。
例如:
public class Demo {
private int a = initA();
{
System.out.println("实例初始化块 1");
}
private int b = initB();
{
System.out.println("实例初始化块 2");
}
public Demo() {
System.out.println("构造方法");
}
private int initA() {
System.out.println("初始化 a");
return 10;
}
private int initB() {
System.out.println("初始化 b");
return 20;
}
public static void main(String[] args) {
new Demo();
}
}输出:
初始化 a
实例初始化块 1
初始化 b
实例初始化块 2
构造方法因此实例字段初始化和实例初始化块,并不是分成两批执行,而是按照代码中的顺序执行:
实例字段初始化
+
实例初始化块
↓
按照源码顺序执行9.5 继承情况下的初始化顺序
再看一个有继承关系的例子。
父类:
class A {
public A() {
System.out.println("父类构造方法");
}
}子类:
public class B extends A {
{
System.out.println("子类实例初始化块");
}
public B() {
System.out.println("子类构造方法");
}
public static void main(String[] args) {
new B();
}
}输出:
父类构造方法
子类实例初始化块
子类构造方法这是因为创建子类对象时,会先完成父类部分的初始化。
可以先简单记成:
new B()
↓
父类 A 的初始化过程
↓
A 构造方法
↓
子类 B 的实例变量和实例初始化块
↓
B 构造方法主体也就是:
父类先初始化
↓
子类再初始化后面学习:
super()以及继承中的构造方法时,还会继续详细讲这个过程。
9.6 静态初始化块
除了实例初始化块之外,Java 还提供了:
static {
}这种结构称为:
静态初始化块例如:
public class Example {
// 静态变量
public static int staticVar = 1;
// 实例变量
public int instanceVar = 2;
// 静态初始化块
static {
System.out.println("执行静态初始化块");
staticVar = 3;
}
// 实例初始化块
{
System.out.println("执行实例初始化块");
instanceVar = 4;
}
// 构造方法
public Example() {
System.out.println("执行构造方法");
}
public static void main(String[] args) {
System.out.println("执行 main 方法");
Example e1 = new Example();
Example e2 = new Example();
System.out.println(
"e1 的静态变量:" + e1.staticVar
);
System.out.println(
"e1 的实例变量:" + e1.instanceVar
);
System.out.println(
"e2 的静态变量:" + e2.staticVar
);
System.out.println(
"e2 的实例变量:" + e2.instanceVar
);
}
}输出:
执行静态初始化块
执行 main 方法
执行实例初始化块
执行构造方法
执行实例初始化块
执行构造方法
e1 的静态变量:3
e1 的实例变量:4
e2 的静态变量:3
e2 的实例变量:4从结果可以看出:
静态初始化块
↓
只执行一次
实例初始化块
↓
每创建一个对象执行一次为什么:
执行静态初始化块会出现在:
执行 main 方法前面?
因为 JVM 要执行:
Example.main()之前,需要先完成 Example 类的初始化。
因此:
Example 类初始化
↓
执行静态变量初始化
↓
执行静态初始化块
↓
执行 main()需要注意:
静态字段初始化和静态初始化块同样按照源码中出现的顺序执行。
例如:
public class Demo {
private static int a = initA();
static {
System.out.println("静态初始化块 1");
}
private static int b = initB();
static {
System.out.println("静态初始化块 2");
}
private static int initA() {
System.out.println("初始化静态变量 a");
return 10;
}
private static int initB() {
System.out.println("初始化静态变量 b");
return 20;
}
}执行顺序为:
初始化静态变量 a
静态初始化块 1
初始化静态变量 b
静态初始化块 29.7 实例初始化和静态初始化对比
最后简单对比一下:
| 对比项 | 实例初始化块 | 静态初始化块 |
|---|---|---|
| 语法 | { } | static { } |
| 所属 | 对象 | 类 |
| 执行时机 | 创建对象时 | 类初始化时 |
| 执行次数 | 每创建一个对象执行一次 | 通常只执行一次 |
| 能否直接访问实例变量 | 可以 | 不可以 |
| 能否直接访问静态变量 | 可以 | 可以 |
| 与构造方法关系 | 在构造方法主体之前执行 | 与对象构造无直接关系 |
整个初始化过程可以先记成:
类第一次初始化
↓
静态变量初始化
↓
静态初始化块
↓
只执行一次
每次 new 对象
↓
父类对象初始化
↓
实例变量初始化
↓
实例初始化块
↓
构造方法主体所以最核心的区别就是:
static { }
↓
初始化“类”
{ }
↓
初始化“对象”静态初始化块后面讲 static 时还会继续涉及,这里先掌握它和实例初始化块的区别以及基本执行顺序即可。
10 Java抽象类
10.1 概述(定义抽象类)
在 Java 中,使用:
abstract关键字修饰的类称为抽象类(Abstract Class)。
定义方式如下:
abstract class AbstractPlayer {
}如果类使用了 abstract 修饰:
abstract class AbstractPlayer {
}那么它就不能直接通过:
new创建对象。
例如:
AbstractPlayer player =
new AbstractPlayer();会编译报错。
抽象类主要用来作为其他类的父类,用于描述一类对象共同具有的属性和行为。
例如:
abstract class AbstractPlayer {
private String name;
public void login() {
System.out.println("登录游戏");
}
}然后由具体子类继承:
public class Warrior
extends AbstractPlayer {
}可以简单理解为:
抽象类
↓
描述一类对象的共同特征
↓
自己通常不直接创建对象
↓
交给具体子类继承和实现例如:
Player
├── Warrior
├── Mage
└── Archer如果 Player 本身只是一个抽象概念,而真正创建的对象一定是:
Warrior
Mage
Archer那么就比较适合把 Player 定义成抽象类。
abstract class AbstractPlayer {
}10.1.1 抽象类的命名
在实际项目中,抽象类的名字通常会体现出它是一个抽象父类。
例如:
AbstractPlayer
AbstractService
AbstractController
BaseEntity
BaseService《阿里巴巴 Java 开发手册》中也建议:
抽象类命名使用
Abstract或Base开头。
例如:
public abstract class AbstractPlayer {
}或者:
public abstract class BaseEntity {
}这样看到类名,就能比较直观地知道:
这个类通常不是直接拿来创建对象的
而是给其他类继承使用的所以命名上可以优先考虑:
AbstractXxx
BaseXxx做到见名知意。
10.2 抽象类的特征
抽象类和普通类很像,也可以定义成员变量、构造方法和普通方法,但它有几个比较明显的特点。
10.2.1 抽象类不能直接实例化
抽象类不能直接通过 new 创建对象。
例如:
public abstract class AbstractPlayer {
}下面的代码无法通过编译:
AbstractPlayer player =
new AbstractPlayer();IDE 会提示抽象类不能被实例化:
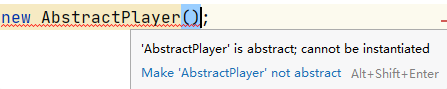
虽然抽象类自己不能实例化,但可以作为父类被其他类继承:
public class BasketballPlayer
extends AbstractPlayer {
}也就是说:
AbstractPlayer
↓
不能直接 new
↓
作为父类提供公共结构
↓
BasketballPlayer
FootballPlayer
...10.2.2. 包含抽象方法的类必须是抽象类
抽象方法使用:
abstract修饰,并且没有方法体。
例如:
abstract void play();如果一个类中声明了抽象方法,那么这个类本身也必须使用:
abstract修饰。
正确写法:
public abstract class AbstractPlayer {
abstract void play();
}如果在普通类中声明抽象方法:
public class AbstractPlayer {
abstract void play();
}就无法通过编译。
类本身会提示需要声明为 abstract:
抽象方法的位置也会出现对应的编译错误:
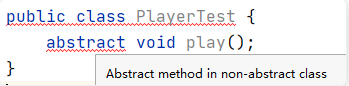
所以可以记住:
类中存在抽象方法
↓
这个类必须是抽象类不过反过来并不成立:
抽象类中不一定必须存在抽象方法。
例如下面的写法也是合法的:
public abstract class AbstractPlayer {
public void sleep() {
System.out.println("运动员也需要休息");
}
}即使没有任何抽象方法,只要类使用了 abstract 修饰,它仍然是抽象类,也不能直接实例化。
10.2.3. 抽象类既可以有抽象方法,也可以有普通方法
抽象类不是只能写抽象方法。
例如:
/**
* 抽象类
*/
public abstract class AbstractPlayer {
/**
* 抽象方法
* 只规定必须具备 play() 能力
*/
abstract void play();
/**
* 普通方法
* 已经提供具体实现
*/
public void sleep() {
System.out.println("运动员也要休息,而不是一直挑战极限");
}
}这里:
play()是抽象方法,只定义了方法应该存在,但没有提供具体实现。
而:
sleep()是普通方法,已经提供了完整的方法体,子类可以直接继承使用。
所以抽象类很适合表达:
所有子类都共有的逻辑
↓
普通方法直接实现
不同子类实现方式不同的逻辑
↓
声明成抽象方法
↓
交给子类实现10.2.4. 具体子类必须实现抽象方法
如果一个普通类继承了抽象类,就必须实现父类中尚未实现的抽象方法。
例如:
public abstract class AbstractPlayer {
abstract void play();
public void sleep() {
System.out.println("运动员也需要休息");
}
}定义一个篮球运动员:
/**
* 继承抽象类
*/
public class BasketballPlayer
extends AbstractPlayer {
@Override
void play() {
System.out.println(
"我是张伯伦,篮球场上得过 100 分"
);
}
}父类规定:
abstract void play();也就是告诉所有具体的运动员:
你必须具有
play()这个行为,但具体怎么玩由你自己决定。
于是 BasketballPlayer 给出了自己的实现:
@Override
void play() {
System.out.println(
"我是张伯伦,篮球场上得过 100 分"
);
}如果普通子类没有实现父类中的抽象方法:
public class BasketballPlayer
extends AbstractPlayer {
}就无法通过编译:
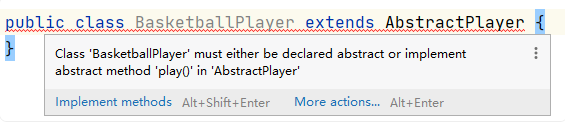
不过这里有一个例外。
如果子类自己也是抽象类:
public abstract class BasketballPlayer
extends AbstractPlayer {
}那么它可以暂时不实现:
play()继续把这个任务交给更具体的子类。
因此更准确地说:
继承抽象类的具体子类,必须实现父类中尚未实现的抽象方法;如果子类自己仍然是抽象类,则可以继续不实现。
整个关系可以简单理解为:
AbstractPlayer
│
│ abstract play()
│
├── BasketballPlayer
│ ↓
│ 实现 play()
│
└── FootballPlayer
↓
实现 play()抽象类的核心作用就是:
把共同的内容放到父类
把必须存在但实现不同的行为定义成抽象方法
再交给不同的子类完成具体实现10.3 抽象类的应用场景
抽象类比较适合用在:
多个子类存在共同的属性和行为
↓
公共部分放到抽象父类中复用
不同子类又存在不同的实现
↓
定义抽象方法
↓
交给子类完成具体实现也就是说,抽象类既可以提供已经实现好的公共代码,也可以规定子类必须实现的行为。
10.3.1 复用多个子类的公共功能
如果多个子类存在相同的行为,可以把公共实现放到抽象父类中,避免每个子类重复编写。
例如所有运动员都需要休息,那么可以把 sleep() 放到 AbstractPlayer 中:
public abstract class AbstractPlayer {
/**
* 所有运动员共有的行为
*/
public void sleep() {
System.out.println(
"运动员也要休息,而不是一直挑战极限"
);
}
}篮球运动员继承:
public class BasketballPlayer
extends AbstractPlayer {
}足球运动员也继承:
public class FootballPlayer
extends AbstractPlayer {
}两个子类都可以直接使用父类已经实现好的 sleep():
BasketballPlayer basketballPlayer =
new BasketballPlayer();
basketballPlayer.sleep();FootballPlayer footballPlayer =
new FootballPlayer();
footballPlayer.sleep();这样:
BasketballPlayer
│
│
├──────┐
↓
AbstractPlayer
│
│ sleep()
↑
├──────┘
│
FootballPlayer公共代码只需要在父类中写一次。
以后如果 sleep() 的实现发生变化,也只需要修改:
AbstractPlayer而不需要分别修改每一个子类。
所以第一种应用场景可以简单概括为:
把多个子类重复的代码提取到抽象父类中,实现代码复用。
10.3.2 规定统一行为,由子类分别实现
第二种场景更加常见:
父类规定所有子类都必须具备某种能力,但不同子类的具体实现不同。
例如所有运动员都有:
play()这个行为。
但是:
篮球运动员 → 打篮球
足球运动员 → 踢足球具体行为显然不一样。
这时可以在抽象类中声明抽象方法:
public abstract class AbstractPlayer {
/**
* 所有运动员都必须实现自己的运动方式
*/
public abstract void play();
}篮球运动员实现自己的 play():
public class BasketballPlayer
extends AbstractPlayer {
@Override
public void play() {
System.out.println(
"我是张伯伦,篮球场上得过 100 分"
);
}
}足球运动员也实现自己的 play():
public class FootballPlayer
extends AbstractPlayer {
@Override
public void play() {
System.out.println(
"我是 C 罗,我擅长头球"
);
}
}关系可以理解为:
AbstractPlayer
│
abstract play()
│
┌────────┴────────┐
↓ ↓
BasketballPlayer FootballPlayer
│ │
打篮球的实现 踢足球的实现父类只负责规定:
你必须会 play()但是:
具体怎么玩交给不同的子类自己决定。
这就是抽象类非常典型的使用方式。
下面再看一个稍微完整一点的例子。
这个例子会涉及:
文件读取
Java 8 Stream
方法引用重点不是文件 IO,而是观察:
抽象类如何定义一套公共流程,同时把其中容易变化的部分交给子类实现。
假设现在有一个文本文件:
helloworld.txt内容为:
Hello World现在需要设计两种读取方式:
读取后全部转成小写
读取后全部转成大写读取文件本身的过程其实完全一样:
找到文件
↓
逐行读取
↓
处理每一行
↓
收集结果真正不同的只有:
这一行到底转换成大写还是小写?所以可以把公共流程放到抽象父类:
BaseFileReader10.3.3 BaseFileReader
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.List;
import java.util.stream.Collectors;
import java.util.stream.Stream;
/**
* 文件读取抽象类
*
* 公共的文件读取流程由父类完成,
* 每一行具体如何转换交给子类实现。
*/
public abstract class BaseFileReader {
/**
* 要读取的文件路径
*/
protected final Path filePath;
/**
* 初始化文件路径
*/
protected BaseFileReader(Path filePath) {
this.filePath = filePath;
}
/**
* 公共的文件读取流程
*/
public List<String> readFile()
throws IOException {
// Files.lines() 返回 Stream,需要及时关闭
try (Stream<String> lines =
Files.lines(filePath)) {
return lines
// 每一行具体怎么处理,由子类决定
.map(this::mapFileLine)
// 收集处理结果
.collect(Collectors.toList());
}
}
/**
* 定义每一行的处理规则
* 具体实现交给子类
*/
protected abstract String mapFileLine(
String line
);
}这里最重要的是两个方法:
public List<String> readFile()和:
protected abstract String mapFileLine(String line);readFile() 已经把文件读取的公共流程写好了:
读取文件
↓
获得每一行
↓
调用 mapFileLine()
↓
收集处理后的结果其中:
.map(this::mapFileLine)表示文件中的每一行都会交给:
mapFileLine()处理。
但是父类并不知道:
到底要转成大写
还是转成小写所以:
mapFileLine()被定义成抽象方法:
protected abstract String mapFileLine(
String line
);交给子类决定。
10.3.4 LowercaseFileReader
如果需要全部转换为小写:
public class LowercaseFileReader
extends BaseFileReader {
public LowercaseFileReader(
Path filePath) {
super(filePath);
}
@Override
protected String mapFileLine(
String line) {
return line.toLowerCase();
}
}子类不需要重新编写:
打开文件
读取文件
遍历每一行
收集结果只需要关心自己的事情:
return line.toLowerCase();10.3.5 UppercaseFileReader
大写读取也是一样:
public class UppercaseFileReader
extends BaseFileReader {
public UppercaseFileReader(
Path filePath) {
super(filePath);
}
@Override
protected String mapFileLine(
String line) {
return line.toUpperCase();
}
}它同样只需要实现:
mapFileLine()而不需要重新写文件读取逻辑。
整个设计可以理解为:
BaseFileReader
│
│
readFile() 公共流程
│
mapFileLine()
抽象方法
│
┌────────────┴────────────┐
↓ ↓
LowercaseFileReader UppercaseFileReader
│ │
toLowerCase() toUpperCase()这样:
不变的部分
↓
放在抽象父类
变化的部分
↓
交给不同子类实现这也是抽象类一个很典型的设计方式。
10.3.6 测试
在:
src/main/resources目录下创建:
helloworld.txt内容:
Hello World文件位置类似:
然后编写测试类:
import java.io.IOException;
import java.net.URISyntaxException;
import java.net.URL;
import java.nio.file.Path;
import java.nio.file.Paths;
import java.util.Objects;
public class FileReaderTest {
public static void main(String[] args)
throws URISyntaxException,
IOException {
// 从 classpath 中寻找资源文件
URL location =
Objects.requireNonNull(
FileReaderTest.class
.getClassLoader()
.getResource(
"helloworld.txt"
),
"未找到 helloworld.txt"
);
// 转换为 Path
Path path =
Paths.get(location.toURI());
// 小写读取器
BaseFileReader lowercaseFileReader =
new LowercaseFileReader(path);
// 大写读取器
BaseFileReader uppercaseFileReader =
new UppercaseFileReader(path);
System.out.println(
lowercaseFileReader.readFile()
);
System.out.println(
uppercaseFileReader.readFile()
);
}
}输出结果:
[hello world]
[HELLO WORLD]这里虽然两个对象的引用类型都是:
BaseFileReader但实际创建的是两个不同的子类:
new LowercaseFileReader(path)
new UppercaseFileReader(path)当父类中的:
readFile()执行:
mapFileLine()时,会根据实际对象调用对应子类的方法:
LowercaseFileReader
↓
mapFileLine()
↓
toLowerCase()
UppercaseFileReader
↓
mapFileLine()
↓
toUpperCase()所以这个例子实际上同时体现了:
抽象
继承
方法重写
多态
代码复用这种:
父类规定整体流程
子类只实现其中某些步骤的设计,在设计模式中还有一个名字:
模板方法模式
Template Method目前不用深入设计模式,只需要理解这里的核心思想:
把相同的流程留在父类,把不同的实现交给子类。
这也是抽象类最常见、最有价值的应用场景之一。
10.4 抽象类总结
最后简单总结一下抽象类的几个特点:
- 抽象类使用
abstract修饰,不能直接实例化。 - 抽象类中可以有抽象方法,也可以有普通方法,并不是必须包含抽象方法。
- 抽象方法只有方法声明,没有方法体。
- 普通子类继承抽象类后,必须实现父类中未实现的抽象方法。
- 如果子类本身也是抽象类,则可以继续不实现这些抽象方法。
可以简单记成:
抽象类
↓
不能直接 new
↓
可以定义公共实现
↓
也可以定义抽象方法
↓
具体实现交给子类11 Java接口
11.1 定义接口
接口(Interface)可以理解为一种规范或能力约定。
它主要用来规定:
实现这个接口的类,应该具备哪些能力。
Java 使用:
interface关键字定义接口。
例如:
public interface Electronic {
// 常量
String LED = "LED";
// 抽象方法
int getElectricityUse();
// 静态方法
static boolean isEnergyEfficient(
String electronicType) {
return electronicType.equals(LED);
}
// 默认方法
default void printDescription() {
System.out.println("电子设备");
}
}这个接口中同时包含了:
常量
抽象方法
静态方法
默认方法分别来看。
11.1.1 接口中的变量
接口中定义的字段默认都会被:
public static final修饰。
所以:
String LED = "LED";实际上等价于:
public static final String LED = "LED";也就是说,接口中的字段本质上都是常量。
因此可以直接通过接口名访问:
System.out.println(Electronic.LED);并且不能再次修改:
// 编译错误
// Electronic.LED = "LCD";Java 语言规范中也规定:
接口中的字段隐式为
public static final。
虽然接口中可以定义常量,但通常不建议为了存放一堆常量专门创建“常量接口”。
例如:
public interface Constants {
String SUCCESS = "success";
String ERROR = "error";
}因为接口主要应该表达:
一种能力
一组行为规范而不是单纯作为常量容器。
11.1.2. 接口中的抽象方法
接口最核心的作用,就是定义一组方法规范。
例如:
int getElectricityUse();没有方法体,表示实现这个接口的类必须提供具体实现。
在接口中,这种普通方法会隐式添加:
public abstract所以:
int getElectricityUse();实际上等价于:
public abstract int getElectricityUse();实现类必须重写:
public class Computer
implements Electronic {
@Override
public int getElectricityUse() {
return 100;
}
}这里需要特别注意:
接口中的抽象方法默认就是
public,所以实现时不能降低访问权限。
因此必须写:
public int getElectricityUse()不能写成:
int getElectricityUse()否则会编译报错。
11.1.3 接口中的静态方法
从 Java 8 开始,接口允许定义静态方法。
例如:
static boolean isEnergyEfficient(
String electronicType) {
return electronicType.equals(LED);
}接口中的静态方法有自己的方法体,可以直接通过接口名调用:
boolean result =
Electronic.isEnergyEfficient("LED");不能通过实现类对象来调用:
Electronic electronic =
new Computer();
// 不这样调用
// electronic.isEnergyEfficient("LED");所以接口静态方法的调用方式可以记成:
接口名.静态方法()和类中的静态方法比较类似。
11.1.4 接口中的默认方法
从 Java 8 开始,接口还允许定义:
default方法。
例如:
default void printDescription() {
System.out.println("电子设备");
}默认方法有完整的方法体。
实现类如果没有重写它,就会直接继承这份默认实现:
public class Computer
implements Electronic {
@Override
public int getElectricityUse() {
return 100;
}
}此时:
Computer computer = new Computer();
computer.printDescription();输出:
电子设备实现类也可以根据自己的需要重新实现:
@Override
public void printDescription() {
System.out.println("电脑");
}为什么 Java 8 要给接口增加 default 方法?
假设一个已经存在很多年的接口:
public interface Electronic {
int getElectricityUse();
}已经有几十个实现类:
Computer
Television
Phone
AirConditioner
...如果突然给接口新增一个普通抽象方法:
void printDescription();那么所有实现类都必须跟着修改。
而使用:
default void printDescription() {
System.out.println("电子设备");
}就可以先提供一个默认实现。
旧的实现类不用立即修改,也不会因为接口增加了新方法而全部编译失败。
这也是 default 方法非常重要的作用:
在保持接口兼容性的同时,为接口增加新的行为。
如果 default 方法没有方法体:
default void printDescription();则会编译报错。
因为:
default 方法
↓
必须提供默认实现11.1.5 接口不能直接实例化
接口和抽象类一样,也不能直接通过 new 创建对象。
例如:
Electronic electronic =
new Electronic();会编译报错:
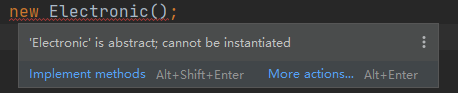
接口需要由具体类通过:
implements进行实现。
例如:
public class Computer
implements Electronic {
@Override
public int getElectricityUse() {
return 100;
}
}然后创建实现类对象:
Computer computer =
new Computer();也可以使用接口类型接收实现类对象:
Electronic electronic =
new Computer();这也是后面多态中非常常见的写法:
接口类型
↓
指向具体实现类对象11.1.6 接口可以是空的
接口并不是必须定义方法或者变量。
例如 Java 中的:
java.io.Serializable就是一个典型的空接口:
public interface Serializable {
}这种接口通常称为:
标记接口(Marker Interface)它本身不规定具体方法,而是给某个类增加一种“标记”。
例如:
public class User
implements Serializable {
}表示这个类具备可以参与 Java 序列化机制的标记。
11.1.7 接口不能使用 final 修饰
接口设计出来就是为了让其他类:
implements或者让其他接口:
extends如果接口本身使用:
final就和这个设计目标冲突了。
因此下面的写法无法通过编译:
public final interface Electronic {
}IDE 也会提示错误:
11.1.8 接口中的方法访问权限
传统的接口抽象方法默认是:
public abstract因此不能写成:
protected void test();
private abstract void test();
final void test();这些写法都会编译失败:
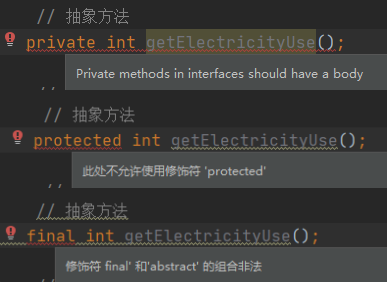
不过需要注意一个版本变化。
从 Java 9 开始,接口允许定义:
private方法。
例如:
public interface Electronic {
default void printDescription() {
printPrefix();
System.out.println("电子设备");
}
private void printPrefix() {
System.out.print("[Electronic] ");
}
}这种 private 方法主要用于:
给接口内部的
default或其他方法复用公共代码。
它不是抽象方法,也不会暴露给实现类。
因此不能简单记成:
接口方法不能 private更准确地说:
抽象方法
↓
默认 public abstract
default 方法
↓
public
static 方法
↓
通常 public
private 方法
↓
Java 9 开始允许
↓
只能接口内部使用11.1.9 接口成员总结
接口中目前常见的内容可以总结为:
| 成员 | 是否允许 | 说明 |
|---|---|---|
| 常量 | ✅ | 默认 public static final |
| 抽象方法 | ✅ | 默认 public abstract |
default 方法 | ✅ | Java 8 开始支持 |
static 方法 | ✅ | Java 8 开始支持 |
private 方法 | ✅ | Java 9 开始支持 |
| 构造方法 | ❌ | 接口不能实例化 |
| 普通实例字段 | ❌ | 接口字段都是常量 |
所以接口最核心的理解还是:
接口
↓
定义一种能力或规范
↓
实现类 implements 接口
↓
完成具体实现例如:
Electronic
│
│ getElectricityUse()
│
├── Computer
├── Television
└── Phone接口只负责规定:
这些对象都应该具备什么能力至于:
具体怎么实现则交给各个实现类完成。
11.2 接口的作用
接口最常见的作用,可以概括为三个方面:
定义能力
实现多接口
实现多态11.2.1 定义一种能力
接口可以用来表示某个类具备某种能力。
例如 Java 中常见的:
Cloneable
Serializable
Comparable其中 Cloneable 和 Serializable 都属于标记接口,接口本身没有定义方法。
例如:
public interface Cloneable {
}实现 Cloneable,相当于给这个类做了一个标记,表示它允许使用 Object.clone() 提供的克隆机制。
例如:
public class CloneableTest
implements Cloneable {
@Override
protected Object clone()
throws CloneNotSupportedException {
return super.clone();
}
public static void main(String[] args)
throws CloneNotSupportedException {
CloneableTest c1 =
new CloneableTest();
CloneableTest c2 =
(CloneableTest) c1.clone();
System.out.println(c1 == c2);
}
}程序可以正常运行。
如果去掉:
implements Cloneable变成:
public class CloneableTest {
@Override
protected Object clone()
throws CloneNotSupportedException {
return super.clone();
}
public static void main(String[] args)
throws CloneNotSupportedException {
CloneableTest c1 =
new CloneableTest();
CloneableTest c2 =
(CloneableTest) c1.clone();
}
}调用:
super.clone();时就会抛出:
java.lang.CloneNotSupportedException类似:
Exception in thread "main"
java.lang.CloneNotSupportedException:
com.kerwim.interfaceDemo.CloneableTest所以这里可以简单理解为:
implements Cloneable
↓
给类增加“允许 clone”的标记而像:
Comparable这种接口则不是空接口,它会真正规定类需要具备的行为,例如:
compareTo()所以接口既可以:
作为一种标记也可以:
规定一种能力11.2.2 一个类可以实现多个接口
Java 的类只支持单继承:
class Dog extends Animal {
}一个类不能同时:
extends A, B两个父类。
这样设计可以避免传统多继承中比较麻烦的问题,例如经典的菱形继承问题:
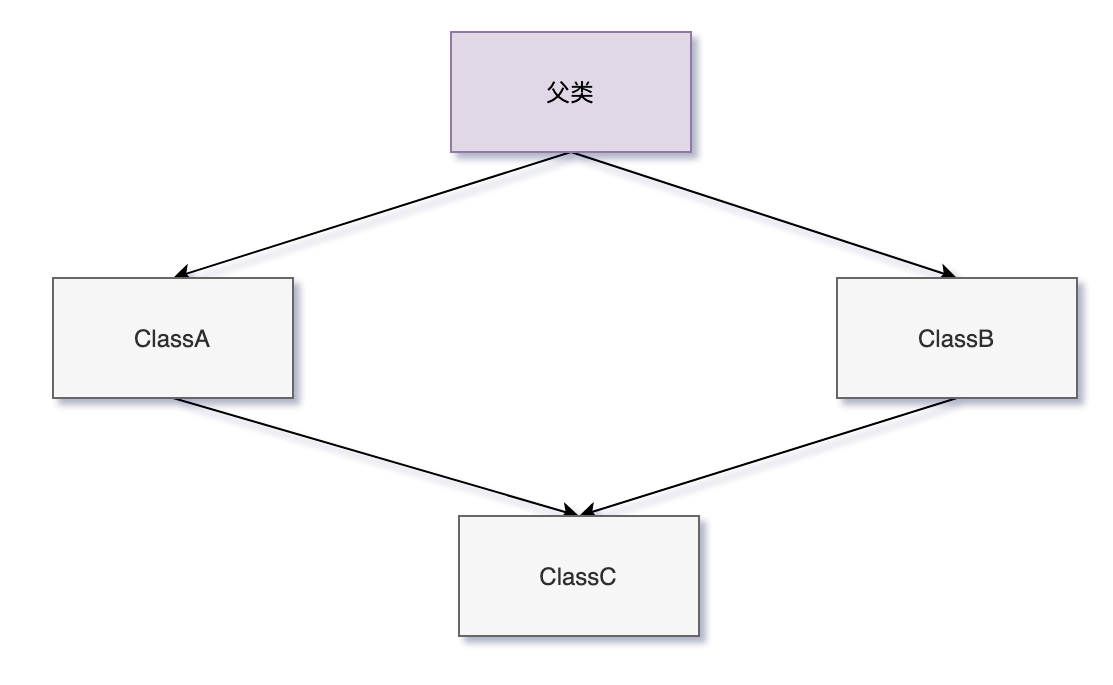
假设:
Parent
/ \
A B
\ /
C如果 A 和 B 都重写了父类中的同一个方法,而 C 又同时继承 A 和 B,那么调用这个方法时就会产生歧义:
到底使用 A 的实现?
还是使用 B 的实现?Java 不允许类之间这样进行多继承。
但是:
一个类可以同时实现多个接口。
例如定义两个接口。
会飞:
public interface Fly {
void fly();
}会跑:
public interface Run {
void run();
}一个类可以同时实现:
Fly和:
Run例如:
public class Pig
implements Fly, Run {
@Override
public void fly() {
System.out.println("会飞的猪");
}
@Override
public void run() {
System.out.println("会跑的猪");
}
}这时候 Pig 同时具备两种能力:
Pig
├── Fly
│ └── fly()
│
└── Run
└── run()调用:
Pig pig = new Pig();
pig.fly();
pig.run();所以从类型和能力的角度来看,接口可以让一个类同时拥有多种角色:
继承
↓
一个类只能 extends 一个父类
接口
↓
一个类可以 implements 多个接口例如现实项目中,一个类完全可以写成:
public class User
implements Serializable,
Comparable<User>,
Cloneable {
}同时具备:
序列化能力
比较能力
克隆能力这也是接口相比抽象类非常重要的一个特点。
严格来说,这不是“类的多继承”,而是一个类可以实现多个接口,从而同时具有多个类型和能力。
另外,Java 8 以后接口有了 default 方法,如果两个接口提供了冲突的默认实现,编译器仍然会要求实现类自己解决冲突,并不会自动猜应该使用哪个。
11.2.3 实现多态
接口还是 Java 实现多态的重要方式之一。
多态可以简单理解为:
同一种调用方式,作用在不同对象上,可以得到不同的行为。
例如定义一个 Shape 接口:
public interface Shape {
String name();
}定义圆形:
public class Circle
implements Shape {
@Override
public String name() {
return "圆";
}
}定义正方形:
public class Square
implements Shape {
@Override
public String name() {
return "正方形";
}
}测试:
import java.util.ArrayList;
import java.util.List;
public class ShapeTest {
public static void main(String[] args) {
List<Shape> shapes =
new ArrayList<>();
// 接口引用指向 Circle 对象
Shape circleShape =
new Circle();
// 接口引用指向 Square 对象
Shape squareShape =
new Square();
shapes.add(circleShape);
shapes.add(squareShape);
for (Shape shape : shapes) {
System.out.println(
shape.name()
);
}
}
}输出结果:
圆
正方形
这里有一个关键点:
Shape circleShape = new Circle();
Shape squareShape = new Square();两个变量的引用类型都是:
Shape但是它们实际指向的对象分别是:
Circle
Square所以在执行:
shape.name();时:
实际对象是 Circle
↓
调用 Circle.name()
实际对象是 Square
↓
调用 Square.name()可以理解为:
Shape
│
name()
│
┌───────┴───────┐
↓ ↓
Circle Square
│ │
"圆" "正方形"这就是接口多态。
多态通常需要满足几个条件:
存在继承或者接口实现关系
子类 / 实现类重写方法
父类或接口引用指向子类 / 实现类对象例如:
Shape shape = new Circle();可以拆开理解:
Shape
↓
引用类型
Circle
↓
实际对象类型调用:
shape.name();最终执行哪个方法,取决于对象实际是什么类型。
接口的价值也就在这里体现出来了。
我们的代码只需要依赖:
Shape而不需要关心对象到底是:
Circle
Square
Triangle
Rectangle只要它们都实现:
Shape就可以按照统一的方式处理。
所以接口最终可以概括为:
定义一种能力
↓
规定“能做什么”
一个类实现多个接口
↓
同时拥有多种能力
接口引用指向不同实现类
↓
实现多态这也是实际 Java 项目中大量采用:
面向接口编程的基础。
11.3 接口常见的三种设计模式
接口本身只负责定义规范,但在实际开发中,经常会和一些设计模式配合使用。
这里先了解三种比较典型的:
策略模式 Strategy
适配器模式 Adapter
工厂模式 Factory目前不需要把设计模式研究得太深,重点先理解:
接口负责定义规则,不同实现类负责提供不同的实现。
11.3.1 策略模式
策略模式(Strategy Pattern)的核心思想是:
把不同的算法或处理方式封装成独立的实现,调用者只依赖统一接口。
例如,不同足球教练可能有不同的战术风格。
先定义教练接口:
/**
* 教练
*/
public interface Coach {
/**
* 防守策略
*/
void defend();
}穆里尼奥提供一种实现:
public class Mourinho
implements Coach {
@Override
public void defend() {
System.out.println("防守赢得冠军");
}
}瓜迪奥拉提供另一种实现:
public class Guardiola
implements Coach {
@Override
public void defend() {
System.out.println(
"进攻就是最好的防守"
);
}
}调用者只依赖:
Coach而不关心具体是哪一个教练:
public class Demo {
public static void defend(
Coach coach) {
coach.defend();
}
public static void main(String[] args) {
defend(new Mourinho());
defend(new Guardiola());
}
}输出:
防守赢得冠军
进攻就是最好的防守这里:
defend(Coach coach)始终接收的是:
Coach但是传入不同的实现:
Mourinho
Guardiola就会执行不同的策略。
整个结构可以理解为:
Coach
│
defend()
│
┌────────┴────────┐
↓ ↓
Mourinho Guardiola
│ │
防守策略 进攻策略以后如果增加一个新的教练:
public class Ancelotti
implements Coach {
@Override
public void defend() {
System.out.println("新的战术策略");
}
}原来的:
defend(Coach coach)不需要修改。
这就是策略模式比较重要的一点:
增加新的策略,不需要修改调用策略的代码。
11.3.2 适配器模式
适配器模式(Adapter Pattern)的核心思想是:
在现有接口和调用者之间增加一层适配,让原本不方便直接使用的接口变得更容易使用。
生活中比较常见的例子就是各种转接头:
USB-C
↓
适配器
↓
HDMI在 Java 中也有类似的思路。
例如有一个接口:
public interface Coach {
void defend();
void attack();
}如果某个类直接实现:
Coach那么必须把两个方法都实现:
public class Mourinho
implements Coach {
@Override
public void defend() {
}
@Override
public void attack() {
}
}但如果某些实现类只关心其中少数几个方法,就可以增加一个中间抽象类:
/**
* 适配器
*/
public abstract class CoachAdapter
implements Coach {
@Override
public void defend() {
}
@Override
public void attack() {
}
}这个适配器先给接口中的方法提供空实现。
真正的子类再根据需要选择性重写:
public class Mourinho
extends CoachAdapter {
@Override
public void defend() {
System.out.println("防守赢得冠军");
}
}调用:
public class Demo {
public static void main(String[] args) {
Coach coach =
new Mourinho();
coach.defend();
}
}结构就是:
Coach
│
├── defend()
└── attack()
↓
CoachAdapter
├── defend() {}
└── attack() {}
↓
Mourinho
↓
只重写 defend()这样 Mourinho 就不用再实现自己根本不关心的:
attack()这种写法更准确地说,属于:
缺省适配器模式
Default Adapter它比较适合:
接口中方法比较多,而具体实现类只需要使用其中一部分方法。
不过 Java 8 之后,接口本身已经支持:
default方法,所以有些以前需要“空实现适配器”的场景,现在也可以直接通过接口默认方法解决。
11.3.3 工厂模式
工厂模式(Factory Pattern)的核心思想是:
把对象的创建过程封装起来,调用者不直接负责 new 具体对象。
例如:
需要 A 级教练
↓
找 A 级教练工厂
↓
得到 ACoach先定义教练接口:
public interface Coach {
void command();
}再定义创建教练的工厂接口:
public interface CoachFactory {
Coach createCoach();
}定义 A 级教练:
public class ACoach
implements Coach {
@Override
public void command() {
System.out.println(
"我是 A 级证书教练"
);
}
}定义对应的工厂:
public class ACoachFactory
implements CoachFactory {
@Override
public Coach createCoach() {
return new ACoach();
}
}再定义 C 级教练:
public class CCoach
implements Coach {
@Override
public void command() {
System.out.println(
"我是 C 级证书教练"
);
}
}以及对应工厂:
public class CCoachFactory
implements CoachFactory {
@Override
public Coach createCoach() {
return new CCoach();
}
}调用者不直接:
new ACoach();
new CCoach();而是依赖工厂:
public class Demo {
public static void create(
CoachFactory factory) {
Coach coach =
factory.createCoach();
coach.command();
}
public static void main(String[] args) {
create(new ACoachFactory());
create(new CCoachFactory());
}
}输出:
我是 A 级证书教练
我是 C 级证书教练整个关系可以理解为:
CoachFactory
│
createCoach()
│
┌──────────┴──────────┐
↓ ↓
ACoachFactory CCoachFactory
↓ ↓
ACoach CCoach
└──────────┬──────────┘
↓
Coach以后如果新增 B 级教练,只需要继续扩展:
BCoach
BCoachFactory而调用者依然可以使用:
create(new BCoachFactory());这种:
一个具体产品
+
一个对应的具体工厂的结构,更准确地属于工厂方法模式(Factory Method)。
这里的重点是:
调用者
↓
依赖 CoachFactory
↓
由工厂负责创建 Coach
↓
调用者不关心具体 new 哪个类最后简单对比一下三种模式:
| 模式 | 解决的问题 | 核心思想 |
|---|---|---|
| 策略模式 | 同一个功能有多种实现方式 | 不同策略实现同一个接口 |
| 适配器模式 | 原接口不方便直接使用 | 增加中间层进行适配 |
| 工厂模式 | 不希望调用者直接创建具体对象 | 把对象创建交给工厂 |
可以简单记成:
策略模式
↓
怎么做?
适配器模式
↓
怎么接?
工厂模式
↓
怎么创建?接口本身并不等于这些设计模式,但接口提供的:
统一抽象
多实现
多态正是这些设计模式能够成立的重要基础。
11.4 抽象类和接口的区别
抽象类和接口都可以用于抽象,也都不能直接实例化,但它们解决的问题并不完全一样。
可以先简单理解为:
抽象类
↓
描述“是什么”
↓
强调一类对象之间的共同属性和行为
接口
↓
描述“能做什么”
↓
强调某种能力或行为规范例如一个运动员抽象类:
public abstract class AbstractCoach {
public abstract void defend();
public abstract void attack();
public void rest() {
System.out.println("教练也需要休息");
}
}抽象类除了抽象方法之外,还可以拥有:
成员变量
构造方法
普通方法
静态方法
初始化块接口则通过:
interface定义:
public interface Coach {
void defend();
void attack();
}这里的:
void defend();实际上等价于:
public abstract void defend();11.4.1 语法上的区别
抽象类和接口最直观的区别可以放在一起看:
| 对比项 | 抽象类 | 接口 |
|---|---|---|
| 定义关键字 | abstract class | interface |
| 实例化 | 不能直接实例化 | 不能直接实例化 |
| 普通成员变量 | 可以 | 不可以 |
| 接口字段 | —— | 默认 public static final |
| 构造方法 | 可以 | 不可以 |
| 抽象方法 | 可以 | 可以 |
| 普通实例方法 | 可以 | 不能像普通类一样随意定义 |
default 方法 | 不需要特殊关键字 | Java 8 开始支持 |
static 方法 | 可以 | Java 8 开始支持 |
private 方法 | 可以 | Java 9 开始支持 |
| 静态初始化块 | 可以 | 不可以 |
| 继承 / 实现数量 | 一个类只能继承一个父类 | 一个类可以实现多个接口 |
例如抽象类可以保存对象状态:
public abstract class Animal {
protected String name;
public Animal(String name) {
this.name = name;
}
public void sleep() {
System.out.println(name + " 正在睡觉");
}
public abstract void eat();
}而接口更适合描述能力:
public interface Fly {
void fly();
}一个类只能:
extends 一个父类但是可以:
implements 多个接口例如:
public class Bird
extends Animal
implements Fly, Serializable {
public Bird(String name) {
super(name);
}
@Override
public void eat() {
System.out.println("吃东西");
}
@Override
public void fly() {
System.out.println("飞行");
}
}这里 Bird:
是一个 Animal
同时具备 Fly 能力
同时具备 Serializable 标记11.4.2 设计上的区别
抽象类通常用于描述一类事物的共同基础。
例如:
Animal
├── Dog
├── Cat
└── Bird可以认为:
Dog is an Animal
Cat is an Animal
Bird is an Animal因此继承更强调:
is-a关系。
而接口通常描述某种能力。
例如:
public interface Fly {
void fly();
}能够飞的不一定属于同一类事物:
Bird
Airplane
Drone它们彼此之间没有必要存在继承关系,但都可以:
implements Fly例如:
public class Bird
implements Fly {
@Override
public void fly() {
System.out.println("鸟靠翅膀飞");
}
}public class Airplane
implements Fly {
@Override
public void fly() {
System.out.println("飞机依靠发动机飞");
}
}public class Drone
implements Fly {
@Override
public void fly() {
System.out.println("无人机飞行");
}
}整个关系就是:
Fly
│
fly()
│
┌─────────┼─────────┐
↓ ↓ ↓
Bird Airplane Drone所以接口强调的更像是:
can-do也就是:
这个类是否具备某种能力。
例如:
Bird can Fly
Airplane can Fly而不是:
Bird is a Fly11.4.3 抽象类更适合复用公共状态和实现
如果多个子类不仅有相同的方法规范,还共享:
成员变量
构造过程
公共方法
部分实现逻辑抽象类通常更加合适。
例如:
public abstract class AbstractPlayer {
protected String name;
public AbstractPlayer(String name) {
this.name = name;
}
public void sleep() {
System.out.println(name + " 正在休息");
}
public abstract void play();
}所有运动员都可以直接复用:
name
构造方法
sleep()不同的子类只需要实现:
play()所以抽象类更像是:
一个基础模板父类先提供一部分公共实现,子类在此基础上继续扩展。
11.4.4 接口更适合定义统一规范
如果我们只关心:
某个对象是否具备某种能力,以及应该提供哪些方法。
接口通常更加合适。
例如:
public interface PayService {
void pay();
}可以有很多完全不同的实现:
AliPayService
WechatPayService
PaypalService它们只需要遵守:
PayService规定的接口即可。
调用者甚至不需要关心具体实现:
public void checkout(
PayService payService) {
payService.pay();
}所以接口特别适合:
定义规范
隔离具体实现
实现多态
降低模块之间的耦合这也是实际项目中经常看到:
Service 接口
↓
ServiceImpl 实现类这种结构的原因之一。
11.4.5 接口也可以提供默认实现
早期 Java 中,接口基本只有抽象方法。
但从 Java 8 开始,接口可以使用:
default提供默认实现:
public interface Fly {
void fly();
default void landing() {
System.out.println("降落");
}
}实现类可以直接使用:
landing()也可以选择重写。
这解决了一个很重要的问题。
假设某个接口已经存在几十个实现类:
Fly
├── Bird
├── Airplane
├── Drone
└── ...如果直接增加一个新的抽象方法:
void landing();那么所有实现类都需要跟着实现。
但如果写成:
default void landing() {
System.out.println("默认降落方式");
}已有实现类就不需要立即修改。
所以不能再简单地认为:
接口增加方法
↓
所有实现类一定都要修改更准确地说:
增加新的抽象方法
↓
实现类通常需要跟着修改
增加 default 方法
↓
可以提供默认实现
↓
原来的实现类可以保持不变11.4.6 怎么选择?
实际开发中可以简单按照下面的思路选择:
多个类本身就是同一类事物
并且存在公共状态和公共代码
↓
优先考虑抽象类
多个完全不同的类
只是具有某种共同能力
↓
优先考虑接口例如:
Animal
├── Dog
├── Cat
└── Bird更适合抽象类:
abstract class Animal {
}而:
Bird
Airplane
Drone虽然不是同一种东西,但都会飞:
interface Fly {
void fly();
}最后可以简单记成:
抽象类
↓
是什么
↓
is-a
↓
公共状态 + 公共实现 + 抽象行为
接口
↓
能做什么
↓
can-do
↓
能力 + 规范 + 多实现一句话概括:
抽象类更偏向“同一类事物的公共模板”,接口更偏向“不同对象都可以遵守的能力规范”。
12. Java 内部类
在 Java 中,可以把一个类定义在另一个类的内部,也可以定义在方法或者代码块内部。
广义上,这类结构通常称为嵌套类(Nested Class)。
日常学习中一般把它们统称为内部类,并分成四种:
成员内部类
局部内部类
匿名内部类
静态内部类严格按照 Java 的术语来说:
非 static 的嵌套类
↓
Inner Class
static 修饰的嵌套类
↓
Static Nested Class不过平时经常还是会把静态嵌套类称为“静态内部类”。
12.1 成员内部类
定义在外部类内部,并且没有使用 static 修饰的类,称为成员内部类。
例如:
public class Kerwim {
private int age = 18;
class Kevin {
private int age = 81;
}
}从结构上看:
Kerwim
├── age
└── Kevin
└── ageKevin 就像 Kerwim 的一个成员一样,因此称为成员内部类。
12.1.1 成员内部类可以访问外部类成员
成员内部类可以直接访问外部类的成员,包括:
private 成员
实例成员
static 成员例如:
public class Kerwim {
private int age = 18;
private String name = "kerwim";
private static double money = 1;
class Kevin {
public void print() {
// 访问外部类 private 实例变量
System.out.println(name);
// 访问外部类 static 变量
System.out.println(money);
}
}
}虽然:
name使用了 private 修饰,但内部类仍然可以访问。
这是因为内部类和外部类之间存在比较紧密的关系。
12.1.2 外部类访问内部类成员
反过来,外部类如果要访问内部类中的实例成员,需要先创建内部类对象。
例如:
public class Kerwim {
private String name = "kerwim";
class Kevin {
public void print() {
System.out.println(name);
}
}
public Kerwim() {
// 创建内部类对象
Kevin kevin = new Kevin();
kevin.print();
}
}调用:
new Kevin().print();也是可以的。
12.1.3 在外部创建成员内部类对象
成员内部类对象依附于某一个外部类对象。
因此如果在静态方法或者外部代码中创建成员内部类,需要先有外部类对象。
例如:
public class Kerwim {
private String name = "kerwim";
class Kevin {
public void print() {
System.out.println(name);
}
}
public static void main(String[] args) {
// 先创建外部类对象
Kerwim kerwim = new Kerwim();
// 再通过外部类对象创建内部类对象
Kerwim.Kevin kevin =
kerwim.new Kevin();
kevin.print();
}
}这里比较特别的语法是:
kerwim.new Kevin();原因就在于:
Kevin 对象
↓
需要关联一个具体的 Kerwim 对象可以理解为:
Kerwim 对象
│
└── Kevin 对象成员内部类和外部类绑定得比较紧,因此实际项目中一般只会在确实需要这种关系时使用。
12.2 局部内部类
定义在方法、构造方法或者代码块内部的类,称为局部内部类(Local Class)。
例如:
public class LiMing {
public LiMing create() {
class LiXiaoMing
extends LiMing {
private int age = 18;
}
return new LiXiaoMing();
}
}这里:
LiXiaoMing只存在于:
create()方法的作用域中。
因此方法外部无法直接使用:
LiXiaoMing可以把它理解成:
局部变量
↓
只在当前作用域可见
局部内部类
↓
同样只在当前作用域可见局部内部类不能使用:
public
protected
private
static这些访问权限或成员修饰方式。
例如下面的写法会报错:
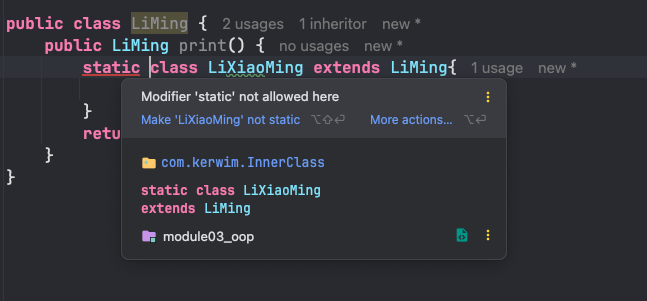
局部内部类还可以访问所在方法中的局部变量,不过这个局部变量必须是:
final
或者 effectively final也就是赋值之后不再修改。
例如:
public class Demo {
public void test() {
String name = "kerwim";
class Inner {
public void print() {
System.out.println(name);
}
}
new Inner().print();
}
}这里:
name虽然没有显式写:
final但是后面没有再次修改,因此属于:
effectively final局部内部类可以正常访问。
12.3 匿名内部类
匿名内部类(Anonymous Class)是一种没有显式类名的内部类。
它通常用于:
临时继承一个类
或者
临时实现一个接口定义的同时直接创建对象。
例如以前启动线程时经常这样写:
public class ThreadDemo {
public static void main(String[] args) {
Thread thread =
new Thread(
new Runnable() {
@Override
public void run() {
System.out.println(
Thread.currentThread()
.getName()
);
}
}
);
thread.start();
}
}这里:
new Runnable() {
...
}并不是在创建 Runnable 对象,因为:
Runnable本身是接口,不能直接实例化。
实际上 Java 在这里创建了一个:
实现 Runnable 接口的匿名类然后马上创建这个匿名类的对象。
可以理解为:
定义一个匿名实现类
+
创建这个类的对象
↓
一次完成如果不用匿名内部类,大致需要先写:
class MyRunnable
implements Runnable {
@Override
public void run() {
System.out.println(
Thread.currentThread().getName()
);
}
}再:
new Thread(
new MyRunnable()
).start();匿名内部类把这两个步骤合在了一起。
12.3.1 匿名内部类没有显式构造方法
因为匿名内部类没有类名,所以无法像普通类一样声明构造方法。
例如不存在:
public Xxx() {
}这种写法。
不过匿名内部类可以定义实例初始化块:
Runnable runnable =
new Runnable() {
{
System.out.println(
"匿名内部类初始化"
);
}
@Override
public void run() {
System.out.println("run");
}
};编译之后,匿名内部类通常会生成类似:
ThreadDemo$1.class这样的字节码文件。
其中:
$1是编译器生成的编号。
如果还有第二个匿名内部类,可能会继续出现:
ThreadDemo$2.class12.3.2 匿名内部类和 Lambda
从 Java 8 开始,如果接口属于函数式接口,很多匿名内部类都可以用 Lambda 简化。
例如:
new Thread(
new Runnable() {
@Override
public void run() {
System.out.println("Hello");
}
}
).start();可以简化为:
new Thread(
() -> System.out.println("Hello")
).start();因此现在实际开发中,像:
Runnable
Comparator
各种函数式接口这类场景更多会使用 Lambda。
不过匿名内部类依然有自己的使用场景,例如:
需要继承一个普通类
需要定义额外成员
不适合使用 Lambda12.4 静态内部类
使用:
static修饰的嵌套类,通常称为静态内部类。
更准确的名称是:
静态嵌套类
Static Nested Class例如:
public class LiHong {
private static int age = 18;
private double money = 100;
static class LiXiaoHong {
public void print() {
// 可以直接访问外部类静态成员
System.out.println(age);
}
}
}静态内部类和普通成员内部类最大的区别就是:
静态内部类不依赖某一个具体的外部类对象。
因此可以直接创建:
LiHong.LiXiaoHong inner =
new LiHong.LiXiaoHong();不需要先:
LiHong outer = new LiHong();再通过:
outer.new LiXiaoHong();创建。
12.4.1 静态内部类不能直接访问外部类实例成员
例如:
public class LiHong {
private static int age = 18;
private double money = 100;
static class LiXiaoHong {
public void print() {
System.out.println(age);
// 编译错误
// System.out.println(money);
}
}
}IDE 会提示:
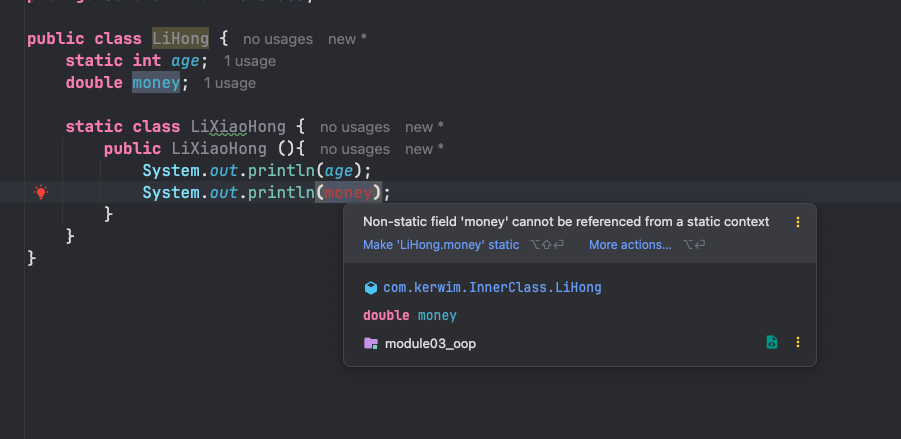
原因也很简单。
调用:
new LiHong.LiXiaoHong();时根本没有创建:
LiHong对象。
因此静态内部类不知道:
应该访问哪一个 LiHong 对象的 money?如果确实需要访问,可以显式创建外部类对象:
LiHong liHong = new LiHong();
System.out.println(liHong.money);所以可以对比:
成员内部类
↓
依附于外部类对象
↓
可以直接访问外部类实例成员
静态内部类
↓
属于外部类本身
↓
不依附外部类对象
↓
不能直接访问外部类实例成员12.5 为什么使用内部类
内部类并不是为了“炫技”,主要还是用来解决一些结构和封装问题。
比较常见的作用有下面几个。
12.5.1 增强封装
如果一个类只服务于另外一个类,就没有必要把它单独暴露出去。
例如:
public class Computer {
private class CpuController {
}
}CpuController 只属于 Computer 内部实现的一部分,外部代码没有必要知道它的存在。
这样可以把:
实现细节隐藏在外部类内部。
12.5.2 逻辑上把关系紧密的类放在一起
例如:
Map.EntryEntry 本身就是:
Map 中的一组键值对所以把它定义在 Map 内部,在逻辑上比较自然。
调用时也很清楚:
Map.Entry一眼就能看出两者之间的关系。
12.5.3 内部类可以直接访问外部类状态
成员内部类能够直接使用外部类的成员变量和方法。
例如:
public class Window {
private String title = "首页";
class ButtonListener {
public void click() {
System.out.println(
"关闭:" + title
);
}
}
}内部类不需要额外把:
title作为参数传进来。
12.5.4 一个外部类中可以存在不同的内部实现
同一个外部类中,可以定义多个内部类,让它们分别实现不同接口或者不同逻辑。
例如:
public class Computer {
class UsbController
implements Runnable {
}
class NetworkController
implements Runnable {
}
}两个内部类虽然都实现:
Runnable但可以拥有完全不同的实现。
12.5.5 适合处理一些临时实现
匿名内部类尤其适合:
只使用一次的实现
回调
监听器
简单策略例如:
button.addActionListener(
new ActionListener() {
@Override
public void actionPerformed(
ActionEvent e) {
System.out.println(
"按钮被点击"
);
}
}
);不过现代 Java 中,如果对应接口是函数式接口,通常还可以继续使用 Lambda 简化。
12.6 四种内部类对比
最后简单对比一下:
| 类型 | 定义位置 | 是否依赖外部对象 | 主要特点 |
|---|---|---|---|
| 成员内部类 | 类内部 | 是 | 可以直接访问外部类实例成员 |
| 局部内部类 | 方法或代码块内部 | 根据所在上下文 | 只在当前作用域可见 |
| 匿名内部类 | 表达式中临时定义 | 根据所在上下文 | 没有显式类名,定义后立即创建对象 |
| 静态内部类 | 类内部,使用 static | 否 | 不能直接访问外部类实例成员 |
可以简单记成:
成员内部类
↓
属于某个外部对象
局部内部类
↓
只在局部作用域使用
匿名内部类
↓
只想临时用一次
静态内部类
↓
只是逻辑上属于外部类
↓
不依赖外部类对象实际项目中比较常见的主要是:
静态内部类
匿名内部类成员内部类和局部内部类也会遇到,但相对少一些。
学习内部类时最重要的不是记住复杂语法,而是搞清楚:
这个内部类是否依赖外部类对象?
它能访问哪些外部成员?
它的作用域在哪里?这三个问题基本搞清楚,内部类也就比较容易理解了。
13 Java封装、继承和多态
13.1 三大特征概述
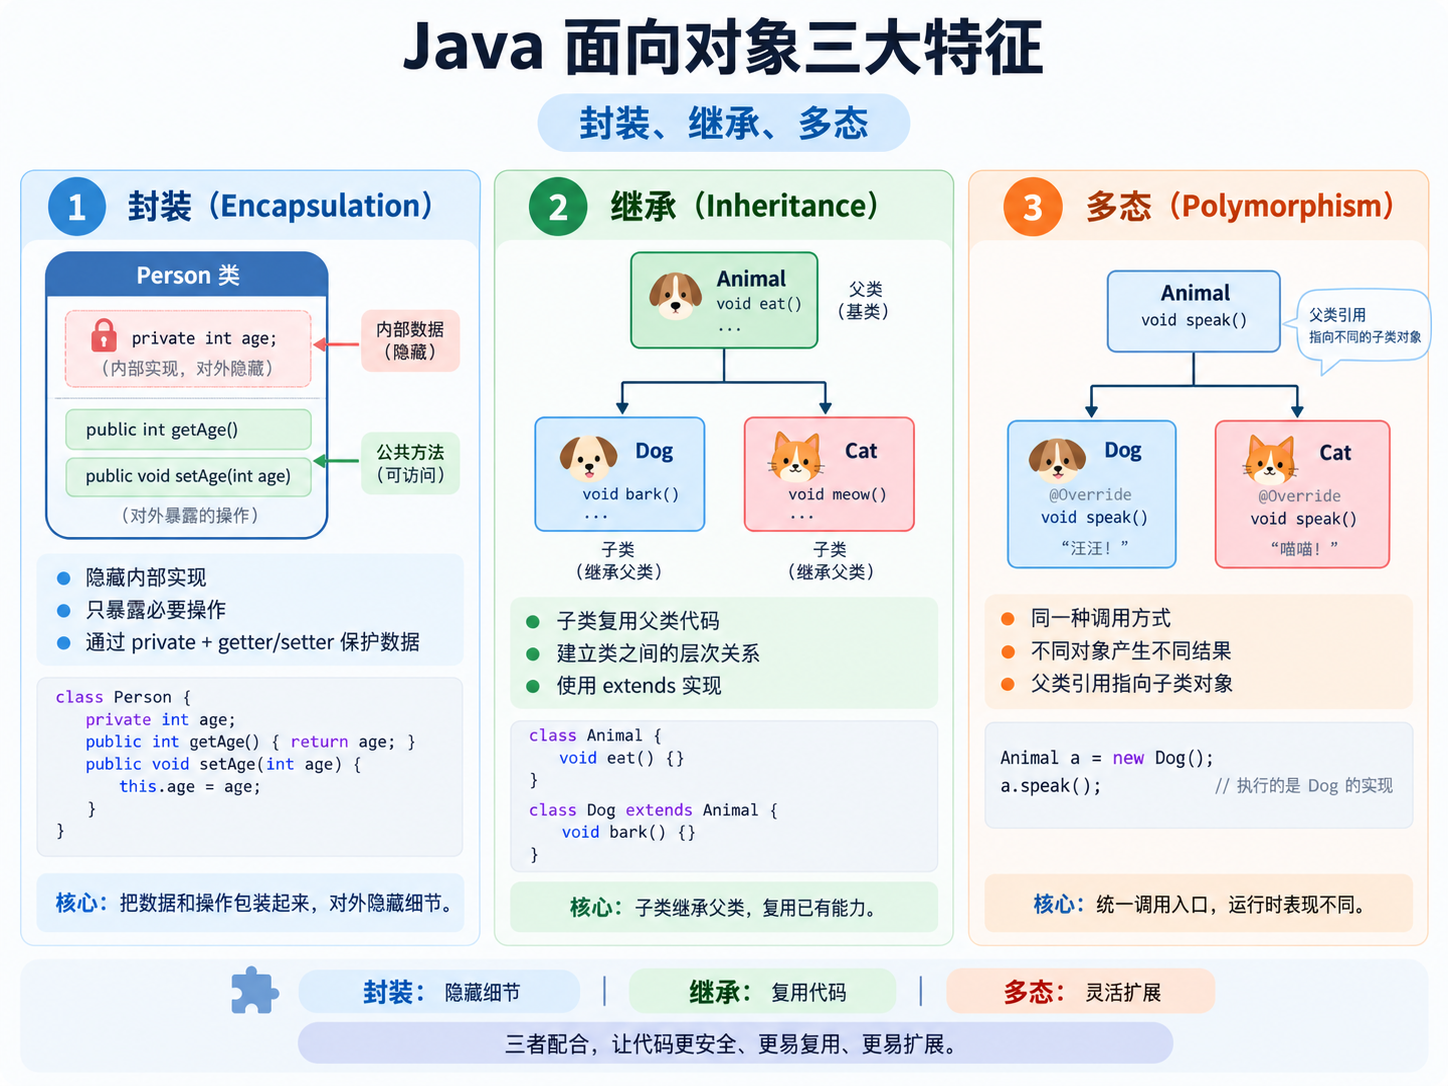
Java 面向对象中,经常会提到三个核心特征:
封装
继承
多态这三个特征彼此关联,但解决的问题并不一样。
可以先简单理解为:
封装
↓
隐藏内部实现,只暴露必要的操作
继承
↓
复用已有代码,建立类之间的层次关系
多态
↓
同一种调用方式,根据实际对象表现出不同的行为例如:
Animal
├── Dog
└── Cat可以把动物共有的属性和行为封装在类中;
Dog、Cat 可以通过继承复用 Animal 中的公共代码;
当使用:
Animal animal = new Dog();调用同一个方法时,又可以根据实际对象执行 Dog 自己的实现,这就是多态。
所以三者可以简单概括为:
封装负责隐藏细节,继承负责代码复用,多态负责统一调用和灵活扩展。
后面分别来看这三个特征。
13.2 封装
封装(Encapsulation)可以简单理解为:
把数据和操作数据的方法放在一起,隐藏内部实现,只对外暴露必要的访问方式。
例如一个 Person 对象内部可能保存:
name
age
sex外部代码并不一定需要知道这些数据具体如何保存,只需要通过类提供的方法来操作即可。
可以理解为:
外部代码
↓
公开的方法
↓
┌──────────────────┐
│ 对象内部 │
│ │
│ private 数据 │
│ 内部实现逻辑 │
│ │
└──────────────────┘封装并不是单纯地:
private + Getter + Setter更重要的是:
隐藏不应该暴露的内容
只开放真正需要的操作
控制数据如何被读取和修改封装通常有几个好处:
- 隐藏内部实现细节。
- 降低类与类之间的耦合。
- 可以控制数据的读取和修改。
- 内部实现发生变化时,尽量不影响外部调用。
13.2.1 隐藏对象内部数据
例如定义 Husband:
public class Husband {
// 对象内部状态
private String name;
private String sex;
private int age;
private Wife wife;
// 对外提供需要的访问方式
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}
public String getSex() {
return sex;
}
public void setSex(String sex) {
this.sex = sex;
}
public int getAge() {
return age;
}
public void setAge(int age) {
this.age = age;
}
public void setWife(Wife wife) {
this.wife = wife;
}
}再定义 Wife:
public class Wife {
private String name;
private int age;
private String sex;
private Husband husband;
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}
public String getSex() {
return sex;
}
public void setSex(String sex) {
this.sex = sex;
}
public void setAge(int age) {
this.age = age;
}
public Husband getHusband() {
return husband;
}
public void setHusband(Husband husband) {
this.husband = husband;
}
}这里并不是所有字段都一定要提供 Getter 和 Setter。
例如:
private Wife wife;如果不希望外部直接获取:
wife那就完全可以不提供:
getWife()所以:
字段是否对外提供访问方式,应该根据业务需要决定,而不是机械地给所有字段生成 Getter 和 Setter。
13.2.2 房子的例子
封装可以类比成一栋房子。
房子内部有:
沙发
电视
空调
家具
各种生活用品这些相当于对象内部的数据和实现。
墙把内部结构隐藏起来:
外部的人
↓
看不到所有内部细节但是房子也不能完全封死,还需要:
门
窗和外界交互。
对应到 Java 中:
墙
↓
private
门和窗
↓
public 方法所以封装不是:
把所有东西彻底藏起来而是:
隐藏内部细节,同时留下合理的访问入口。
13.2.3 降低对内部实现的依赖
如果不使用封装:
public class Husband {
public String name;
public String sex;
public int age;
public Wife wife;
}外部可以直接修改:
Husband husband = new Husband();
husband.name = "kerwim";
husband.sex = "男";
husband.age = 30;这样外部代码就直接依赖了:
字段名
字段类型
内部数据结构一旦内部发生变化,就很容易影响大量调用代码。
使用封装之后:
public class Husband {
private int age;
public int getAge() {
return age;
}
public void setAge(int age) {
this.age = age;
}
}外部只依赖:
husband.setAge(22);
husband.getAge();而不需要直接操作:
husband.age这样内部实现就拥有更大的调整空间。
例如,假设内部暂时改成字符串保存:
public class Husband {
private String age;
public int getAge() {
return Integer.parseInt(age);
}
public void setAge(int age) {
this.age = String.valueOf(age);
}
}外部依然可以保持:
husband.setAge(22);
int age = husband.getAge();调用方式不需要变化。
这就是封装非常重要的一点:
只要对外公开的接口保持稳定,内部实现可以在一定范围内自由调整。
13.2.4 控制数据的写入
封装还有一个很重要的作用,就是:
不允许外部随意修改对象状态。
如果字段直接公开:
public int age;那么外部完全可以:
Husband husband = new Husband();
husband.age = 300;语法没有任何问题,但这个数据显然不合理。
使用 Setter 后,就可以在统一入口进行校验:
public class Husband {
private int age;
public int getAge() {
return age;
}
public void setAge(int age) {
if (age < 0 || age > 120) {
throw new IllegalArgumentException(
"年龄必须在 0 ~ 120 之间"
);
}
this.age = age;
}
}这时:
husband.setAge(300);就会被拒绝。
可以理解为:
外部输入
↓
setAge()
↓
校验
↓
合法
↓
写入 age这样就可以保证对象内部的数据始终处于一个比较合理的状态。
13.2.5 控制数据的读取
封装不仅可以控制数据怎么写,也可以控制数据怎么读。
例如数据库中可能使用:
0 → 女
1 → 男保存性别。
内部可以保留原始值:
private String sex;但对外可以提供更有意义的方法:
public String getSexName() {
if ("0".equals(sex)) {
return "女";
}
if ("1".equals(sex)) {
return "男";
}
return "未知";
}外部只需要:
System.out.println(
husband.getSexName()
);而不需要每个调用者都自己写:
0 怎么转换
1 怎么转换类似地,还可以把内部状态:
0
1
2转换成:
待处理
已完成
已取消再提供给外部使用。
不过需要注意:
类本身应该负责自己的业务状态和领域逻辑,不建议直接在实体类 Getter 中拼接 HTML、页面按钮之类的前端代码。
例如这种旧式写法:
public String getOperationHtml() {
return "<a>...</a>";
}会把:
数据模型
业务逻辑
页面展示混在一起,实际项目中通常应该放到更合适的展示层处理。
13.2.6 封装不等于 Getter 和 Setter
初学 Java 时经常会看到:
private String name;
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}于是很容易形成一个印象:
封装 = private + Getter + Setter其实并不准确。
例如一个银行账户:
public class Account {
private BigDecimal balance;
public BigDecimal getBalance() {
return balance;
}
}如果为了所谓的“封装”,再提供:
public void setBalance(
BigDecimal balance) {
this.balance = balance;
}那么外部就可以直接:
account.setBalance(
new BigDecimal("99999999")
);显然不合理。
更好的方式可能是只提供真正有业务意义的方法:
public class Account {
private BigDecimal balance =
BigDecimal.ZERO;
public BigDecimal getBalance() {
return balance;
}
public void deposit(
BigDecimal amount) {
// 存款逻辑
balance = balance.add(amount);
}
public void withdraw(
BigDecimal amount) {
// 取款逻辑
balance = balance.subtract(amount);
}
}外部操作的是:
deposit()
withdraw()而不是直接:
setBalance()这才更能体现封装的思想:
数据
+
操作数据的规则
↓
一起放在对象内部
↓
只提供合理的操作入口所以封装最核心的理解可以总结为:
封装
↓
隐藏内部实现
↓
控制访问入口
↓
保护对象状态
↓
降低外部对内部实现的依赖一句话概括:
封装不是把字段全部变成 private,而是让对象自己管理自己的数据和行为,对外只暴露必要且合理的操作。
13.3 继承
13.3.1 什么是继承
继承(Inheritance)是面向对象的核心特征之一。
在 Java 中,可以让一个类在已有类的基础上继续扩展,这个过程就是继承。
被继承的类称为:
父类 / 超类(Superclass)继承父类的类称为:
子类(Subclass)Java 使用:
extends关键字表示继承关系。
例如:
public class Dog extends Animal {
}这里:
Animal → 父类
Dog → 子类子类可以复用父类中已有的属性和方法,同时也可以增加自己的功能,或者重写父类已有的方法。
来看一个比较直观的例子。
动物有很多种,例如:
Animal
├── Dog
├── Cat
└── Chicken它们虽然是不同的动物,但都有一些共同特征:
名字
年龄
体重
吃东西
发出声音因此可以把这些共同内容放在 Animal 中,再让具体的动物继承它。
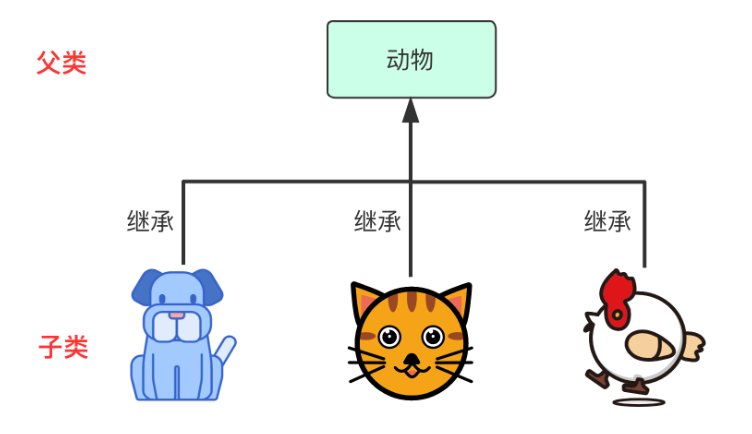
例如:
public class Animal {
protected int id;
protected String name;
protected int age;
protected int weight;
public Animal(
int id,
String name,
int age,
int weight) {
this.id = id;
this.name = name;
this.age = age;
this.weight = weight;
}
public void sayHello() {
System.out.println("hello");
}
public void eat() {
System.out.println("I'm eating");
}
public void sing() {
System.out.println("sing");
}
}定义 Dog:
public class Dog extends Animal {
public Dog(
int id,
String name,
int age,
int weight) {
super(id, name, age, weight);
}
public void bark() {
System.out.println("汪汪");
}
}创建对象:
Dog dog =
new Dog(
1,
"旺财",
3,
20
);
// 从父类继承的方法
dog.eat();
// Dog 自己的方法
dog.bark();可以理解为:
Animal
├── id
├── name
├── age
├── weight
├── eat()
├── sayHello()
└── sing()
↓
继承
↓
Dog
├── 复用 Animal 的成员
└── bark()所以继承表达的通常是一种:
is-a关系。
例如:
Dog is an Animal
Cat is an Animal也就是说,狗是一种动物,猫也是一种动物。
13.3.2 为什么需要继承
如果只有两三个很简单的类,重复写一点代码可能看不出什么问题。
但实际项目中,很多类往往拥有大量共同的属性和行为。
例如:
Dog
Cat
Chicken如果完全不使用继承,可能每个类都需要重复定义:
id
name
age
weight
eat()
sayHello()
sing()这样会产生大量重复代码。
例如:
Dog
├── name
├── age
├── eat()
└── sing()
Cat
├── name
├── age
├── eat()
└── sing()
Chicken
├── name
├── age
├── eat()
└── sing()这些公共内容显然可以抽取出来。
于是可以设计成:
Animal
│
公共属性 + 公共方法
│
┌──────────┼──────────┐
↓ ↓ ↓
Dog Cat Chicken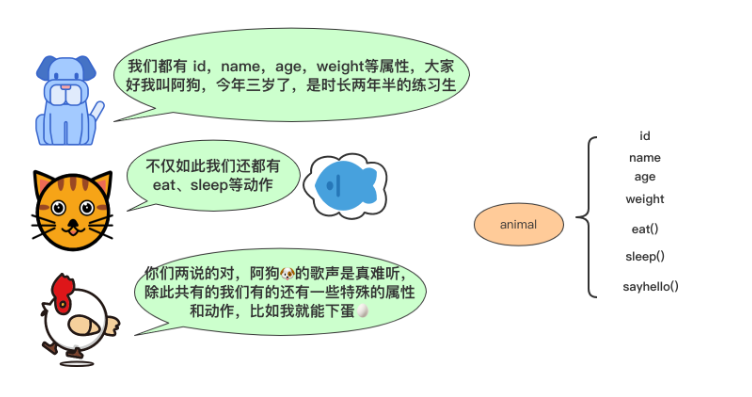
这样 Dog、Cat、Chicken 只需要继承:
extends Animal就可以复用父类已有的功能。
例如:
public class Cat extends Animal {
public Cat(
int id,
String name,
int age,
int weight) {
super(id, name, age, weight);
}
public void catchMouse() {
System.out.println("抓老鼠");
}
}Cat 不需要再重新编写:
name
age
weight
eat()这些公共内容,而只需要关心自己特有的行为:
catchMouse();如果父类中的某个方法不符合子类需求,还可以通过方法重写改变它的行为。
例如:
public class Dog extends Animal {
public Dog(
int id,
String name,
int age,
int weight) {
super(id, name, age, weight);
}
@Override
public void sing() {
System.out.println("汪汪");
}
}这样:
Dog dog =
new Dog(
1,
"旺财",
3,
20
);
dog.sing();输出:
汪汪所以继承主要解决两个问题:
公共代码重复
↓
父类统一提供
↓
子类直接复用
子类存在不同需求
↓
增加自己的方法
或者重写父类方法继承带来的主要好处就是:
- 减少重复代码。
- 提高代码复用性。
- 建立清晰的类层次关系。
- 子类可以在父类基础上继续扩展。
不过继承也不是单纯为了“少写代码”。
使用继承时,父类和子类之间应该存在比较明确的:
is-a关系。
例如:
Dog extends Animal很自然。
但如果两个类只是:
一个对象拥有另外一个对象这种:
has-a关系,通常应该优先考虑组合,而不是为了复用几行代码强行使用继承。
另外需要注意:
子类并不是可以直接访问父类的所有成员。
例如父类中的:
private String name;子类不能直接通过:
name访问。
private 成员仍然受到访问权限控制,可以通过父类提供的 protected 或 public 方法进行访问。
所以继承可以简单概括为:
父类
↓
抽取公共属性和行为
↓
子类 extends 父类
↓
复用已有功能
+
扩展自己的功能
+
重写需要改变的行为一句话理解:
继承就是在已有类的基础上继续扩展,让子类复用父类的公共能力,同时保留自己的特征。
13.3.3 继承的分类
从类的继承关系来看,通常会提到:
单继承
多继承
多层继承Java 在类的继承上有一个很重要的规则:
一个 Java 类只能直接继承一个父类,不支持类的多继承。
但是 Java 可以通过:
多层继承
实现多个接口获得更加丰富的类型和能力。
13.3.3.1 单继承
单继承指的是:
一个子类只有一个直接父类。
例如:
public class Animal {
}public class Dog extends Animal {
}关系如下:
Animal
↓
Dog Java 的类采用的就是单继承机制。
例如:
public class Dog extends Animal {
}是合法的。
但是下面这种写法不允许:
public class Dog extends Animal, Pet {
}也就是说:
一个类
↓
只能有一个直接父类这样做的好处是继承关系比较清晰,也避免了多个父类之间出现成员冲突的问题。
13.3.3.2 多继承
多继承指的是:
一个子类同时拥有多个直接父类。
例如从概念上来说:
ClassA ClassB
\ /
\ /
ClassC
一些面向对象语言允许这样的类继承方式。
多继承的好处是,一个子类可以同时复用多个父类中的能力。
但问题也比较明显:
如果多个父类中存在同名方法,子类到底应该继承哪一个?
例如:
Parent
/ \
A B
\ /
C如果:
A 重写了 test()
B 也重写了 test()那么 C 再同时继承 A 和 B 时:
c.test();到底应该执行:
A.test()
还是
B.test()就会产生歧义。
这也是经典的:
菱形继承问题
Diamond Problem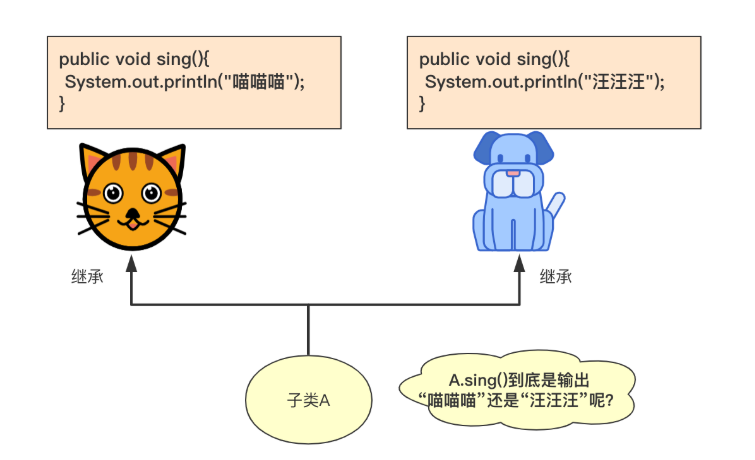
Java 为了避免这种复杂关系,不允许一个类同时继承多个类。
13.3.3.3 多层继承
Java 虽然不支持类的多继承,但支持多层继承。
多层继承指的是:
子类继承父类
父类又继承另一个父类例如:
public class Animal {
}public class Mammal extends Animal {
}public class Dog extends Mammal {
}关系就是:
Animal
↓
Mammal
↓
Dog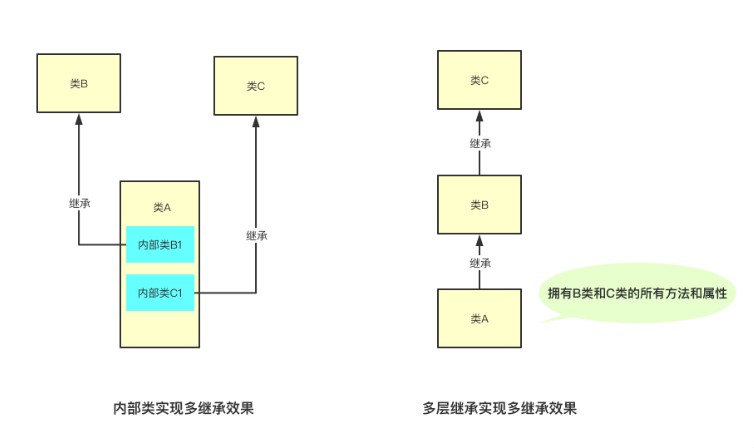
这里:
Dog 的直接父类是 Mammal
Mammal 的直接父类是 Animal因此 Dog 最终也属于:
Animal这种关系可以一直向上延伸。
例如:
Object
↓
Animal
↓
Mammal
↓
Dog实际上 Java 中除了 Object 本身之外,普通类最终都会直接或间接继承:
java.lang.Object需要注意:
多层继承并不等于多继承。
因为每一层仍然只有一个直接父类:
Dog → Mammal → Animal而不是:
Dog → Animal + Pet13.3.3.4 通过接口获得多种能力
Java 中最常见的“类似多继承”的能力,是通过接口实现的。
一个类虽然只能:
extends 一个类但是可以:
implements 多个接口例如:
public interface Fly {
void fly();
}public interface Run {
void run();
}一个类可以同时实现:
public class Pig
implements Fly, Run {
@Override
public void fly() {
System.out.println("会飞");
}
@Override
public void run() {
System.out.println("会跑");
}
}这样 Pig 就同时具备:
Fly
Run两种能力。
关系可以理解为:
Fly Run
\ /
\ /
Pig所以 Java 中:
类
↓
单继承
接口
↓
可以多实现这也是 Java 用来弥补类单继承限制的重要方式。
13.3.3.5 内部类能不能实现“多继承”?
有些资料会说,内部类也可以实现类似多继承的效果。
例如外部类继承一个类:
class Outer extends A {
}内部类又可以单独继承另外一个类:
class Outer extends A {
class Inner extends B {
}
}这样:
Outer → A
Inner → B确实可以在一个外部类结构中同时组合多个继承关系。
但严格来说:
这并不是 Outer 同时继承了 A 和 B。
它仍然是两个不同的类分别完成自己的单继承。
所以更准确地理解应该是:
内部类
↓
可以帮助组织多个独立的继承关系
但并没有改变 Java 类只支持单继承的规则13.3.3.6 一个简单的例子
可以用一个比较形象的例子理解:
假设一个角色本身有明确的父类关系:
Person
↓
SoulMaster
↓
TangSan这属于:
类继承表示:
TangSan is a SoulMaster与此同时,它还可能具有:
战斗
飞行
治疗
某种特殊能力这些能力就更适合使用接口描述:
public class TangSan
extends SoulMaster
implements Fightable,
Flyable {
}这样就可以同时保留:
单一、清晰的类继承体系
+
多个接口提供的能力所以 Java 中最重要的规则可以总结为:
一个类只能 extends 一个父类
一个类可以 implements 多个接口
Java 支持多层继承
Java 不支持类的多继承一句话记住:
Java 的类是单继承,接口可以多实现;多层继承不是多继承。
13.3.4 如何实现继承
Java 中类与类之间通过:
extends建立继承关系。
而类与接口之间通过:
implements建立实现关系。
可以先简单区分:
extends
↓
类继承类
implements
↓
类实现接口13.3.4.1 extends 关键字
Java 中的类采用单继承机制,也就是说:
一个子类只能直接继承一个父类。
基本语法:
class 子类名 extends 父类名 {
}例如 Dog 继承 Animal:
class Animal {
}
class Dog extends Animal {
}此时:
Animal
↓
DogAnimal 是父类,Dog 是子类。
子类可以继承并使用父类中允许它访问的成员,同时还可以增加自己的属性和方法。
例如父类定义一个 sayHello() 方法:
class Animal {
/**
* 父类方法
*/
public void sayHello() {
System.out.println("hello, everybody");
}
}Dog 继承 Animal:
class Dog extends Animal {
}测试:
public class Test {
public static void main(String[] args) {
Dog dog = new Dog();
// 调用从 Animal 继承的方法
dog.sayHello();
}
}输出:
hello, everybody
虽然 Dog 自己没有定义:
sayHello()但是因为:
Dog extends Animal所以可以直接使用父类中的这个方法。
需要注意,继承并不意味着子类可以直接访问父类的所有成员。
例如:
class Animal {
private String name;
}虽然 name 属于父类对象状态的一部分,但子类不能直接:
name = "旺财";访问它,因为:
private只允许在 Animal 类内部直接访问。
如果父类希望子类能够访问,可以根据需要提供:
protected
public 方法等方式。
另外,父类的构造方法也不会被子类继承,子类只能通过:
super(...)调用父类构造方法。
所以可以简单理解为:
extends
↓
建立父子类关系
↓
复用父类已有能力
↓
子类还可以继续扩展和重写13.3.4.2 implements 关键字
implements 用于:
类实现接口。
一个 Java 类只能直接继承一个父类,但是可以同时实现多个接口。
基本语法:
class 类名 implements 接口1, 接口2 {
}例如定义两个接口。
DoA:
interface DoA {
void sayHello();
}DoB:
interface DoB {
void eat();
}定义 Cat 同时实现两个接口:
class Cat implements DoA, DoB {
@Override
public void sayHello() {
System.out.println("hello!");
}
@Override
public void eat() {
System.out.println("I'm eating");
}
}测试:
public class Test2 {
public static void main(String[] args) {
Cat cat = new Cat();
cat.sayHello();
cat.eat();
}
}输出:
hello!
I'm eating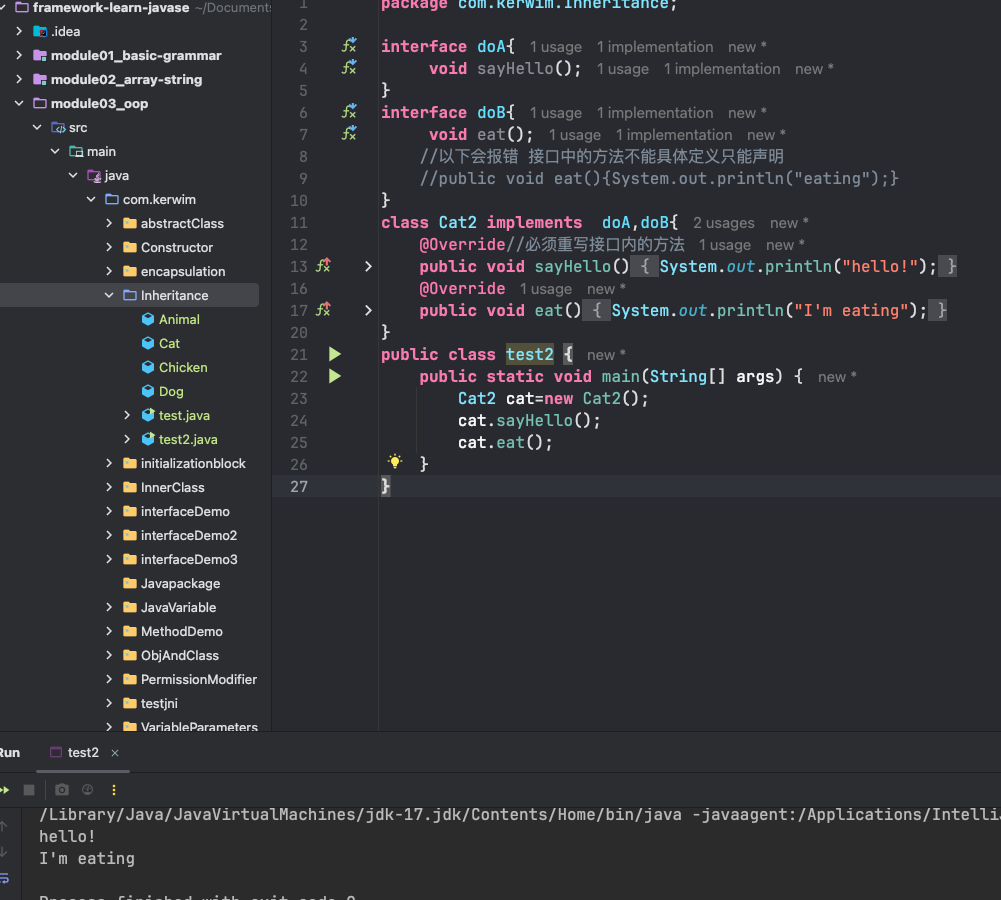
这里:
class Cat implements DoA, DoB表示 Cat 同时具备:
DoA 规定的能力
DoB 规定的能力对于接口中的抽象方法:
void sayHello();
void eat();如果 Cat 是一个普通类,就必须提供具体实现。
另外需要注意,接口并不是所有方法都只能声明、不能有方法体。
从 Java 8 开始,接口可以定义:
default 方法
static 方法从 Java 9 开始,还可以定义:
private 方法所以现代 Java 中更准确的说法是:
接口中的抽象方法需要由实现类完成具体实现,而接口本身也可以包含部分已经实现的方法。
Java 还允许继承类的同时实现多个接口:
class Cat
extends Animal
implements DoA, DoB {
}可以理解为:
Animal
│
↓
Cat
↙ ↘
DoA DoB所以:
extends
↓
一个类只能直接继承一个父类
implements
↓
一个类可以同时实现多个接口严格来说,implements 并不是让 Java 类拥有了真正的“多继承”,而是让一个类能够同时实现多种接口,从而具备多种能力。
13.3.5 继承的特点
学习继承时,有几个知识点经常会一起出现:
this 和 super
构造方法的调用顺序
方法重写 Override
方法重载 Overload其中:
this / super
↓
解决当前类和父类成员的访问问题
构造方法
↓
解决父类和子类如何完成初始化
方法重写
↓
子类改变父类已有行为
方法重载
↓
同一个方法名提供多种参数形式下面分别来看。
13.3.5.1 this 和 super 关键字
this 和 super 在继承体系中非常常见。
可以先简单区分:
this
↓
当前对象
super
↓
访问父类部分this
this 表示当前对象的引用。
常见用法有三种:
this.成员变量
this.方法()
this(...)例如:
public class Person {
private String name;
public Person(String name) {
// 当前对象的 name
this.name = name;
}
public void print() {
// 调用当前对象的方法
this.sayHello();
}
public void sayHello() {
System.out.println("Hello");
}
}这里:
this.name表示当前对象的成员变量,而右边的:
name表示方法参数。
所以:
this.name = name;就是:
把传入的 name
↓
赋值给当前对象的 namethis(...) 还可以用来调用当前类中的另一个构造方法:
public class Person {
private String name;
private int age;
public Person() {
// 调用本类的另一个构造方法
this("kerwim", 18);
}
public Person(
String name,
int age) {
this.name = name;
this.age = age;
}
}需要注意:
this(...)必须放在构造方法的第一条语句。
super
super 用来访问父类中可以访问的成员。
常见用法也有三种:
super.成员变量
super.方法()
super(...)例如:
class Animal {
protected String name = "Animal";
public void eat() {
System.out.println("Animal eat");
}
}子类:
class Dog extends Animal {
private String name = "Dog";
public void print() {
// 当前对象中的 name
System.out.println(this.name);
// 父类中的 name
System.out.println(super.name);
// 调用父类方法
super.eat();
}
}这里:
this.name访问的是:
Dog.name而:
super.name访问的是:
Animal.namesuper() 则用来调用父类构造方法:
public Dog() {
super();
}需要注意:
super并不是一个真正保存“父类对象”的引用变量,不能像普通对象引用一样赋值或传递。
它更像 Java 提供的一个特殊关键字,用来明确访问当前对象中的父类部分。
因此可以简单记住:
| 关键字 | 主要作用 |
|---|---|
this.xxx | 当前对象的成员 |
this(...) | 调用本类构造方法 |
super.xxx | 访问父类成员 |
super(...) | 调用父类构造方法 |
13.3.5.2 继承中的构造方法
构造方法比较特殊:
构造方法不能被继承,但创建子类对象时必须先完成父类部分的初始化。
例如:
class Animal {
public Animal() {
System.out.println("Animal 构造方法");
}
}class Dog extends Animal {
public Dog() {
System.out.println("Dog 构造方法");
}
}执行:
new Dog();输出:
Animal 构造方法
Dog 构造方法也就是说:
创建 Dog 对象
↓
先初始化 Animal 部分
↓
执行 Animal 构造方法
↓
再初始化 Dog 部分
↓
执行 Dog 构造方法这里需要注意:
并不是先创建一个独立的
Animal对象,再创建一个Dog对象。
实际上最终创建的是一个 Dog 对象,只不过这个对象中包含从父类继承而来的部分,需要先完成父类部分的初始化。
父类构造方法不能被继承
例如父类:
class A {
public A() {
}
public A(String name) {
}
}子类:
class B extends A {
}B 并不会因此拥有:
B(String name)构造方法。
构造方法的名字必须和自己的类名相同,因此:
A()始终是 A 的构造方法。
B()始终是 B 的构造方法。
但是子类构造方法可以通过:
super(...)调用父类构造方法。
例如:
class A {
public String name;
public A() {
}
public A(String name) {
this.name = name;
}
}class B extends A {
public B() {
// 调用父类无参构造
super();
}
public B(String name) {
// 调用父类有参构造
super(name);
}
}默认调用父类无参构造
如果子类构造方法没有显式写:
super(...)也没有写:
this(...)那么编译器会自动在第一行加入:
super();例如:
class B extends A {
public B() {
System.out.println("B");
}
}可以理解为:
class B extends A {
public B() {
// 编译器隐式添加
super();
System.out.println("B");
}
}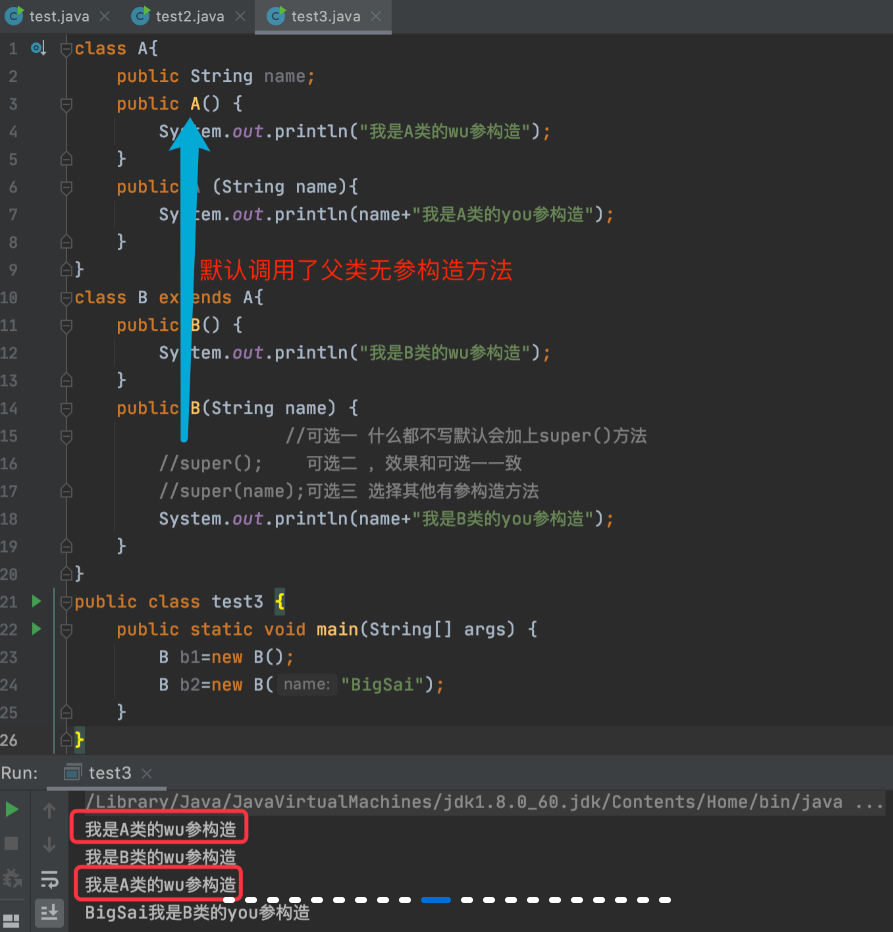
不过这里有一个非常重要的前提:
父类必须存在可以调用的无参构造方法。
例如:
class A {
public A(String name) {
}
}此时父类已经没有默认无参构造。
如果子类仍然写:
class B extends A {
public B() {
}
}编译器会尝试加入:
super();但是:
A()并不存在,因此会编译报错。
这时候必须明确调用父类已有的构造方法:
class B extends A {
public B() {
super("kerwim");
}
}另外:
super(...)和:
this(...)都必须位于构造方法第一行,因此一个构造方法中不能同时直接写:
this(...);
super(...);13.3.5.3 方法重写 Override
方法重写(Override)发生在父子类之间。
当子类继承父类后,觉得父类提供的某个方法不符合自己的需求,就可以重新实现这个方法。
例如父类:
class E1 {
public void doA(int a) {
System.out.println("这是父类的方法");
}
}子类:
class E2 extends E1 {
@Override
public void doA(int a) {
System.out.println(
"这是子类重写后的方法"
);
}
}调用:
E2 e2 = new E2();
e2.doA(10);输出:
这是子类重写后的方法可以简单理解为:
父类
↓
提供默认行为
子类
↓
继承父类
↓
重新实现同一个方法重写时主要需要满足:
方法名相同
参数列表相同
返回类型相同或属于协变返回类型
访问权限不能比父类更严格例如:
@Override
public void doA(int a) {
}其中:
@Override不是必须写的,但强烈建议保留。
它可以让编译器帮我们检查:
这个方法到底是不是真的重写了父类方法。
例如不小心把参数写错:
@Override
public void doA(double a) {
}编译器就会直接提示错误,而不是悄悄变成另一个重载方法。
另外:
private 方法
final 方法不能被子类重写。
其中 private 方法对子类本身不可见,而 final 方法明确禁止重写。
13.3.5.4 方法重载 Overload
方法重载(Overload)指的是:
方法名相同,但参数列表不同。
例如:
class E3 {
public int add(
int a,
int b) {
return a + b;
}
public double add(
double a,
double b) {
return a + b;
}
public int add(
int a,
int b,
int c) {
return a + b + c;
}
}虽然三个方法都叫:
add()但是参数列表不同:
add(int, int)
add(double, double)
add(int, int, int)因此属于方法重载。
调用时,编译器会根据传入的参数选择合适的方法:
E3 e3 = new E3();
e3.add(1, 2);
e3.add(1.5, 2.5);
e3.add(1, 2, 3);需要注意:
返回值类型不同,不能单独作为方法重载的依据。
例如:
public int getData() {
return 1;
}和:
public String getData() {
return "1";
}不能同时存在,因为它们的:
方法名相同
参数列表也相同编译器无法仅根据返回值判断到底调用哪个方法。
13.3.5.5 重写和重载的区别
Override 和 Overload 名字比较像,但其实是两个完全不同的概念。
| 对比项 | 重写 Override | 重载 Overload |
|---|---|---|
| 发生位置 | 父类和子类之间 | 同一个类中最常见,也可以出现在继承体系中 |
| 方法名 | 相同 | 相同 |
| 参数列表 | 必须相同 | 必须不同 |
| 返回类型 | 相同或协变返回类型 | 可以不同,但不能只靠返回类型区分 |
| 主要作用 | 改变父类已有行为 | 给同一个功能提供不同参数形式 |
| 与多态关系 | 是运行时多态的重要基础 | 编译期根据参数确定调用哪个方法 |
可以简单记成:
Override
↓
父类已经有
↓
子类重新写
Overload
↓
方法名字一样
↓
参数不一样
↓
提供多种调用方式一句话区分:
重写是“子类重新实现父类方法”,重载是“同一个方法名提供不同参数版本”。
13.3.6 继承与修饰符
Java 中的修饰符会直接影响成员能否被继承、访问或者重写。
大致可以分为两类:
访问权限修饰符
├── public
├── protected
├── 默认(package-private)
└── private
非访问修饰符
├── static
├── final
└── abstract在继承中,需要重点关注:
访问权限能不能缩小
方法能不能被重写
static 方法如何继承
final 能不能修改
abstract 如何要求子类实现13.3.6.1 访问权限修饰符
子类重写父类方法时,有一个非常重要的规则:
子类重写方法的访问权限不能比父类方法更严格。
访问范围从小到大可以简单理解为:
private
↓
默认
↓
protected
↓
public例如父类方法是:
protected void test() {
}子类重写时可以使用:
protected void test() {
}或者扩大权限:
public void test() {
}但不能缩小成:
void test() {
}或者:
private void test() {
}来看一个完整例子:
class A1 {
// private 方法对子类不可见,不能被真正重写
private void doA() {
}
// 默认访问权限
void doB() {
}
protected void doC() {
}
public void doD() {
}
}子类:
class A2 extends A1 {
/**
* 默认 → public
* 扩大访问权限
*/
@Override
public void doB() {
}
/**
* protected → protected
* 保持访问权限不变
*/
@Override
protected void doC() {
}
/**
* public → public
* 不能降低为 protected / 默认 / private
*/
@Override
public void doD() {
}
}对应关系可以记成:
父类方法 子类重写允许的权限
默认 → 默认 / protected / public
protected → protected / public
public → publicprivate 方法比较特殊。
例如:
class Parent {
private void test() {
}
}子类即使再定义一个同名方法:
class Child extends Parent {
public void test() {
}
}这也不是方法重写。
因为父类的:
private void test()对子类不可见,所以两个方法彼此独立。
下面这种错误情况 IDE 会直接提示:
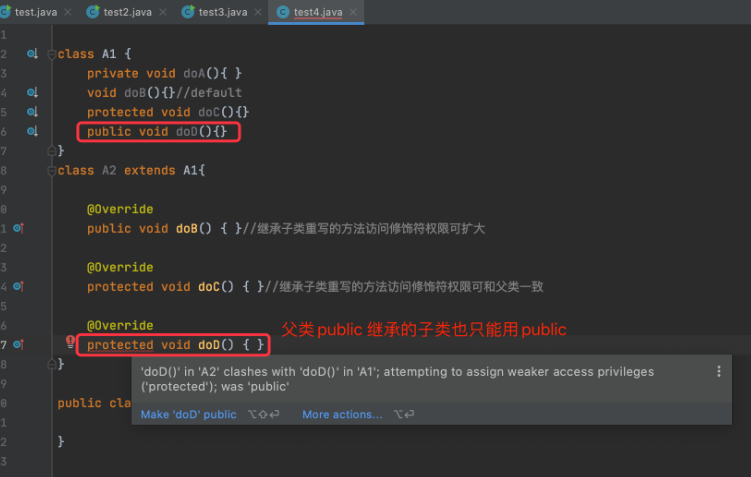
重写方法与异常
方法重写时,还需要注意 throws 声明。
对于**受检异常(Checked Exception)**来说:
子类重写方法抛出的异常范围不能比父类更大。
例如父类:
import java.io.IOException;
class B1 {
public void doA()
throws Exception {
}
public void doB()
throws Exception {
}
public void doC()
throws IOException {
}
public void doD()
throws IOException {
}
}子类:
import java.io.IOException;
class B2 extends B1 {
/**
* 和父类异常范围一致
*/
@Override
public void doA()
throws Exception {
}
/**
* 子类异常范围更小
*/
@Override
public void doB()
throws IOException {
}
/**
* 与父类保持一致
*/
@Override
public void doC()
throws IOException {
}
/**
* 也可以不再声明受检异常
*/
@Override
public void doD() {
}
}下面这种写法不允许:
class Parent {
public void test()
throws IOException {
}
}class Child extends Parent {
@Override
public void test()
throws Exception {
}
}因为:
Exception比:
IOException范围更大。
IDE 会提示类似错误:
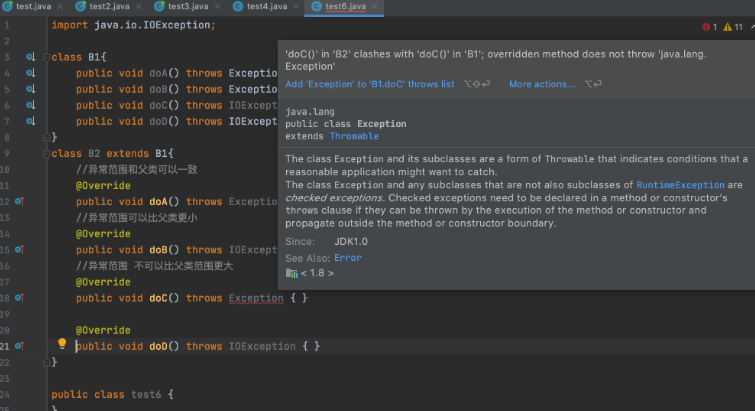
所以可以简单记成:
父类抛 Exception
↓
子类可以抛 Exception
也可以抛 IOException
也可以不抛
父类抛 IOException
↓
子类不能扩大成 Exception这里主要讨论的是受检异常。
RuntimeException 及其子类属于非受检异常,不受这条限制。
13.3.6.2 非访问修饰符
继承中比较常见的非访问修饰符主要有:
static
final
abstractstatic 修饰符
static 表示成员属于类本身,而不是某一个具体对象。
例如:
class C1 {
public static void doA() {
System.out.println("C1.doA()");
}
}可以直接通过类名调用:
C1.doA();不需要:
new C1();很多工具类都大量使用静态方法,例如:
Math
Arrays
Collections静态方法中没有当前对象,因此不能使用:
this和:
super例如:
class C2 extends C1 {
public static void doC() {
// 编译错误
// System.out.println(this);
// 编译错误
// super.doA();
}
}构造方法也不能使用 static 修饰:
class C1 {
// 编译错误
// public static C1() {
// }
}这里有一个非常容易混淆的地方:
静态方法不存在真正意义上的方法重写。
例如父类:
class C1 {
public static void doA() {
System.out.println("C1");
}
}子类:
class C2 extends C1 {
public static void doA() {
System.out.println("C2");
}
}这不是:
Override而叫:
方法隐藏(Method Hiding)静态方法最终根据引用的编译时类型 / 类名确定调用哪个方法,而不是像实例方法重写那样通过运行时多态决定。
所以:
实例方法
↓
可以重写
static 方法
↓
不能真正重写
↓
只能隐藏另外,父类静态方法不能在子类中改成普通实例方法,反过来也不行。
final 修饰符
final 可以修饰:
变量
方法
类它们的含义有所不同。
final 变量
final 修饰变量表示:
变量只能被赋值一次,赋值之后不能再次修改变量本身保存的值。
例如:
final int age = 18;
// 编译错误
// age = 20;final 成员变量必须在对象初始化完成前得到确定的值,可以:
final int age = 18;也可以通过构造方法赋值:
class Person {
private final String name;
public Person(String name) {
this.name = name;
}
}static final 经常用于定义常量:
public static final double PI = 3.1415926;如果 final 修饰的是引用变量:
final List<String> list =
new ArrayList<>();表示:
list 这个引用不能再指向另一个对象但并不代表对象本身完全不可修改。
例如:
list.add("kerwim");仍然是允许的。
所以不能简单理解为:
final = 对象内容全部不能修改更准确地说是:
final变量不能再次赋值。
final 方法
父类中的 final 方法:
class Parent {
public final void test() {
}
}可以被子类继承和使用,但不能被重写:
class Child extends Parent {
// 编译错误
// @Override
// public void test() {
// }
}所以:
final 方法
↓
允许继承
↓
禁止重写final 类
如果一个类使用:
final修饰:
public final class String {
}那么它不能再被其他类继承。
例如:
// 编译错误
// class MyString extends String {
// }典型的例子就是:
java.lang.String本身就是一个 final 类。
所以:
final 变量
↓
不能再次赋值
final 方法
↓
不能重写
final 类
↓
不能继承abstract 修饰符
abstract 表示“抽象的”,主要用来修饰:
类
方法抽象方法
抽象方法只有方法声明,没有方法体:
public abstract void sayHello();它只规定:
必须存在 sayHello() 这个行为至于具体怎么实现,则交给子类。
抽象类
包含抽象方法的类必须声明为抽象类:
abstract class People {
public abstract void sayHello();
}抽象类不能直接:
new People();但可以由具体子类继承。
例如:
class Chinese extends People {
@Override
public void sayHello() {
System.out.println("你好");
}
}class Japanese extends People {
@Override
public void sayHello() {
System.out.println("こんにちは");
}
}class American extends People {
@Override
public void sayHello() {
System.out.println("Hello");
}
}结构可以理解为:
People
│
abstract sayHello()
│
┌──────────┼──────────┐
↓ ↓ ↓
Chinese Japanese American
│ │ │
你好 こんにちは Hello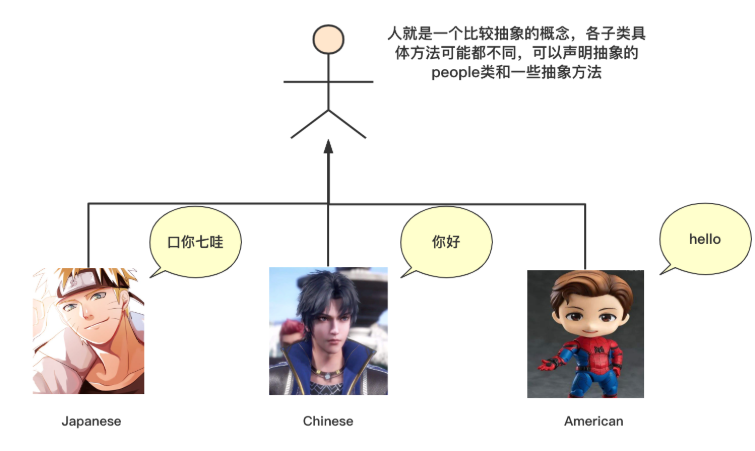
需要注意:
抽象类不一定必须包含抽象方法。
例如:
public abstract class BaseService {
public void log() {
System.out.println("log");
}
}这是完全合法的。
只是:
有抽象方法的类
↓
必须是抽象类而不是:
抽象类
↓
必须有抽象方法最后可以简单总结:
| 修饰符 | 在继承中的主要作用 |
|---|---|
private | 子类不能直接访问,private 方法不能被重写 |
protected | 同包可访问,不同包子类也可以通过继承关系访问 |
public | 访问范围最大 |
static | 属于类,静态方法只能隐藏,不能真正重写 |
final 变量 | 不能再次赋值 |
final 方法 | 可以继承,但不能重写 |
final 类 | 不能被继承 |
abstract 方法 | 要求具体子类实现 |
abstract 类 | 不能直接实例化 |
继承和修饰符放在一起看,核心其实就是三个问题:
这个成员能不能访问?
这个方法能不能重写?
这个类还能不能继续继承?把这三个问题搞清楚,继承中的修饰符基本就不会混了。
13.3.7 Object 类和类型转换
学习 Java 继承时,还有两个非常重要的知识点:
Object 类
对象的向上转型和向下转型Object 位于 Java 类继承体系的最顶端,而类型转换又建立在继承、多态的基础之上。
可以先简单理解为:
Object
↓
所有普通类继承体系的根
向上转型
↓
子类对象 → 父类引用
向下转型
↓
父类引用 → 恢复为具体子类引用关于 Object 类中的具体方法,前面已经单独整理过,这里主要从继承和类型转换的角度理解。
详细内容见:[[Object]]
13.3.7.1 Object 类概述
java.lang.Object 是 Java 类继承体系的根类。
如果一个类没有显式声明:
extends Xxx那么它会默认直接继承:
Object例如:
public class Person {
}实际上可以理解为:
public class Person
extends Object {
}如果存在多层继承:
class Animal {
}class Dog extends Animal {
}那么继承关系实际上是:
Object
↓
Animal
↓
Dog也就是说:
除了
Object本身之外,Java 中所有类最终都会直接或间接继承Object。
因此所有对象都拥有从 Object 继承而来的基础能力。
常见方法包括:
toString()
equals()
hashCode()
getClass()
wait()
notify()
notifyAll()Object 本身还有一个:
public Object()无参构造方法。
toString()
Object 默认的 toString() 实现返回类似:
类的完整名称@哈希值的十六进制表示例如:
com.example.Person@6d311334因此实际开发中,经常会根据对象内容重写:
toString()例如:
public class Person {
private String name;
private int age;
@Override
public String toString() {
return "Person{" +
"name='" + name + '\'' +
", age=" + age +
'}';
}
}这样直接:
System.out.println(person);就能够输出更有意义的对象信息。
equals()
Object 默认的:
equals()本质上比较的是:
两个引用是否指向同一个对象。
类似于:
this == obj但是在实际业务中,我们经常希望按照对象内容判断是否相等。
例如:
String就重写了:
equals()所以:
String a = new String("Java");
String b = new String("Java");
System.out.println(a == b);
System.out.println(a.equals(b));输出:
false
true原因是:
==
↓
比较是不是同一个对象
equals()
↓
String 重写以后
↓
比较字符串内容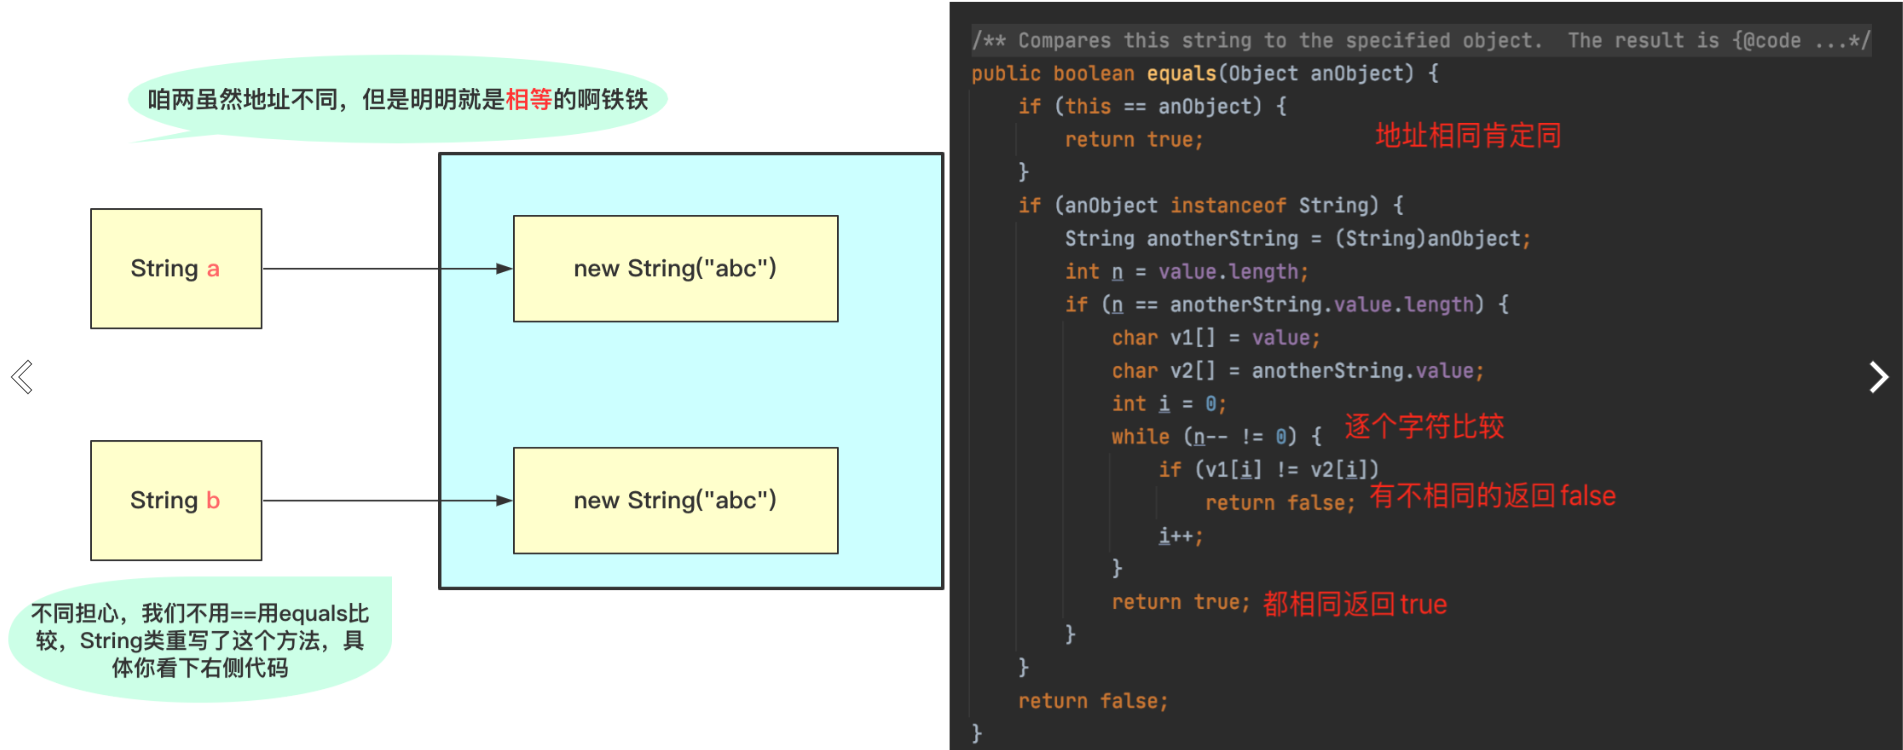
13.3.7.2 向上转型
向上转型(Upcasting)指的是:
使用父类类型的引用指向一个子类对象。
例如:
class Animal {
public void eat() {
System.out.println("Animal eat");
}
}class Dog extends Animal {
@Override
public void eat() {
System.out.println("Dog eat");
}
public void bark() {
System.out.println("汪汪");
}
}正常创建:
Dog dog = new Dog();向上转型:
Animal animal = new Dog();这里:
引用类型
↓
Animal
实际对象
↓
Dog关系可以理解为:
Animal animal
│
│ 指向
↓
Dog 对象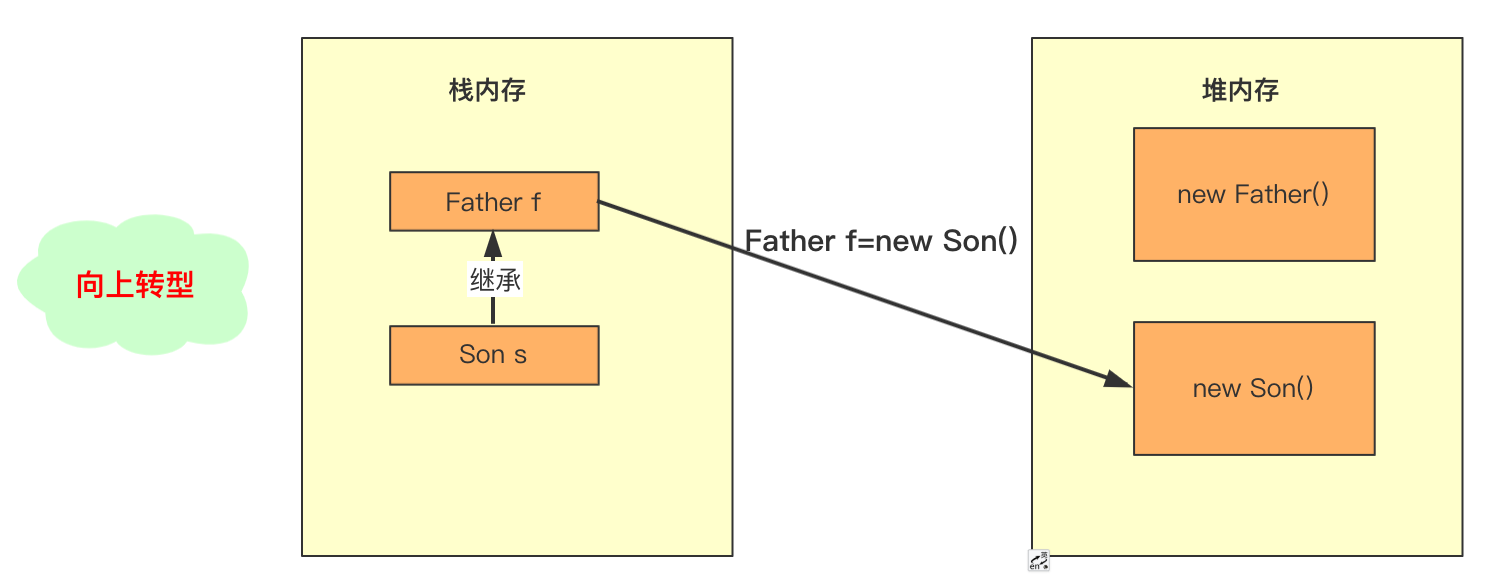
因为:
Dog is an Animal所以这种转换是安全的,Java 可以自动完成,不需要强制类型转换。
也可以写成:
Dog dog = new Dog();
Animal animal = dog;向上转型后可以调用什么?
向上转型之后:
Animal animal = new Dog();编译器主要根据:
引用类型 Animal决定当前可以调用哪些成员。
所以:
animal.eat();可以调用,因为 Animal 中声明了:
eat()但是:
// 编译错误
// animal.bark();不可以直接调用。
因为:
bark()只存在于 Dog 中,而当前引用类型:
Animal并不知道这个方法。
不过如果方法被子类重写:
animal.eat();真正执行的是:
Dog.eat()输出:
Dog eat这就是多态的重要表现:
编译时
↓
看引用类型
运行时
↓
重写方法看实际对象类型所以:
Animal animal = new Dog();
animal.eat();可以理解为:
能不能调用 eat()
↓
看 Animal 有没有声明
最终执行哪个 eat()
↓
看实际对象是不是 Dog这也是后面理解多态的核心。
13.3.7.3 向下转型
向下转型(Downcasting)指的是:
将父类类型的引用转换成具体的子类类型引用。
例如已经存在:
Animal animal = new Dog();此时实际对象仍然是:
Dog只是当前使用:
Animal类型的引用指向它。
如果希望重新使用 Dog 特有的方法:
bark()就可以进行向下转型:
Dog dog = (Dog) animal;
dog.bark();这里:
(Dog)就是强制类型转换。
过程可以理解为:
Dog 对象
↑
Animal 引用
↓
强制转换
↓
Dog 引用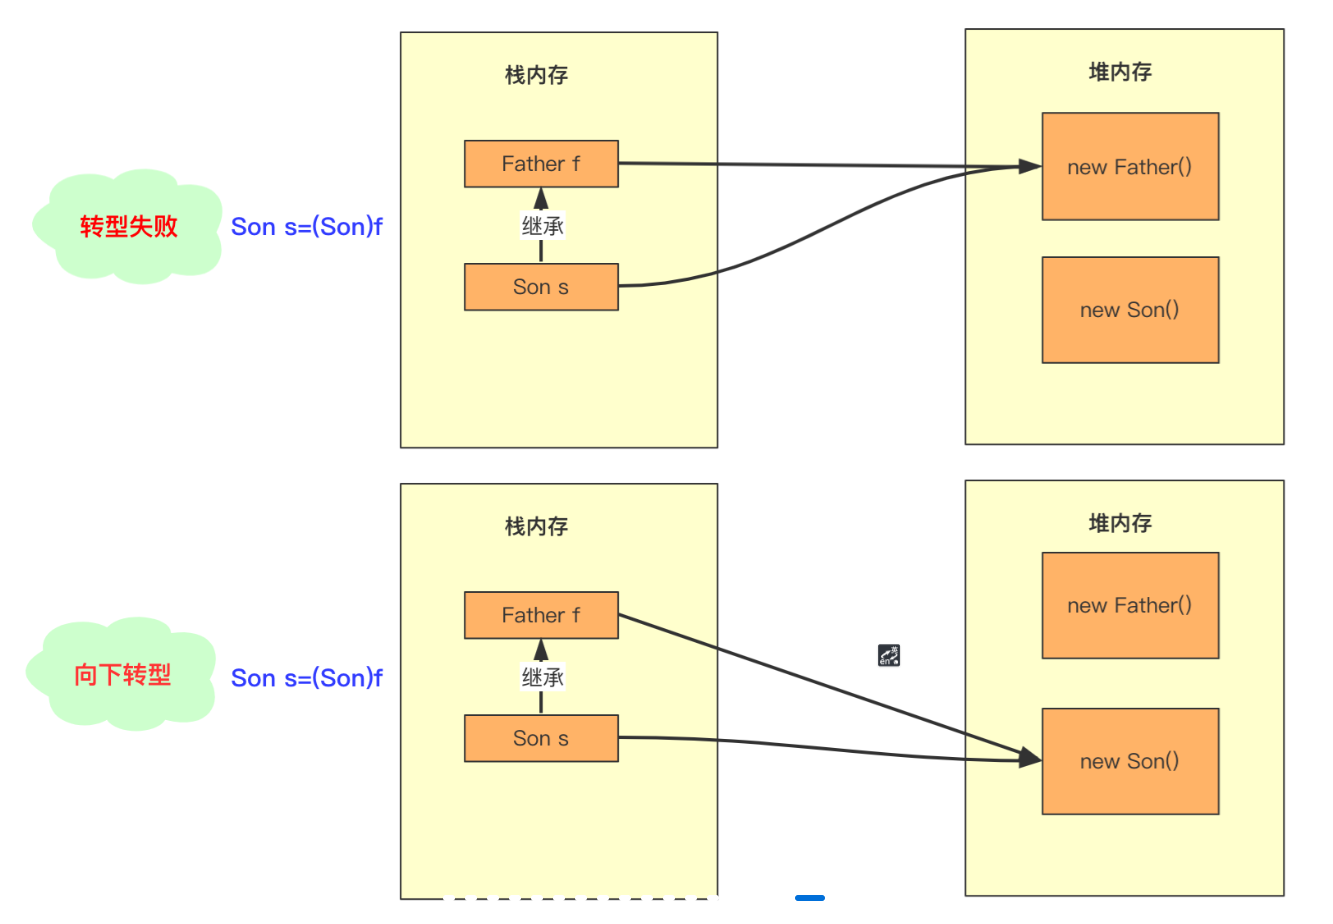
需要特别注意:
向下转型并不会创建新的对象。
例如:
Animal animal = new Dog();
Dog dog = (Dog) animal;整个过程中仍然只有最开始创建的那个:
new Dog()只是多了不同类型的引用指向同一个对象。
可以理解为:
Dog 对象
↑ ↑
│ │
animal dog
Animal Dog13.3.7.4 向下转型的风险
向上转型通常是安全的:
Animal animal = new Dog();因为:
Dog 一定是 Animal但是向下转型不一定安全。
例如:
Object object =
Integer.valueOf(666);这是向上转型:
Integer
↓
Object由于 object 实际指向的就是:
Integer 对象所以:
Integer number =
(Integer) object;可以正常运行。
但是:
String str =
(String) object;虽然编译器允许进行这种强制类型转换,但运行时会抛出:
ClassCastException原因是:
object 的实际对象
↓
Integer
试图转换成
↓
String而:
Integer 不是 String所以转换失败。
也就是说,向下转型最关键的不是:
引用变量声明成什么类型而是:
这个引用实际指向的对象到底是什么类型。
13.3.7.5 instanceof 判断类型
为了避免错误的向下转型,可以先使用:
instanceof进行判断。
例如:
Animal animal = new Dog();
if (animal instanceof Dog) {
Dog dog = (Dog) animal;
dog.bark();
}含义是:
animal 实际指向的对象
是不是 Dog 类型?如果是,再进行强制转换。
从较新的 Java 版本开始,还可以使用模式匹配:
if (animal instanceof Dog dog) {
dog.bark();
}这里:
animal instanceof Dog dog同时完成:
类型判断
+
类型转换
+
声明变量相比传统写法更加简洁。
13.3.7.6 向上转型和向下转型对比
| 对比项 | 向上转型 | 向下转型 |
|---|---|---|
| 英文 | Upcasting | Downcasting |
| 方向 | 子类 → 父类 | 父类引用 → 子类 |
| 是否需要强制转换 | 不需要 | 通常需要 |
| 安全性 | 通常安全 | 可能抛出 ClassCastException |
| 主要用途 | 多态、统一处理不同子类 | 恢复子类特有能力 |
| 是否创建新对象 | 否 | 否 |
例如:
Dog dog = new Dog();向上转型:
Animal animal = dog;向下转型:
Dog dog2 =
(Dog) animal;整个过程:
Dog 对象
↑
┌──────┴──────┐
│ │
Dog 引用 Animal 引用
↑ │
└── 向下转型 ←┘最后可以简单记成:
向上转型
↓
Dog → Animal
↓
自动完成
↓
为了统一使用父类型
向下转型
↓
Animal → Dog
↓
需要强制转换
↓
为了使用子类特有功能而类型转换能够成立的根本原因,就是对象之间存在:
继承关系
或者接口实现关系这也是 Java 多态能够实现的重要基础。
13.3.8 子父类初始化顺序
在继承关系中创建子类对象时,父类和子类并不是随意初始化的,而是有固定的执行顺序。
整体可以先记成:
父类静态初始化
↓
子类静态初始化
↓
父类实例初始化
↓
父类构造方法
↓
子类实例初始化
↓
子类构造方法更完整地说:
- 父类静态成员变量、静态代码块
- 子类静态成员变量、静态代码块
- 父类实例成员变量、实例初始化块
- 父类构造方法
- 子类实例成员变量、实例初始化块
- 子类构造方法
可以简单记成:
静态初始化优先于实例初始化
父类优先于子类
实例成员初始化优先于当前类构造方法体13.3.8.1 静态初始化
静态成员属于类本身:
static在类初始化阶段执行。
当初始化子类时,会先初始化它的父类,所以顺序是:
父类 static
↓
子类 static而且静态初始化通常只会执行一次。
例如多次:
new Son();
new Son();静态代码块不会因为创建多个对象而重复执行。
13.3.8.2 实例初始化
创建子类对象时,并不是先单独创建一个父类对象,再创建一个子类对象。
实际上最终只有一个子类对象,只不过这个对象中的父类部分需要先完成初始化。
所以:
创建 Son 对象
↓
初始化 Father 部分
↓
执行 Father 构造方法
↓
初始化 Son 自己的部分
↓
执行 Son 构造方法在每一个类内部:
实例成员变量初始化
+
实例初始化块会按照它们在源码中的书写顺序执行,然后才进入当前类构造方法的方法体。
静态成员变量和静态代码块也是如此:
同一个类中,同一初始化阶段的字段初始化和代码块按照源码从上到下执行。
13.3.8.3 测试案例
例如:
class Father {
// 父类静态成员初始化
static int staticValue = print(
"1. 父类静态成员变量"
);
// 父类静态代码块
static {
System.out.println(
"2. 父类静态代码块"
);
}
// 父类实例成员初始化
int value = print(
"5. 父类实例成员变量"
);
// 父类实例初始化块
{
System.out.println(
"6. 父类实例代码块"
);
}
// 父类构造方法
public Father() {
System.out.println(
"7. 父类构造方法"
);
}
protected static int print(
String message) {
System.out.println(message);
return 0;
}
}子类:
class Son extends Father {
// 子类静态成员初始化
static int staticValue2 = print(
"3. 子类静态成员变量"
);
// 子类静态代码块
static {
System.out.println(
"4. 子类静态代码块"
);
}
// 子类实例成员初始化
int value2 = print(
"8. 子类实例成员变量"
);
// 子类实例初始化块
{
System.out.println(
"9. 子类实例代码块"
);
}
// 子类构造方法
public Son() {
System.out.println(
"10. 子类构造方法"
);
}
}测试:
public class Test {
public static void main(String[] args) {
new Son();
}
}执行结果:
1. 父类静态成员变量
2. 父类静态代码块
3. 子类静态成员变量
4. 子类静态代码块
5. 父类实例成员变量
6. 父类实例代码块
7. 父类构造方法
8. 子类实例成员变量
9. 子类实例代码块
10. 子类构造方法执行结果也可以直接画成:
类初始化阶段
│
├── Father
│ ├── static 成员变量
│ └── static 代码块
│
└── Son
├── static 成员变量
└── static 代码块
↓
对象初始化阶段
│
├── Father
│ ├── 实例成员变量
│ ├── 实例初始化块
│ └── 构造方法
│
└── Son
├── 实例成员变量
├── 实例初始化块
└── 构造方法原来的执行结果图也可以保留:
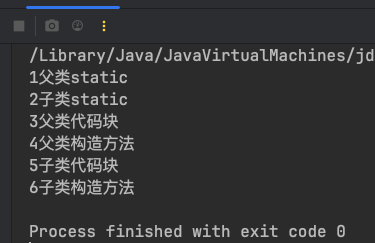
需要特别注意:
静态成员并不是简单地在 JVM “加载 .class 文件”时就一定立即执行,而是在对应类发生初始化时执行。
另外,下面这句话也不要理解错:
父类优先于子类它并不是:
先 new 一个 Father
再 new 一个 Son而是:
同一个 Son 对象
↓
先完成其中的 Father 部分初始化
↓
再完成 Son 自身部分初始化最后可以直接记住这条顺序:
父 static
↓
子 static
↓
父实例成员 / 实例代码块
↓
父构造
↓
子实例成员 / 实例代码块
↓
子构造其中同一类中的:
字段初始化
+
初始化代码块按照源码的书写顺序从上到下执行。
13.4 多态
多态(Polymorphism)是面向对象的三大特征之一。
简单来说,多态表示:
同一个方法调用,因为实际对象不同,可以表现出不同的行为。
例如:
Animal animal = new Dog();
animal.eat();虽然引用类型是:
Animal但如果实际对象是:
Dog并且 Dog 重写了 eat() 方法,那么最终执行的就是:
Dog.eat()因此多态的核心可以理解为:
统一的父类型
↓
指向不同的子类对象
↓
调用同一个方法
↓
运行时执行不同实现多态能够降低代码对具体实现类的依赖,提高程序的:
灵活性
可扩展性
可维护性13.4.1 多态是什么
多态最核心的含义就是:
同一种行为,可以有多种不同的表现形式。
例如可以把孙悟空的七十二变理解成一个比较形象的例子:
同一个“变”的动作
↓
可以变成不同的形态在 Java 中也是类似的。
假设有一个父类:
class LiHong {
public void write() {
System.out.println("勿忘国耻");
}
}子类继承并重写:
class LiXiaoHong extends LiHong {
@Override
public void write() {
System.out.println(
"记住历史,更要奋发图强"
);
}
}测试:
public class Demo {
public static void main(String[] args) {
LiHong[] lihongs = {
new LiHong(),
new LiXiaoHong()
};
for (LiHong lihong : lihongs) {
lihong.write();
}
}
}输出:
勿忘国耻
记住历史,更要奋发图强这里循环中的代码始终只有:
lihong.write();但因为:
第一次实际对象是 LiHong
第二次实际对象是 LiXiaoHong所以最终执行的方法不同。
这就是多态。
对于类的继承来说,多态通常需要三个条件:
存在继承关系
子类重写父类方法
父类引用指向子类对象例如:
LiHong lihong =
new LiXiaoHong();其中:
LiHong
↓
引用类型
LiXiaoHong
↓
实际对象类型然后:
lihong.write();就会执行子类重写后的:
LiXiaoHong.write()除了类继承之外,接口同样可以实现多态:
PayService payService =
new AliPayService();本质仍然是:
面向父类型 / 接口编程
↓
具体实现可以变化13.4.2 多态与动态绑定
来看下面的代码:
LiHong lihong =
new LiXiaoHong();
lihong.write();这里有一个问题:
lihong 的声明类型明明是 LiHong
为什么最终却执行 LiXiaoHong.write()?原因就是 Java 实例方法调用中的:
动态绑定
Dynamic Binding也经常称为:
后期绑定
Late Binding在编译阶段,编译器会根据引用的静态类型:
LiHong检查:
write()这个方法是否可以调用。
到了运行阶段,JVM 再根据引用实际指向的对象:
LiXiaoHong选择最终执行的重写方法。
所以可以简单记成:
编译阶段
↓
看引用类型
↓
这个方法能不能调用?
运行阶段
↓
看实际对象类型
↓
最终执行哪个重写方法?例如:
class LiHong {
public void write() {
System.out.println("LiHong write");
}
public void read() {
System.out.println("每周读一本好书");
}
}class LiXiaoHong extends LiHong {
@Override
public void write() {
System.out.println(
"LiXiaoHong write"
);
}
public void eat() {
System.out.println(
"我喜欢吃东西"
);
}
}调用:
LiHong lihong =
new LiXiaoHong();
lihong.write();
lihong.read();其中:
lihong.write();因为子类重写了,所以执行:
LiXiaoHong.write()而:
lihong.read();子类没有重写,所以继续执行:
LiHong.read()但是下面这样不可以:
// 编译错误
// lihong.eat();虽然实际对象是:
LiXiaoHong但引用类型:
LiHong并没有声明:
eat()所以编译阶段就无法通过。
这也是多态非常重要的一条规则:
能调用什么
↓
看引用类型
真正执行什么
↓
看实际对象多态带来的好处是,调用者可以只依赖父类或者接口,而不用关心具体实现。
例如:
public void write(LiHong lihong) {
lihong.write();
}以后传入:
LiHong
LiXiaoHong
LiXiaoMing只要它们都符合 LiHong 类型关系,调用代码就不需要改变。
因此多态能够把:
稳定的调用方式和:
不断变化的具体实现分离开来。
13.4.3 多态与构造方法
在构造方法中调用可以被子类重写的方法,是一个比较特殊的情况。
例如:
class LiMing {
public LiMing() {
System.out.println(
"上幼儿园之前"
);
write();
System.out.println(
"上幼儿园之后"
);
}
public void write() {
System.out.println(
"李明上幼儿园"
);
}
}子类:
public class LiXiaoMing
extends LiMing {
private int age = 3;
public LiXiaoMing(int age) {
this.age = age;
System.out.println(
"李小明的年龄:" + this.age
);
}
@Override
public void write() {
System.out.println(
"我小明上幼儿园的年龄是:"
+ this.age
);
}
public static void main(
String[] args) {
new LiXiaoMing(4);
}
}输出类似:
上幼儿园之前
我小明上幼儿园的年龄是:0
上幼儿园之后
李小明的年龄:4为什么这里输出的是:
0而不是:
3或者:
4关键就在对象初始化顺序。
创建:
new LiXiaoMing(4);时,大致过程是:
为 LiXiaoMing 对象分配内存
↓
字段先获得默认值
↓
age = 0
↓
执行父类 LiMing 构造方法
↓
父类构造方法调用 write()
↓
由于动态绑定
↓
实际执行 LiXiaoMing.write()
↓
此时子类 age = 3
还没有执行
↓
所以看到 age = 0
↓
父类构造完成
↓
执行子类字段初始化
age = 3
↓
执行 LiXiaoMing 构造方法
↓
this.age = 4所以真正的问题是:
父类构造方法调用了一个可以被子类重写的方法,而此时子类自己的初始化还没有完成。
虽然:
write()是在父类构造方法中调用的,但动态绑定仍然会让它执行:
LiXiaoMing.write()而这时:
age还只是 JVM 提供的默认值:
0因此实际开发中有一条很重要的经验:
尽量不要在构造方法中调用可能被子类重写的方法。
否则子类方法可能访问到一个:
尚未完成初始化的对象状态从而产生难以理解的问题。
13.4.4 多态与向下转型
多态通常会出现:
LiLiang liang =
new LiXiaoLiang();这属于向上转型:
LiXiaoLiang
↓
LiLiang如果之后想调用子类中特有的方法:
eat()就需要向下转型。
例如:
class LiLiang {
public void write() {
System.out.println("勿忘国耻");
}
public void read() {
System.out.println(
"每周读一本好书"
);
}
}子类:
class LiXiaoLiang
extends LiLiang {
@Override
public void write() {
System.out.println(
"记住历史,更要奋发图强"
);
}
public void eat() {
System.out.println(
"我喜欢吃东西"
);
}
}测试:
public class Demo {
public static void main(String[] args) {
LiLiang[] liliangs = {
new LiLiang(),
new LiXiaoLiang()
};
// 实际对象是 LiXiaoLiang
LiXiaoLiang xiaoLiang =
(LiXiaoLiang) liliangs[1];
xiaoLiang.eat();
}
}这里:
liliangs[1]虽然引用类型是:
LiLiang但实际对象是:
LiXiaoLiang所以可以成功向下转型。
但是:
LiXiaoLiang xiaoLiang =
(LiXiaoLiang) liliangs[0];虽然编译可以通过,但运行时会抛出:
ClassCastException因为:
liliangs[0]
↓
实际对象就是 LiLiang它本来就不是:
LiXiaoLiang所以不能强行转换。
执行失败时类似:
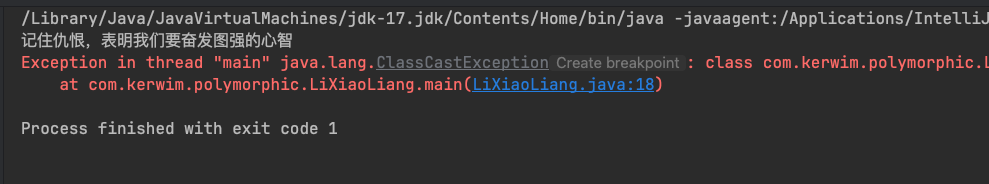
因此向下转型前,通常应该先判断类型:
if (liliangs[1]
instanceof LiXiaoLiang) {
LiXiaoLiang xiaoLiang =
(LiXiaoLiang) liliangs[1];
xiaoLiang.eat();
}较新的 Java 中还可以直接使用模式匹配:
if (liliangs[1]
instanceof LiXiaoLiang xiaoLiang) {
xiaoLiang.eat();
}可以同时完成:
类型判断
+
类型转换
+
变量声明所以多态和类型转换之间的关系可以总结为:
向上转型
↓
父类型引用指向子类对象
↓
实现多态
向下转型
↓
恢复具体子类类型
↓
使用子类特有成员最后可以简单理解多态:
父类 / 接口
↓
统一定义行为
↓
不同子类 / 实现类
↓
分别重写行为
↓
父类型引用指向不同对象
↓
运行时执行不同实现一句话概括:
多态就是用统一的父类型或接口操作不同的具体对象,并在运行时根据实际对象执行对应的方法实现。
13.5 小结
Java 面向对象的三大特征分别是:
封装
继承
多态它们关注的问题不同,但又彼此关联。
- 封装:隐藏对象内部实现,只对外提供必要的操作入口。实际开发中常通过
private限制成员访问,再通过方法控制对象状态,但封装并不等于简单地生成 Getter 和 Setter。 - 继承:子类在父类的基础上继续扩展,可以复用父类已有的属性和方法,也可以增加自己的成员或者重写父类行为。继承表达的通常是一种
is-a关系,同时也是实现多态的重要基础。 - 多态:同一个父类型或者接口引用,可以指向不同的具体对象;调用同一个被重写的方法时,根据实际对象类型执行不同的实现。
三者之间可以简单理解为:
封装
↓
把对象内部实现隐藏起来
继承
↓
建立类之间的层次关系
并复用、扩展已有能力
多态
↓
基于继承或接口
让同一种调用产生不同的行为例如:
Animal animal = new Dog();
animal.eat();这里:
Animal
↓
定义公共行为
Dog extends Animal
↓
通过继承获得并重写行为
Animal animal = new Dog()
↓
父类引用指向子类对象
animal.eat()
↓
运行时执行 Dog 的实现
↓
多态所以可以用一句话记住:
封装负责隐藏细节,继承负责建立关系和扩展能力,多态负责统一调用、不同实现。
最后通过这张图再整体梳理一下三者之间的关系:
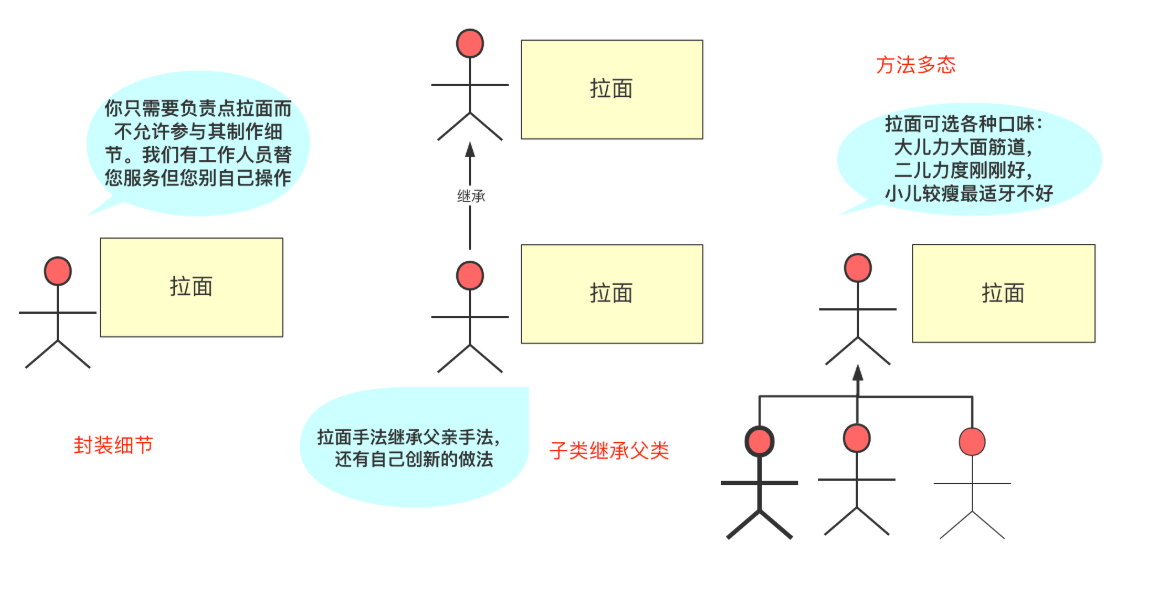
14. Java this 与 super 关键字
this 和 super 都是 Java 中非常常见的关键字,在构造方法、继承、方法调用中经常使用。
可以先简单理解为:
this
↓
当前对象 / 当前类
super
↓
当前对象中的父类部分两者虽然写法相似,但作用不同。
14.1 this 关键字
this 表示当前对象的引用。
常见用法主要有:
1. 访问当前对象的成员变量
2. 调用当前对象的方法
3. this(...) 调用本类其他构造方法
4. 作为方法参数传递
5. 作为构造方法参数传递
6. 作为方法返回值14.1.1 指向当前对象
this 最常见的作用,就是区分:
成员变量
和
局部变量 / 方法参数例如:
public class WithoutThisStudent {
String name;
int age;
public WithoutThisStudent(
String name,
int age) {
name = name;
age = age;
}
public void out() {
System.out.println(
name + " " + age
);
}
public static void main(
String[] args) {
WithoutThisStudent s1 =
new WithoutThisStudent(
"kerwim",
18
);
WithoutThisStudent s2 =
new WithoutThisStudent(
"kevin",
16
);
s1.out();
s2.out();
}
}输出:
null 0
null 0为什么?
因为在构造方法中:
name = name;
age = age;左右两边实际上都优先指向方法参数。
可以理解为:
参数 name
↓
自己赋值给自己
参数 age
↓
自己赋值给自己真正的成员变量:
this.name
this.age根本没有被赋值,因此仍然保持默认值:
String → null
int → 0这时候就需要使用:
this明确表示当前对象的成员变量:
public class Student {
String name;
int age;
public Student(
String name,
int age) {
// 当前对象的 name
this.name = name;
// 当前对象的 age
this.age = age;
}
public void out() {
System.out.println(
name + " " + age
);
}
public static void main(
String[] args) {
Student s1 =
new Student(
"kerwim",
18
);
Student s2 =
new Student(
"kevin",
16
);
s1.out();
s2.out();
}
}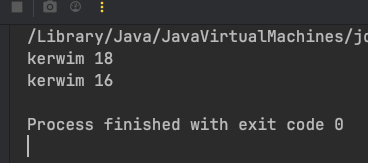
输出:
kerwim 18
kevin 16这里:
this.name = name;可以理解为:
this.name
↓
当前对象的成员变量
name
↓
构造方法参数所以 this 最常见的一种用途就是:
当成员变量和局部变量重名时,使用
this明确访问当前对象的成员变量。
14.1.2 调用当前类的方法
this 也可以调用当前对象中的其他实例方法。
例如:
public class InvokeCurrentClassMethod {
public void method1() {
System.out.println(
"method1"
);
}
public void method2() {
this.method1();
}
public static void main(
String[] args) {
InvokeCurrentClassMethod demo =
new InvokeCurrentClassMethod();
demo.method2();
}
}实际上在实例方法内部:
method1();和:
this.method1();通常表示的是同一件事情。
所以也可以写:
public void method2() {
method1();
}Java 会把这种没有显式对象的实例方法调用理解为:
在当前对象上调用 method1()也就是:
this.method1();有些反编译工具可能会把省略的:
this.重新显示出来:
不过需要注意:
反编译出来的 Java 代码只是反编译器根据字节码重新生成的近似源码,并不代表编译器真的在原始源码中“插入了一段
this.文本”。
核心理解是:
实例方法
↓
本来就是在某个对象上执行
↓
this 表示当前正在执行方法的这个对象14.1.3 调用当前类的构造方法
在构造方法中,可以使用:
this(...)调用当前类的另外一个构造方法。
例如:
public class InvokeConstructor {
public InvokeConstructor() {
System.out.println("hello");
}
public InvokeConstructor(
int count) {
// 调用本类无参构造方法
this();
System.out.println(count);
}
public static void main(
String[] args) {
new InvokeConstructor(10);
}
}输出:
hello
10这里:
this();调用的是:
InvokeConstructor()无参构造方法。
同样,也可以让无参构造方法调用有参构造方法:
public class InvokeParamConstructor {
public InvokeParamConstructor() {
// 调用本类有参构造方法
this(10);
System.out.println("hello");
}
public InvokeParamConstructor(
int count) {
System.out.println(count);
}
public static void main(
String[] args) {
new InvokeParamConstructor();
}
}输出:
10
hello这种方式可以减少多个构造方法之间的重复代码。
例如:
public class Person {
private String name;
private int age;
public Person() {
this("kerwim", 18);
}
public Person(String name) {
this(name, 18);
}
public Person(
String name,
int age) {
this.name = name;
this.age = age;
}
}这里最终把真正的初始化逻辑集中到了:
Person(String name, int age)中。
需要注意:
this(...)必须是构造方法中的第一条语句。
例如下面这样不允许:
public Person() {
// 编译错误
// System.out.println("hello");
// this("kerwim", 18);
}而且:
this(...)只能出现在:
构造方法中。
不能在普通方法里使用:
this();14.1.4 作为参数在方法中传递
因为 this 表示当前对象,所以它可以像普通对象引用一样作为参数传递。
例如:
public class ThisAsParam {
public void method1(
ThisAsParam param) {
System.out.println(param);
}
public void method2() {
// 把当前对象传给 method1()
method1(this);
}
public static void main(
String[] args) {
ThisAsParam demo =
new ThisAsParam();
System.out.println(demo);
demo.method2();
}
}输出类似:
ThisAsParam@36baf30c
ThisAsParam@36baf30c两个结果相同,说明:
demo
和
method1(this) 中的 this指向的是同一个对象。
可以理解为:
demo
│
↓
当前对象
↑
│
this14.1.5 作为参数在构造方法中传递
this 同样可以作为参数传递给其他类的构造方法。
例如:
public class ThisAsConstructorParam {
int count = 10;
public ThisAsConstructorParam() {
// 把当前对象传给 Data
Data data =
new Data(this);
data.out();
}
public static void main(
String[] args) {
new ThisAsConstructorParam();
}
}Data:
class Data {
private ThisAsConstructorParam param;
public Data(
ThisAsConstructorParam param) {
this.param = param;
}
public void out() {
System.out.println(
param.count
);
}
}输出:
10这里:
new Data(this);实际上就是把当前的:
ThisAsConstructorParam 对象传给了 Data。
因此:
ThisAsConstructorParam 对象
↓
this
↓
传递给 Data 构造方法
↓
Data 保存这个对象的引用这种方式在:
对象之间建立关联
监听器
回调
组件之间协作等场景中都会遇到。
不过需要注意:
在构造方法中把
this暴露给外部对象要谨慎。
因为当前对象可能还没有完成初始化,如果另外一个对象立即调用它的方法,就可能访问到尚未初始化完成的状态。
14.1.6 作为方法的返回值
this 还可以直接作为方法返回值。
例如:
public class ThisAsMethodResult {
public ThisAsMethodResult
getThisAsMethodResult() {
return this;
}
public void out() {
System.out.println("hello");
}
public static void main(
String[] args) {
new ThisAsMethodResult()
.getThisAsMethodResult()
.out();
}
}输出:
hello这里:
return this;返回的就是当前对象本身。
因此:
getThisAsMethodResult()执行结束后,仍然可以继续:
.out()这也是实现链式调用的一种常见方式。
例如:
public class User {
private String name;
private int age;
public User setName(
String name) {
this.name = name;
return this;
}
public User setAge(
int age) {
this.age = age;
return this;
}
}调用:
User user =
new User()
.setName("kerwim")
.setAge(18);整个过程:
setName()
↓
return this
↓
仍然返回当前 User
↓
继续调用 setAge()这就是常见的:
链式调用
Fluent API14.2 super 关键字
super 主要用于继承关系中。
它常见的用途有:
访问父类成员变量
调用父类方法
super(...) 调用父类构造方法需要注意:
super不应该简单理解为“指向另一个父类对象”。
创建子类对象时,并不会额外创建一个完全独立的父类对象。
例如:
new Dog();最终创建的仍然是一个:
Dog 对象只是这个对象中包含从父类继承而来的部分。
因此可以简单理解为:
this
↓
当前对象
super
↓
从父类角度访问当前对象中的父类部分14.2.1 访问父类成员变量
如果父类和子类中出现同名字段,可以使用:
super.字段名访问父类中的字段。
例如:
public class ReferParentField {
public static void main(
String[] args) {
new Dog().printColor();
}
}父类:
class Animal {
String color = "白色";
}子类:
class Dog extends Animal {
String color = "黑色";
public void printColor() {
// 当前类中的 color
System.out.println(
this.color
);
// 父类中的 color
System.out.println(
super.color
);
}
}输出:
黑色
白色这里:
this.color表示:
Dog.color而:
super.color表示:
Animal.color所以:
this.xxx
↓
当前类中的成员
super.xxx
↓
父类中的成员14.2.2 调用父类方法
如果子类重写了父类方法,但又希望在子类方法中继续使用父类原来的实现,可以使用:
super.方法名()例如:
public class ReferParentMethod {
public static void main(
String[] args) {
new Dog2().work();
}
}父类:
class Animal2 {
public void eat() {
System.out.println(
"动物正在吃东西..."
);
}
}子类:
class Dog2 extends Animal2 {
@Override
public void eat() {
System.out.println(
"狗狗正在吃狗粮..."
);
}
public void bark() {
System.out.println(
"汪汪汪..."
);
}
public void work() {
// 明确调用父类版本
super.eat();
bark();
}
}调用:
new Dog2().work();输出:
动物正在吃东西...
汪汪汪...如果直接:
eat();或者:
this.eat();执行的是当前对象经过动态绑定后的:
Dog2.eat()而:
super.eat();明确表示:
跳过当前类的重写实现,调用父类版本的方法。
因此 super 在方法重写中非常常见。
14.2.3 调用父类构造方法
在子类构造方法中,可以通过:
super(...)调用父类构造方法。
例如:
public class ReferParentConstructor {
public static void main(
String[] args) {
new Dog3();
}
}父类:
class Animal3 {
public Animal3() {
System.out.println(
"动物来了"
);
}
}子类:
class Dog3 extends Animal3 {
public Dog3() {
// 调用父类无参构造方法
super();
System.out.println(
"狗狗来了"
);
}
}输出:
动物来了
狗狗来了这里执行:
new Dog3();初始化过程是:
Dog3 对象开始初始化
↓
先执行 Animal3 构造方法
↓
再执行 Dog3 构造方法如果子类构造方法没有显式写:
super(...)也没有写:
this(...)编译器会默认调用:
super();因此:
class Dog3 extends Animal3 {
public Dog3() {
System.out.println(
"狗狗来了"
);
}
}可以理解为:
class Dog3 extends Animal3 {
public Dog3() {
// 编译器隐式调用
super();
System.out.println(
"狗狗来了"
);
}
}所以输出仍然是:
动物来了
狗狗来了不过这里有一个重要前提:
父类必须存在可以访问的无参构造方法。
例如父类只有有参构造:
class Person {
int id;
String name;
public Person(
int id,
String name) {
this.id = id;
this.name = name;
}
}那么子类必须显式调用:
super(id, name);例如:
class Emp extends Person {
float salary;
public Emp(
int id,
String name,
float salary) {
// 调用父类有参构造方法
super(id, name);
this.salary = salary;
}
public void display() {
System.out.println(
id + " "
+ name + " "
+ salary
);
}
}测试:
public class CallParentParamConstructor {
public static void main(
String[] args) {
new Emp(
1,
"kerwim",
20000F
).display();
}
}输出:
1 kerwim 20000.0这里:
super(id, name);负责初始化父类中的:
id
name而:
this.salary = salary;负责初始化子类自己的:
salary整个过程可以理解为:
new Emp(...)
↓
super(id, name)
↓
初始化 Person 部分
↓
初始化 Emp 自己的 salary
↓
Emp 对象完成初始化和 this(...) 一样:
super(...)也必须是构造方法的第一条语句。
14.3 this 和 super 的区别
this 和 super 在语法上比较相似:
this.xxx
super.xxx
this(...)
super(...)但两者表达的含义不同。
可以直接对比:
| 对比项 | this | super |
|---|---|---|
| 含义 | 当前对象 | 从父类角度访问当前对象中的父类部分 |
| 访问成员变量 | this.name | super.name |
| 调用方法 | this.test() | super.test() |
| 调用构造方法 | this(...) | super(...) |
| 构造方法调用对象 | 当前类其他构造方法 | 父类构造方法 |
| 普通对象引用一样传参 | 可以 | 不可以 |
可以 return | 可以 return this | 不能 return super |
| static 方法中使用 | 不可以 | 不可以 |
例如:
class Animal {
String name = "Animal";
public Animal() {
System.out.println(
"Animal constructor"
);
}
public void eat() {
System.out.println(
"Animal eat"
);
}
}子类:
class Dog extends Animal {
String name = "Dog";
public Dog() {
// 调用父类构造方法
super();
}
public void print() {
// 当前对象中的字段
System.out.println(
this.name
);
// 父类中的字段
System.out.println(
super.name
);
// 当前对象的方法
this.eat();
// 父类版本的方法
super.eat();
}
@Override
public void eat() {
System.out.println(
"Dog eat"
);
}
}执行:
Dog dog = new Dog();
dog.print();输出:
Animal constructor
Dog
Animal
Dog eat
Animal eat关系可以简单表示为:
Dog 对象
│
┌────────┴────────┐
↓ ↓
this super
│ │
当前对象整体 父类部分的访问入口
│ │
this.name super.name
this.eat() super.eat()另外,构造方法中有一条非常重要的规则:
this(...)和:
super(...)都必须出现在构造方法第一条语句的位置。
因此不能这样写:
public Dog() {
// 编译错误
// this(...);
// 编译错误
// super(...);
}也就是说:
一个构造方法不能同时直接调用
this(...)和super(...)。
但是通过构造方法之间的调用,最终仍然一定会调用到父类构造方法。
例如:
class Dog extends Animal {
public Dog() {
this("旺财");
}
public Dog(String name) {
super();
System.out.println(name);
}
}调用关系是:
Dog()
↓
this("旺财")
↓
Dog(String)
↓
super()
↓
Animal()因此可以把 this 和 super 最后简单记成:
this
↓
当前对象
↓
this.成员
this.方法()
this(...)
super
↓
父类部分
↓
super.成员
super.方法()
super(...)一句话概括:
this关注“我自己”,super关注“我的父类部分”。
15. Java static 关键字
static 是 Java 中非常重要的关键字,可以修饰:
成员变量
成员方法
代码块
内部类static 最核心的含义可以理解为:
被
static修饰的成员属于类本身,而不是属于某一个具体对象。
例如:
class Student {
static String school = "玉林师范学院";
}这里的:
school属于 Student 类,所有 Student 对象共享同一份数据。
因此通常推荐通过:
Student.school访问,而不是:
student.school可以先简单理解:
普通成员
↓
属于对象
↓
每个对象都有自己的状态
static 成员
↓
属于类
↓
所有对象共享15.1 静态变量
使用 static 修饰的成员变量称为:
静态变量
或者
类变量例如:
public class Student {
String name;
int age;
static String school =
"玉林师范学院";
}其中:
name
age属于每个 Student 对象。
而:
school属于整个:
Student 类如果创建多个学生:
Student s1 =
new Student();
Student s2 =
new Student();可以理解为:
s1
├── name
└── age
s2
├── name
└── age
Student 类
└── school所以:
name / age
↓
每个对象可以不同
school
↓
所有 Student 对象共享静态变量适合保存共享数据
假设学校中的所有学生都属于同一所学校:
public class Student {
String name;
int age;
static String school =
"玉林师范学院";
public Student(
String name,
int age) {
this.name = name;
this.age = age;
}
}创建对象:
Student s1 =
new Student(
"kerwim",
18
);
Student s2 =
new Student(
"kevin",
16
);这两个对象都有自己独立的:
name
age但共同使用:
Student.school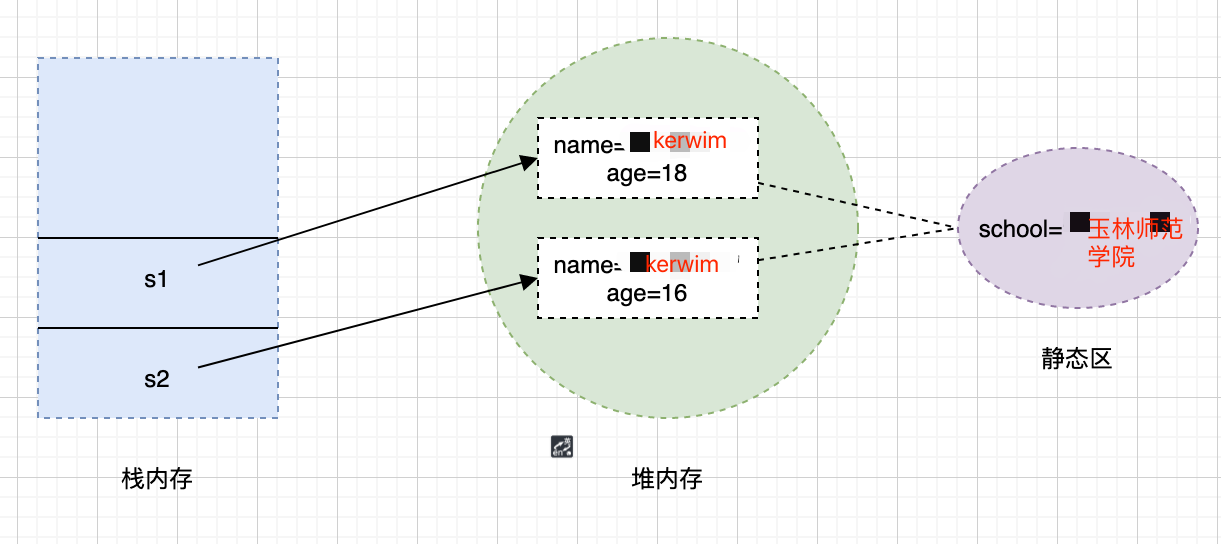
不过需要注意:
不建议简单记成“对象一定在堆、引用一定在栈、static 一定在某个静态区”。
这些属于 JVM 具体实现和运行时优化问题。
对于学习 static 来说,最重要的是理解:
实例变量
↓
跟着对象走
静态变量
↓
跟着类走静态变量被所有对象共享
来看一个普通成员变量:
public class Counter {
int count = 0;
public Counter() {
count++;
System.out.println(count);
}
public static void main(
String[] args) {
new Counter();
new Counter();
new Counter();
}
}输出:
1
1
1因为每创建一个:
Counter对象,都会拥有自己的:
count所以每个对象都是:
0 → 1如果修改为静态变量:
public class StaticCounter {
static int count = 0;
public StaticCounter() {
count++;
System.out.println(count);
}
public static void main(
String[] args) {
new StaticCounter();
new StaticCounter();
new StaticCounter();
}
}输出:
1
2
3因为:
count属于:
StaticCounter 类所有对象修改的是同一个变量。
可以理解为:
StaticCounter.count
│
┌───────┼───────┐
↓ ↓ ↓
对象1 对象2 对象3
│ │ │
└────共享同一个 count────┘所以静态变量特别适合表示:
全类共享的数据
对象数量计数器
公共配置
常量访问静态变量时,推荐:
Student.school而不是:
Student student =
new Student();
student.school;后者语法上虽然允许,但容易让人误以为 school 属于某个对象。
15.2 静态方法
使用:
static修饰的方法称为静态方法。
例如:
public static void change() {
}静态方法属于类本身,因此可以直接:
类名.方法名()调用。
例如:
public class StaticMethodStudent {
String name;
int age;
static String school =
"玉林师范学院";
public StaticMethodStudent(
String name,
int age) {
this.name = name;
this.age = age;
}
public static void change() {
school = "广西大学";
}
public void out() {
System.out.println(
name + " "
+ age + " "
+ school
);
}
public static void main(
String[] args) {
// 通过类名调用静态方法
StaticMethodStudent.change();
StaticMethodStudent s1 =
new StaticMethodStudent(
"kerwim",
18
);
StaticMethodStudent s2 =
new StaticMethodStudent(
"kevin",
16
);
s1.out();
s2.out();
}
}输出:
kerwim 18 广西大学
kevin 16 广西大学因为:
change()修改的是所有对象共享的:
school静态方法不能直接访问实例成员
静态方法属于类,并不依赖某一个具体对象。
所以在静态方法中,没有:
this这个当前对象。
因此不能直接访问实例变量:
public class Demo {
private int age = 18;
public static void test() {
// 编译错误
// System.out.println(age);
}
}IDE 会提示:
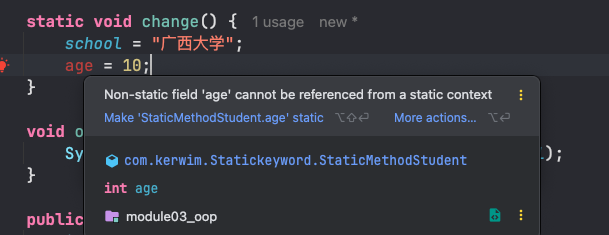
同样,也不能直接调用实例方法:
public class Demo {
public void sayHello() {
}
public static void test() {
// 编译错误
// sayHello();
}
}IDE 会提示:
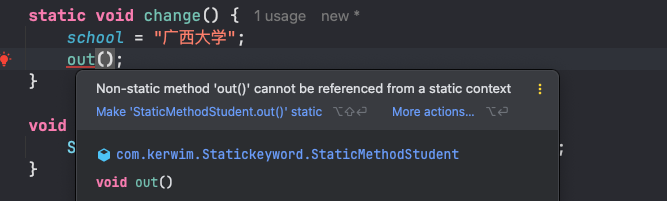
原因可以简单理解为:
static 方法
↓
没有具体对象
↓
没有 this
↓
不知道应该访问哪个对象的实例成员但是如果主动创建或者获得一个对象,就可以正常访问:
public static void test() {
Demo demo =
new Demo();
System.out.println(
demo.age
);
demo.sayHello();
}所以准确来说不是:
静态方法绝对不能访问实例成员而是:
静态方法不能在没有对象引用的情况下直接访问实例成员。
为什么 main() 是 static?
Java 程序常见入口是:
public static void main(
String[] args) {
}JVM 启动程序时,需要找到这个入口方法。
因为:
main()是静态方法,所以不需要提前创建当前类的对象,就可以调用它。
可以理解为:
JVM 启动程序
↓
找到 main()
↓
直接通过类调用
↓
开始执行程序如果 main() 是普通实例方法,就还需要先确定:
应该创建哪个对象?
应该调用哪个构造方法?因此把程序入口设计为静态方法更加直接。
工具类中的 static
很多工具类都大量使用静态方法。
例如:
Math.max(10, 20);
Math.abs(-10);
Arrays.sort(array);
Collections.sort(list);它们通常表达的是:
给我参数
↓
我完成一个操作
↓
不需要保存某个对象自己的状态所以非常适合使用:
static例如 Math 中很多常用方法都可以直接通过类名调用:
15.3 静态代码块
使用:
static {
}定义的代码块称为:
静态初始化块
Static Initializer例如:
public class StaticBlock {
static {
System.out.println(
"静态代码块"
);
}
public static void main(
String[] args) {
System.out.println(
"main 方法"
);
}
}输出:
静态代码块
main 方法原因是:
执行 main()
↓
需要初始化 StaticBlock 类
↓
先执行静态初始化
↓
再进入 main()所以不能简单理解成:
static 代码块永远比 main() 早更准确的说法是:
当这个类发生初始化时,会先执行它的静态字段初始化和静态代码块,然后才执行该类的
main()方法。
多个静态成员的执行顺序
同一个类中的:
静态字段初始化
静态代码块按照源码从上到下执行。
例如:
public class StaticBlockDemo {
public static List<String> writes =
new ArrayList<>();
static {
writes.add("kerwim1");
writes.add("kerwim2");
writes.add("kerwim3");
System.out.println(
"第一块"
);
}
static {
writes.add("kerwim4");
writes.add("kerwim5");
System.out.println(
"第二块"
);
}
}执行顺序就是:
创建 writes
↓
第一个 static 块
↓
第二个 static 块输出:
第一块
第二块静态代码块比较适合进行一些:
较复杂的静态初始化
静态数据准备例如:
public class Config {
public static final Map<String, String>
CONFIG =
new HashMap<>();
static {
CONFIG.put(
"name",
"kerwim"
);
CONFIG.put(
"language",
"Java"
);
}
}不过如果数据本身非常简单,也没有必要为了使用 static 而专门写静态代码块。
例如:
public static final List<String> NAMES =
List.of(
"kerwim",
"kevin"
);直接初始化通常更加简单。
没有 main() 能不能运行?
普通 Java 类当然可以没有:
main()大量业务类本身都没有 main()。
但是如果直接执行:
java StaticBlockNoMain传统的 Java 类启动方式要求找到:
public static void main(String[] args)如果没有符合要求的入口方法,启动器会提示找不到主方法。
所以:
public class StaticBlockNoMain {
static {
System.out.println(
"静态代码块"
);
}
}本身是合法 Java 类,只是不能按照普通 Java 应用入口的方式直接启动。
15.4 静态内部类
static 还可以用于修饰嵌套类。
例如:
public class Outer {
static class Inner {
}
}这种结构更准确的名称是:
静态嵌套类
Static Nested Class平时也经常称为:
静态内部类这部分前面:
12.4 静态内部类已经详细讲过,这里重点看它和 static 的关系。
静态内部类:
不依赖外部类对象因此可以直接:
Outer.Inner inner =
new Outer.Inner();不需要:
Outer outer =
new Outer();静态内部类访问外部成员
例如:
public class Outer {
private int age = 18;
private static String name =
"kerwim";
static class Inner {
public void print() {
// 可以访问外部类静态成员
System.out.println(name);
// 不能直接访问外部类实例成员
// System.out.println(age);
}
}
}即使:
name是:
private static静态内部类仍然可以访问。
因此:
静态内部类
↓
可以访问外部类 static 成员
↓
包括 private static 成员
静态内部类
↓
不能直接访问外部类实例成员如果确实需要访问实例成员,就必须先有外部类对象:
Outer outer =
new Outer();
System.out.println(
outer.age
);15.5 静态内部类与单例模式
静态内部类还有一个比较经典的应用:
单例模式例如:
public class Singleton {
/**
* 禁止外部直接创建对象
*/
private Singleton() {
}
/**
* 静态内部类
*/
private static class SingletonHolder {
private static final Singleton INSTANCE =
new Singleton();
}
public static Singleton getInstance() {
return SingletonHolder.INSTANCE;
}
}调用:
Singleton singleton =
Singleton.getInstance();这种写法通常称为:
静态内部类单例
或者
Initialization-on-demand holder idiom它有一个特点:
第一次初始化:
Singleton时,并不会因为这个原因就立刻初始化:
SingletonHolder当第一次调用:
Singleton.getInstance()并真正使用:
SingletonHolder.INSTANCE时,才会触发:
SingletonHolder的初始化。
过程可以理解为:
第一次使用 Singleton
↓
Singleton 初始化
↓
SingletonHolder 暂时不初始化
第一次调用 getInstance()
↓
使用 SingletonHolder.INSTANCE
↓
初始化 SingletonHolder
↓
创建 Singleton.INSTANCEJava 的类初始化机制能够保证这一初始化过程具有线程安全性,因此这种写法同时具有:
延迟初始化
线程安全
实现简单等特点。
当然,单例模式还有其他实现方式,例如使用:
enum实现单例。
这些可以等学习设计模式的时候再详细展开。
15.6 static 的限制
static 方法中不能使用 this 和 super
因为:
this
↓
当前对象
super
↓
基于当前对象访问父类部分而静态方法属于类本身,不依赖任何具体对象。
所以:
public static void test() {
// 编译错误
// System.out.println(this);
// 编译错误
// super.toString();
}构造方法不能使用 static
下面这种写法是不允许的:
public class Person {
// 编译错误
// public static Person() {
// }
}因为构造方法用于:
初始化对象而 static 表示:
属于类本身两者语义冲突。
顶层类不能使用 static
例如:
// 编译错误
// static class Person {
// }顶层类不能使用:
static修饰。
但是嵌套在其他类中的类可以:
public class Outer {
static class Inner {
}
}
15.7 static 与继承
静态成员也可以通过继承关系被子类访问。
例如:
class Parent {
public static void test() {
System.out.println(
"Parent"
);
}
}class Child extends Parent {
}可以:
Child.test();但是对于静态方法,需要特别注意:
静态方法不能像实例方法一样发生真正的重写。
例如:
class Parent {
public static void test() {
System.out.println(
"Parent"
);
}
}class Child extends Parent {
public static void test() {
System.out.println(
"Child"
);
}
}这种关系叫:
方法隐藏
Method Hiding而不是:
方法重写
Override例如:
Parent parent =
new Child();
parent.test();调用的是:
Parent.test()而不像实例方法那样根据实际对象进行动态绑定。
所以可以简单区分:
实例方法
↓
支持 Override
↓
运行时多态
static 方法
↓
Method Hiding
↓
不参与实例方法的动态绑定15.8 小结
static 的核心不是单纯的:
不用 new 就能调用而是:
static修饰的成员属于类本身,而不是属于某一个具体对象。
可以简单总结:
| 用法 | 含义 |
|---|---|
static 变量 | 类级别共享变量 |
static 方法 | 类级别方法,不依赖具体对象 |
static 代码块 | 类初始化时执行 |
static 内部类 | 不依赖外部类实例的嵌套类 |
最后可以简单记成:
普通成员
↓
对象级别
↓
需要具体对象
static 成员
↓
类级别
↓
所有对象共享最重要的几个规则:
static 方法不能直接访问实例成员
static 方法没有 this 和 super
static 变量被所有对象共享
static 方法推荐通过类名调用
static 方法不能真正重写,只能隐藏
静态内部类不依赖外部类对象一句话概括:
实例成员描述“这个对象有什么”,static 成员描述“这个类共同有什么”。
16. Java final 关键字
final 是 Java 中非常常见的关键字,可以修饰:
变量
方法
类虽然使用位置不同,但核心思想比较接近:
一旦确定下来,就不允许再发生对应层面的改变。
可以先简单理解为:
final 变量
↓
不能再次赋值
final 方法
↓
不能被子类重写
final 类
↓
不能被继承16.1 final 变量
使用 final 修饰变量后,这个变量只能被赋值一次。
例如:
final int age = 18;此时再执行:
age = 30;就会编译报错。
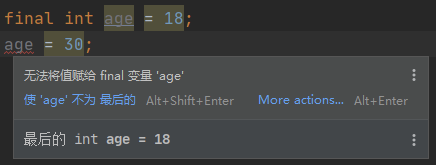
所以:
普通变量
↓
可以重复赋值
final 变量
↓
只能完成一次赋值final 基本数据类型
对于基本数据类型:
final int age = 18;一旦赋值:
age = 18就不能再修改成其他值。
例如:
final int age = 18;
// 编译错误
// age = 30;final 引用类型
如果 final 修饰的是引用变量,需要特别注意:
不能改变的是引用本身,而不是引用指向对象中的所有内容。
例如:
final Pig pig =
new Pig();这时候不能让:
pig重新指向另外一个对象:
// 编译错误
// pig = new Pig();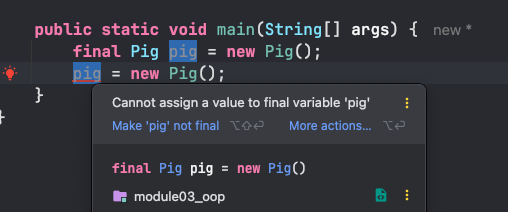
但是如果 Pig 对象本身是可变的,那么仍然可以修改对象内部的状态:
final Pig pig =
new Pig();
pig.setName("一蜘蛛");
System.out.println(
pig.getName()
);这里没有修改:
pig 这个引用只是修改了:
pig 指向对象内部的 name可以理解为:
final Pig pig
│
│ 不能改变指向
↓
┌─────────┐
│ Pig对象 │
│ │
│ name │ ← 如果对象允许,仍然可以修改
└─────────┘所以:
final List<String> list =
new ArrayList<>();仍然可以:
list.add("Java");但是不能:
// 编译错误
// list = new ArrayList<>();因此:
final 引用 ≠ 不可变对象。
final 成员变量
final 成员变量必须在对象初始化完成之前获得确定的值。
可以在声明时直接赋值:
public class Person {
private final int age = 18;
}也可以在构造方法中赋值:
public class Person {
private final String name;
public Person(String name) {
this.name = name;
}
}这种只声明、没有任何地方赋值的写法是不允许的:
public class Person {
// 编译错误
// private final String name;
}因为对象构造完成后:
name仍然没有完成初始化。
static final 常量
final 经常和:
static一起使用。
例如:
public static final double PRICE =
36.5;这种变量通常作为:
类常量使用。
Java 中常量名称通常采用:
全部大写
多个单词使用下划线分隔例如:
public static final int MAX_SIZE =
100;
public static final String DEFAULT_NAME =
"kerwim";需要注意:
全大写是 Java 常见命名规范,而不是编译器强制要求。
所以下面语法也能通过:
public static final int maxSize =
100;只是通常不推荐这么命名常量。
final 方法参数
final 也可以修饰方法参数:
public class ArgFinalTest {
public void arg(
final int age) {
}
public void arg1(
final String name) {
}
}表示:
进入方法之后,不能重新给这个参数赋值。
例如:
public void test(
final int age) {
// 编译错误
// age = 20;
}IDE 会直接提示错误:
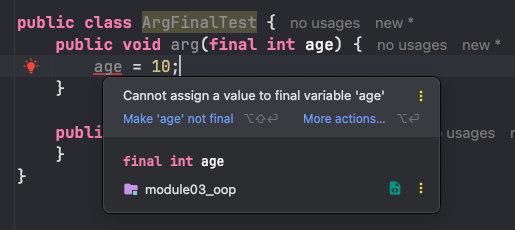
如果参数是引用类型:
public void test(
final List<String> list) {
// 可以修改对象内部状态
list.add("Java");
// 不能改变引用
// list = new ArrayList<>();
}规则仍然和普通 final 引用一样。
16.2 final 方法
使用:
final修饰的方法不能被子类重写。
例如:
public class Actor {
public final void show() {
System.out.println(
"show"
);
}
}如果子类尝试:
public class ChildActor
extends Actor {
// 编译错误
// @Override
// public void show() {
// }
}就会编译失败。
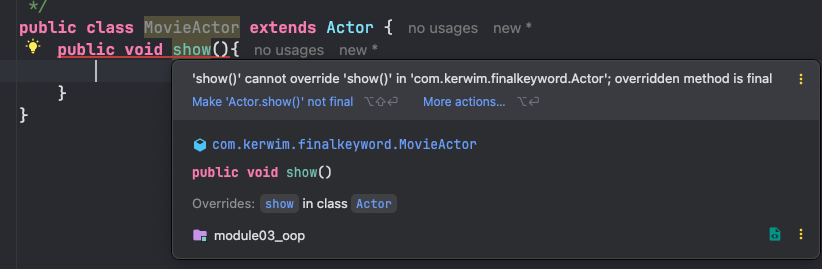
所以:
final 方法
↓
可以被子类继承
↓
可以直接调用
↓
但是不能重写例如:
Actor actor =
new Actor();
actor.show();子类对象同样可以调用:
ChildActor actor =
new ChildActor();
actor.show();只是不能改变:
show()原来的实现。
因此,如果设计一个类时明确认为:
这个方法的行为不应该被子类修改。
就可以考虑使用:
final修饰。
JDK 中也存在这种设计。
例如某些类允许继续继承,但其中部分关键方法被设计为:
final于是:
类
↓
仍然可以扩展
某些 final 方法
↓
行为不能被修改这和直接把整个类设置成:
final是不一样的。
16.3 final 类
使用:
final修饰的类不能被继承。
例如:
public final class Writer {
private String name;
public String getName() {
return name;
}
public void setName(
String name) {
this.name = name;
}
}此时不能再:
// 编译错误
// class ChildWriter
// extends Writer {
// }IDE 会提示类似错误:
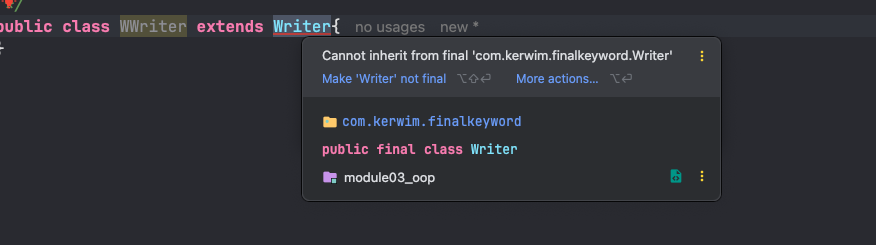
所以:
final class
↓
继承体系到此为止Java 中非常典型的例子就是:
java.lang.StringString 本身就是一个:
final类。
源码结构类似:
public final class String
implements Serializable,
Comparable<String>,
CharSequence {
}为什么 String 是 final?
String 最重要的特征之一就是:
不可变
Immutable如果允许其他类随意继承 String 并改变其行为,就可能破坏 String 的一些重要语义。
例如:
equals()
hashCode()
不可变性这些行为对于:
字符串常量池
HashMap / HashSet
多线程共享
安全性等场景都非常重要。
将 String 设计为:
final可以防止通过继承修改这些关键行为,从而帮助保证 String 的设计约束。
需要注意:
String 的不可变性并不是单纯因为它是 final 类。
final class 只能保证:
不能被继承真正的不可变还需要:
内部状态不能被外部随意修改
不提供修改自身状态的方法
内部可变数据受到保护等设计共同完成。
final 类不等于不可变类
例如刚才的:
public final class Writer {
private String name;
public String getName() {
return name;
}
public void setName(
String name) {
this.name = name;
}
}虽然:
Writer不能被继承,但对象本身仍然可以修改。
例如:
Writer writer =
new Writer();
writer.setName("kerwim");
System.out.println(
writer.getName()
);输出:
kerwim因为:
setName()仍然能够改变对象内部状态。
所以:
final 类
↓
只能保证不能被继承
不可变对象
↓
要求对象创建后状态不能改变两者不是同一个概念。
这一点后面的:
不可变对象还会单独说明。
是否应该大量使用 final 类?
final 类可以限制继承,使类的行为更加可控。
但也不应该为了所谓的:
安全而把所有类都设计成 final。
因为:
final class Xxx {
}意味着:
这个类彻底关闭了继承扩展能力以后不能通过:
继承
重写对这个类进行扩展。
所以是否使用:
final应该根据设计需求决定,而不是机械使用。
16.4 final 与 static 的区别
final 和 static 经常一起出现:
public static final String NAME =
"Java";但两者解决的是完全不同的问题。
static
↓
这个成员属于谁?
↓
属于类
final
↓
这个变量还能不能重新赋值?
↓
不能例如:
public static final double PI =
3.1415926;可以拆开理解:
static
↓
PI 属于类
↓
所有对象共享
final
↓
PI 完成赋值后不能再次赋值因此:
static final经常组合起来表示:
类级别常量16.5 小结
final 可以修饰变量、方法和类。
核心规则可以直接记住:
| 使用方式 | 含义 |
|---|---|
final 基本类型变量 | 值不能再次改变 |
final 引用变量 | 引用不能重新指向其他对象 |
final 参数 | 方法中不能重新给参数赋值 |
final 方法 | 不能被子类重写 |
final 类 | 不能被继承 |
static final | 常用于定义类常量 |
最容易混淆的是:
final 引用
≠
不可变对象
final 类
≠
不可变类例如:
final Pig pig =
new Pig();
pig.setName("kerwim");完全允许。
因为:
pig 的引用没有改变
只是 Pig 对象自己的状态发生了变化所以 final 最核心的理解可以概括为:
final 变量
↓
不允许再次赋值
final 方法
↓
不允许再次重写
final 类
↓
不允许继续继承一句话概括:
final表示对变化进行限制,但具体限制的是变量赋值、方法重写还是类继承,要看它修饰的是什么。
17. Java instanceof 关键字
instanceof 用于判断一个对象是否属于某个指定的类型,或者是否可以看作该类型的对象。
基本语法:
对象 instanceof 类型判断结果只有:
true
false例如:
Object obj = "Java";
System.out.println(
obj instanceof String
);输出:
trueinstanceof 经常和:
继承
接口
向下转型一起使用。
它最常见的用途就是:
在强制类型转换之前先判断对象的实际类型,避免错误的向下转型。
17.1 基本使用
先定义一个父类:
class Round {
}再定义一个子类:
class Ring extends Round {
}创建:
Ring ring =
new Ring();判断:
System.out.println(
ring instanceof Round
);输出:
true原因是:
Ring extends Round也就是说:
Ring is a Round所以一个 Ring 对象同时也是:
Ring 类型
Round 类型可以理解为:
Round
↑
Ring因此:
ring instanceof Ring结果是:
true而:
ring instanceof Round同样是:
true17.2 instanceof 与继承、接口
instanceof 不仅可以判断类的继承关系,也可以判断接口实现关系。
例如定义接口:
interface Shape {
}定义:
class Circle
extends Round
implements Shape {
}创建:
Circle circle =
new Circle();判断自身类型:
System.out.println(
circle instanceof Circle
);输出:
true判断父类:
System.out.println(
circle instanceof Round
);输出:
true判断实现的接口:
System.out.println(
circle instanceof Shape
);同样输出:
true所以:
Circle
│
├── extends Round
│
└── implements Shape那么一个 Circle 对象可以同时满足:
circle instanceof Circle
circle instanceof Round
circle instanceof Shape没有类型关系时
再定义:
class Triangle
implements Shape {
}Circle 和 Triangle 是两个互不继承的具体类:
Shape
/ \
Circle Triangle如果直接:
Circle circle =
new Circle();
// 编译错误
// System.out.println(
// circle instanceof Triangle
// );编译器能够判断:
Circle不可能同时是:
Triangle因此这种明显不可能成立的类型判断会直接编译失败。
但是如果引用类型比较宽泛,例如:
Shape shape =
new Circle();那么:
System.out.println(
shape instanceof Triangle
);是可以编译的。
因为从:
Shape这个引用类型本身来看,它未来完全可能指向:
Triangle对象。
这里只不过当前实际对象是:
Circle所以结果为:
false17.3 Object 与 instanceof
除了 Object 本身之外,Java 中所有类最终都会直接或者间接继承:
java.lang.Object例如:
Thread thread =
new Thread();
System.out.println(
thread instanceof Object
);输出:
true关系可以理解为:
Object
↑
Thread所以绝大多数普通 Java 对象:
xxx instanceof Object结果都会是:
true17.4 null 与 instanceof
如果对象引用为:
null那么无论判断什么引用类型:
null instanceof Xxx结果都是:
false例如:
System.out.println(
null instanceof Object
);输出:
false再例如:
String str = null;
System.out.println(
str instanceof String
);仍然输出:
false所以:
null
↓
instanceof 任意引用类型
↓
false这也是 instanceof 使用起来比较方便的一点。
例如:
if (obj instanceof String) {
}即使:
obj == null也不会因为这个判断本身抛出:
NullPointerException而只是得到:
false17.5 instanceof 与向下转型
instanceof 最经典的使用场景,就是配合:
向下转型例如:
Object obj =
"Java";当前:
引用类型
↓
Object
实际对象
↓
String如果需要调用 String 自己的方法,就需要向下转型:
String str =
(String) obj;但是向下转型存在风险。
例如:
Object obj =
Integer.valueOf(100);
// 运行时异常
// String str = (String) obj;会抛出:
ClassCastException因此传统写法通常是先判断:
if (obj instanceof String) {
String str =
(String) obj;
System.out.println(
str.length()
);
}执行过程:
obj
↓
instanceof String
↓
是不是 String?
↓
是
↓
(String) obj
↓
安全向下转型所以 instanceof 和向下转型经常成对出现:
instanceof
↓
负责判断
强制类型转换
↓
负责转换17.6 instanceof 模式匹配
传统写法需要:
if (obj instanceof String) {
String str =
(String) obj;
System.out.println(
str.length()
);
}可以发现:
先判断 String
然后又强转 String存在一定重复。
从 Java 16 开始,instanceof 模式匹配正式加入 Java,可以直接写成:
if (obj instanceof String str) {
System.out.println(
str.length()
);
}这里:
obj instanceof String str同时完成:
类型判断
+
类型转换
+
变量声明如果判断成功:
str就已经是:
String类型,可以直接使用。
例如:
public static void printLength(
Object obj) {
if (obj instanceof String str) {
System.out.println(
str.length()
);
}
}调用:
printLength("kerwim");输出:
6相比传统写法:
if (obj instanceof String) {
String str =
(String) obj;
}模式匹配更加简洁。
17.7 小结
instanceof 的核心作用就是:
判断一个对象是否属于某个类型,或者是否符合某个父类、接口类型。
基本语法:
对象 instanceof 类型可以简单记成:
对象是这个类创建的
↓
true
对象是这个类的子类对象
↓
true
对象实现了这个接口
↓
true
对象为 null
↓
false最常见的实际用途是:
父类型引用
↓
instanceof 判断实际类型
↓
安全向下转型
↓
使用子类特有功能现代 Java 中可以直接使用:
if (obj instanceof String str) {
}同时完成类型判断和类型转换。
一句话概括:
instanceof就是在运行时问一个对象:“你是不是这个类型?”
18. Java 中的不可变对象
不可变对象(Immutable Object)指的是:
对象一旦创建完成,其内部状态就不能再发生改变。
例如:
String name = "kerwim";
name.toUpperCase();调用方法并不会修改原来的字符串对象。
如果希望得到修改后的结果,需要接收返回值:
String name = "kerwim";
String upperName =
name.toUpperCase();可以简单理解为:
可变对象
↓
创建之后
↓
内部状态仍然可以改变
不可变对象
↓
创建完成
↓
内部状态保持不变不可变对象在 Java 中非常重要,尤其是在:
多线程
缓存
集合 Key
值对象等场景中经常出现。
18.1 什么是不可变类
如果一个类创建出来的对象,在初始化完成后,外部无法再改变它的状态,那么通常可以认为它是一个不可变类。
例如:
public final class User {
private final String name;
private final int age;
public User(
String name,
int age) {
this.name = name;
this.age = age;
}
public String getName() {
return name;
}
public int getAge() {
return age;
}
}创建:
User user =
new User(
"kerwim",
18
);对象创建完成后:
name = kerwim
age = 18并且没有任何方法能够重新修改这两个值。
所以这个对象的状态:
创建时确定
↓
之后保持不变这就是不可变对象。
不可变对象最大的特点之一,就是:
状态不会被其他代码偷偷修改。
这一点在多线程环境下尤其有价值。
如果多个线程共享的是一个可变对象:
线程 A
↓
修改对象
线程 B
↓
同时读取 / 修改对象就可能产生:
竞态条件
数据不一致
线程安全问题而不可变对象:
创建完成
↓
状态不再改变多个线程只读取同一个对象时,通常不需要因为对象状态变化而额外进行同步控制。
因此:
不可变对象天然更容易安全地在多个线程之间共享。
当然,这并不意味着使用不可变对象就能解决程序中的所有并发问题,只是对象自身不会因为并发修改状态而产生竞争。
18.2 常见的不可变类
Java 中最经典的不可变类就是:
String除此之外,很多包装类型也是不可变的,例如:
Integer
Long
Double
Boolean
Character以及很多现代 Java API 中的值类型,也采用了不可变设计。
String 的不可变性
例如:
String kerwim =
"kerwim,一名 Java 牛马";
kerwim.substring(0, 6);
System.out.println(kerwim);输出:
kerwim,一名 Java 牛马虽然调用了:
substring()但原来的:
kerwim并没有改变。
如果希望获得截取结果,需要:
String result =
kerwim.substring(0, 6);
System.out.println(result);输出:
kerwim所以:
String 方法
↓
通常不会修改原来的 String 对象
↓
而是返回结果对象需要注意,并不是所有 String 方法都一定创建一个全新的对象。
例如某些操作如果发现根本不需要修改内容,实现上完全可能直接返回:
this真正需要记住的是:
无论返回的是不是新对象,原来的 String 对象内容都不会发生改变。
为什么 String 要设计成不可变?
String 设计成不可变类型,会带来很多重要的好处。
1. 有利于字符串常量池共享
Java 中字符串字面量可以通过字符串常量池进行复用。
例如:
String s1 = "Java";
String s2 = "Java";这种共享能够安全成立的一个重要前提就是:
String 内容不能被随意修改假设字符串对象可以直接修改:
s1
\
"Java"
/
s2如果:
s1能够把共享对象改成:
"Python"那么:
s2看到的内容也会被一起改变。
显然会产生严重问题。
所以不可变性非常适合:
共享
缓存
复用2. hashCode 更稳定
String 经常作为:
HashMap Key
HashSet 元素使用。
例如:
Map<String, String> map =
new HashMap<>();
map.put(
"name",
"kerwim"
);哈希容器依赖对象的:
equals()
hashCode()来定位元素。
如果一个对象作为 Key 放入 HashMap 之后,它参与 equals() 和 hashCode() 的状态还能随意改变,就可能导致:
对象明明还在 Map 里
但是按照新的 hashCode 找不到它String 是不可变对象:
创建后内容不变
↓
equals / hashCode 语义稳定因此非常适合作为哈希容器的 Key。
String 的实现还可以对计算得到的哈希值进行缓存,从而减少重复计算。
3. 更容易保证线程安全
如果:
String name = "kerwim";被多个线程同时引用:
线程 A ─┐
├──→ "kerwim"
线程 B ─┘由于任何线程都无法修改这个字符串本身,所以可以放心共享。
不需要因为:
某个线程突然把字符串内容改了而增加同步控制。
4. 有利于安全性
字符串在 Java 中经常表示一些重要信息,例如:
文件路径
类名
URL
数据库连接信息
网络协议参数如果字符串对象在传递给其他代码以后还能被偷偷修改,就容易产生不可预期的问题。
不可变设计可以让一个字符串在创建后保持稳定。
18.3 如何设计一个不可变类
一个简单的不可变类通常需要遵循几个原则:
类不能被随意扩展后破坏不可变性
字段不能在初始化后重新赋值
不提供修改对象状态的方法
如果包含可变对象,需要保护内部状态例如先设计一个简单的:
Writer类:
public final class Writer {
private final String name;
private final int age;
public Writer(
String name,
int age) {
this.name = name;
this.age = age;
}
public String getName() {
return name;
}
public int getAge() {
return age;
}
}这里做了几件事情:
Writer 使用 final
↓
防止通过继承破坏设计
字段使用 private final
↓
只能在初始化过程中赋值
没有 Setter
↓
外部无法直接修改状态其中:
String本身就是不可变对象,
而:
int又是基本数据类型。
所以这个 Writer 比较容易保证不可变性。
18.4 final 并不能完全保证不可变
这里特别容易产生一个误区:
所有字段都是 final
↓
对象一定不可变这是不对的。
如果字段本身引用的是一个:
可变对象即使引用是 final,对象内部的内容仍然可能发生变化。
例如定义:
public class Book {
private String name;
private int price;
public String getName() {
return name;
}
public void setName(
String name) {
this.name = name;
}
public int getPrice() {
return price;
}
public void setPrice(
int price) {
this.price = price;
}
@Override
public String toString() {
return "Book{" +
"name='" + name + '\'' +
", price=" + price +
'}';
}
}Book 显然是一个可变对象,因为可以:
book.setPrice(59);修改内部状态。
现在把它加入 Writer:
public final class Writer {
private final String name;
private final int age;
private final Book book;
public Writer(
String name,
int age,
Book book) {
this.name = name;
this.age = age;
this.book = book;
}
public String getName() {
return name;
}
public int getAge() {
return age;
}
public Book getBook() {
return book;
}
}表面上:
book已经是:
private final但仍然存在问题。
测试:
public class WriterDemo {
public static void main(
String[] args) {
Book book =
new Book();
book.setName(
"C语言程序设计"
);
book.setPrice(79);
Writer writer =
new Writer(
"谭浩强",
58,
book
);
System.out.println(
"定价:" +
writer.getBook()
);
writer.getBook()
.setPrice(59);
System.out.println(
"促销价:" +
writer.getBook()
);
}
}输出:
定价:Book{name='C语言程序设计', price=79}
促销价:Book{name='C语言程序设计', price=59}Writer 的内部状态被间接修改了。
原因在于:
private final Book book;中的:
final只保证:
book 这个引用不能重新指向其他 Book并不能保证:
Book 对象本身不能修改可以理解为:
final Book book
│
│ 引用不能改变
↓
┌────────────────┐
│ Book │
│ │
│ name │
│ price ← 仍可改 │
└────────────────┘所以:
final 引用不等于不可变对象。
18.5 防御性复制
如果不可变对象内部需要保存一个可变对象,通常需要使用:
防御性复制
Defensive Copy也就是:
不要直接保存或暴露外部传进来的可变对象,而是保存它的副本。
首先可以给 Book 提供复制方式:
public class Book {
private String name;
private int price;
public Book() {
}
public Book(Book book) {
this.name = book.name;
this.price = book.price;
}
public String getName() {
return name;
}
public void setName(
String name) {
this.name = name;
}
public int getPrice() {
return price;
}
public void setPrice(
int price) {
this.price = price;
}
}然后修改 Writer:
public final class Writer {
private final String name;
private final int age;
private final Book book;
public Writer(
String name,
int age,
Book book) {
this.name = name;
this.age = age;
// 保存副本
this.book =
new Book(book);
}
public String getName() {
return name;
}
public int getAge() {
return age;
}
public Book getBook() {
// 返回副本
return new Book(book);
}
}这里做了两层保护。
第一层:
this.book =
new Book(book);防止外部在对象创建之后继续通过原来的:
book修改 Writer 内部状态。
例如:
Book book =
new Book();
Writer writer =
new Writer(
"kerwim",
18,
book
);
// 修改原来的 book
book.setPrice(100);由于 Writer 保存的是副本,因此不会受到影响。
第二层:
public Book getBook() {
return new Book(book);
}防止外部通过:
writer.getBook()拿到 Writer 内部真正保存的对象。
因此:
writer.getBook()
.setPrice(59);修改的只是:
返回出去的副本而不是 Writer 内部真正保存的对象。
过程可以理解为:
外部 Book
↓
复制
↓
Writer 内部 Book
↓
不直接暴露
↓
再次复制
↓
返回给外部所以对于可变字段:
不仅 Getter 要考虑防御性复制,构造方法接收外部对象时同样需要进行防御性复制。
仅仅修改:
getBook()而构造方法仍然直接保存:
this.book = book;其实还没有完全解决不可变性问题。
18.6 修改不可变对象怎么办
不可变对象并不是:
以后永远不能得到另外一个状态而是:
不能直接修改原对象,需要创建一个新的对象表示新的状态。
例如:
public final class Writer {
private final String name;
private final int age;
public Writer(
String name,
int age) {
this.name = name;
this.age = age;
}
public Writer withAge(
int age) {
return new Writer(
this.name,
age
);
}
public String getName() {
return name;
}
public int getAge() {
return age;
}
}调用:
Writer writer1 =
new Writer(
"kerwim",
18
);
Writer writer2 =
writer1.withAge(20);此时:
writer1
↓
kerwim / 18
writer2
↓
kerwim / 20原来的:
writer1没有任何变化。
这也是很多不可变类型常见的设计方式:
想改变状态
↓
不修改原对象
↓
返回一个新对象18.7 不可变对象的优缺点
不可变对象最大的优势就是:
状态稳定因此通常会带来:
更容易理解
更容易共享
更容易缓存
更适合多线程环境
更适合作为 HashMap Key
减少对象状态被意外修改的问题但是不可变对象也不是没有代价。
如果状态频繁变化:
状态 A
↓
创建新对象 B
↓
创建新对象 C
↓
创建新对象 D就可能产生更多临时对象。
例如:
String result = "";
for (int i = 0; i < 10000; i++) {
result += i;
}由于 String 不可变,这种频繁拼接通常会产生大量中间结果。
这种场景更适合:
StringBuilder builder =
new StringBuilder();
for (int i = 0; i < 10000; i++) {
builder.append(i);
}所以:
不可变对象
↓
稳定、安全、容易共享
可变对象
↓
适合频繁修改状态两者没有绝对的好坏,需要根据场景选择。
18.8 小结
设计一个不可变类时,可以重点检查:
1. 对象创建完成后,字段还能不能重新赋值?
2. 有没有 Setter 或其他方法直接修改内部状态?
3. 内部是否保存了可变对象?
4. Getter 有没有直接暴露内部可变对象?
5. 构造方法有没有直接保存外部传进来的可变对象?
6. 子类能不能通过继承破坏不可变性?一个典型的不可变类通常会采用:
final 类
↓
private final 字段
↓
构造时完成初始化
↓
不提供修改状态的方法
↓
可变对象进行防御性复制
↓
修改状态时返回新对象需要特别记住两个容易混淆的概念:
final 引用
≠
不可变对象
final 类
≠
对象一定不可变final 只是实现不可变设计时经常使用的一种手段。
不可变真正关注的是:
对象创建完成后,从外部是否还有办法改变这个对象可观察到的状态。
一句话概括:
不可变对象不是“不能产生新的状态”,而是“原来的对象永远保持创建完成时的状态”。
19. Java 方法重载与方法重写
方法重载(Overload)和方法重写(Override)名字非常相似,但实际上是两个完全不同的概念。
可以先简单区分:
方法重载 Overload
↓
同一个方法名
↓
提供不同的参数形式
方法重写 Override
↓
子类继承父类
↓
重新实现父类已有的方法方法重载主要解决:
同一个功能如何支持不同参数。
方法重写主要解决:
子类如何改变父类已有行为。
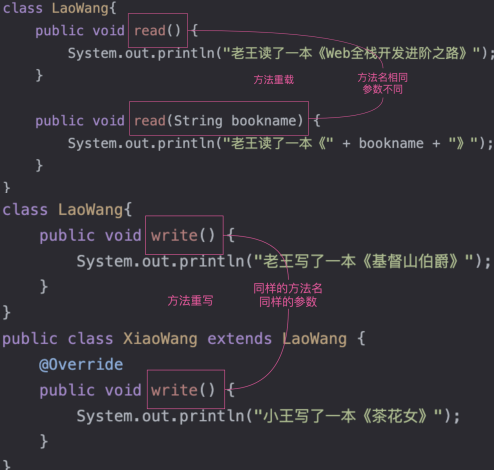
19.1 方法重载 Overload
方法重载指的是:
方法名相同,但是参数列表不同。
参数列表不同主要包括:
参数数量不同
参数类型不同
参数顺序不同例如:
public class Adder {
public static int add(
int a,
int b) {
return a + b;
}
public static int add(
int a,
int b,
int c) {
return a + b + c;
}
public static double add(
double a,
double b) {
return a + b;
}
}这里存在三个:
add()方法:
add(int, int)
add(int, int, int)
add(double, double)因为参数列表不同,所以属于方法重载。
19.1.1 参数数量不同
例如:
class Adder {
public static int add(
int a,
int b) {
return a + b;
}
public static int add(
int a,
int b,
int c) {
return a + b + c;
}
}调用:
System.out.println(
Adder.add(10, 19)
);
System.out.println(
Adder.add(10, 19, 20)
);编译器会根据参数数量选择对应的方法。
如果参数类型相同,只是参数数量不确定,也可以考虑使用可变参数:
public static int add(
int... args) {
int sum = 0;
for (int value : args) {
sum += value;
}
return sum;
}调用:
add(1, 2);
add(1, 2, 3);
add(1, 2, 3, 4);不过:
可变参数和方法重载是两种不同的机制。
可变参数只是可以接收数量不固定的同类型参数。
19.1.2 参数类型不同
改变参数类型同样可以形成重载。
例如:
class Adder {
public static int add(
int a,
int b) {
return a + b;
}
public static double add(
double a,
double b) {
return a + b;
}
}调用:
System.out.println(
Adder.add(10, 19)
);
System.out.println(
Adder.add(10.1, 19.2)
);编译器会根据传入参数的类型决定调用:
add(int, int)
或者
add(double, double)19.1.3 参数顺序不同
如果参数类型不同,交换参数位置同样可以形成重载。
例如:
public void print(
String name,
int age) {
}和:
public void print(
int age,
String name) {
}属于两个不同的方法:
print(String, int)
print(int, String)19.1.4 返回值类型不能单独决定重载
下面这种写法是不允许的:
public int add(
int a,
int b) {
return a + b;
}// 编译错误
public double add(
int a,
int b) {
return a + b;
}虽然返回值不同:
int
double但是:
方法名相同
参数列表也完全相同所以 Java 无法根据返回值区分它们。
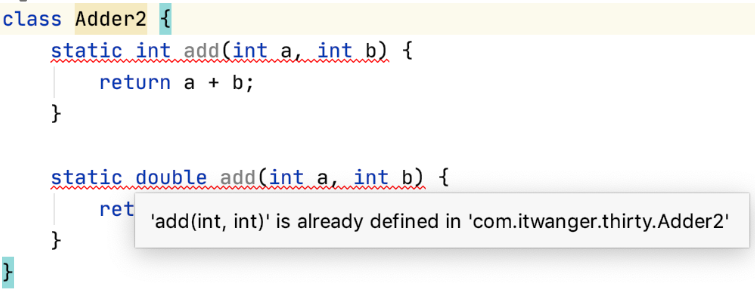
例如调用:
add(1, 2);这里根本没有使用返回值,编译器无法判断应该调用:
返回 int 的 add()
还是
返回 double 的 add()因此:
方法重载看方法名和参数列表,不看返回值类型。
19.1.5 main() 方法也可以重载
main() 本质上也是一个普通的静态方法,因此可以重载。
例如:
public class OverloadingMain {
public static void main(
String[] args) {
System.out.println(
"String[] args"
);
}
public static void main(
String arg) {
System.out.println(
"String arg"
);
}
public static void main() {
System.out.println(
"无参"
);
}
}这三个方法都叫:
main()但参数不同,因此属于方法重载。
不过使用普通 Java 启动器执行这个类时,程序入口仍然是标准形式:
public static void main(
String[] args)所以正常启动后输出:
String[] args其他重载版本需要在代码中主动调用。
19.1.6 重载与类型提升
如果调用方法时没有找到完全匹配的参数类型,Java 可能进行基本类型的宽化转换。
例如:
byte
↓
short
↓
int
↓
long
↓
float
↓
doublechar 也可以向:
int
long
float
double进行宽化转换。
例如:
public class OverloadingTypePromotion {
public void sum(
int a,
long b) {
System.out.println(
a + b
);
}
public void sum(
int a,
int b,
int c) {
System.out.println(
a + b + c
);
}
public static void main(
String[] args) {
OverloadingTypePromotion demo =
new OverloadingTypePromotion();
demo.sum(20, 20);
demo.sum(20, 20, 20);
}
}调用:
demo.sum(20, 20);没有:
sum(int, int)但存在:
sum(int, long)所以第二个:
int可以宽化转换成:
long最终调用:
sum(int, long)如果存在完全匹配的方法:
public void sum(
int a,
int b) {
System.out.println("int");
}同时还有:
public void sum(
long a,
long b) {
System.out.println("long");
}调用:
sum(20, 20);会优先选择:
sum(int, int)因为它是更精确的匹配。
19.1.7 重载可能产生歧义
如果存在:
public void sum(
long a,
int b) {
System.out.println(
"long int"
);
}和:
public void sum(
int a,
long b) {
System.out.println(
"int long"
);
}调用:
sum(20, 20);编译器就不知道应该:
把第一个 20 转成 long
还是
把第二个 20 转成 long两个方法的匹配程度相同,因此产生调用歧义。
所以实际开发中应该避免设计这种容易产生歧义的重载方法。
19.2 方法重写 Override
方法重写发生在继承体系中。
当子类继承父类后,希望修改父类已有方法的行为,就可以重新实现这个方法。
例如父类:
class Vehicle {
public void run() {
System.out.println(
"车辆在跑"
);
}
}子类:
public class Bike
extends Vehicle {
@Override
public void run() {
System.out.println(
"自行车在跑"
);
}
}调用:
Bike bike =
new Bike();
bike.run();输出:
自行车在跑可以理解为:
Vehicle
↓
定义 run()
Bike extends Vehicle
↓
重新实现 run()
↓
改变父类原来的行为@Override 虽然不是语法上必须的,但强烈建议使用:
@Override它可以让编译器帮我们检查:
当前方法是否真的符合方法重写规则。
19.3 方法重写的规则
方法重写并不是只要求:
方法名字一样还需要遵循一系列规则。
19.3.1 必须存在继承或接口实现关系
重写的基础是:
继承关系
或者
接口实现关系例如:
class Dog extends Animal {
}或者:
class Dog
implements Runnable {
}如果两个完全没有关系的类中恰好存在同名方法,那不属于方法重写。
19.3.2 方法名和参数列表必须相同
父类:
class Animal {
public void eat(
String food) {
}
}子类:
class Dog extends Animal {
@Override
public void eat(
String food) {
}
}这里:
方法名相同
参数类型相同
参数数量相同
参数顺序相同所以属于方法重写。
如果子类改成:
public void eat(
String food,
int amount) {
}就不再是对父类:
eat(String)的重写。
但需要注意,这仍然可以和继承来的:
eat(String)一起构成重载关系。
所以方法重载并不严格要求所有方法都必须写在同一个类的源码中,继承体系中也可能因为新增同名、不同参数方法而形成重载。
19.3.3 返回类型必须兼容
最简单的情况是父子类返回类型完全相同。
例如:
class Animal {
public String getName() {
return "Animal";
}
}class Dog extends Animal {
@Override
public String getName() {
return "Dog";
}
}Java 还支持:
协变返回类型
Covariant Return Type例如父类:
class Animal {
public Animal create() {
return new Animal();
}
}子类:
class Dog extends Animal {
@Override
public Dog create() {
return new Dog();
}
}因为:
Dog是:
Animal的子类,所以允许。
因此更准确地说:
重写方法的返回类型必须与父类相同,或者是父类返回类型的子类型。
如果父类返回:
void子类就不能擅自改成:
String否则编译失败。
19.3.4 访问权限不能变得更严格
重写方法时,子类的访问权限不能缩小。
可以简单理解:
默认
↓
protected
↓
public例如父类:
class Animal {
protected void eat() {
}
}子类可以:
class Dog extends Animal {
@Override
public void eat() {
}
}因为:
protected → public权限扩大了。
但是不能:
// 编译错误
private void eat() {
}常见规则:
父类默认
↓
子类可以 默认 / protected / public
父类 protected
↓
子类可以 protected / public
父类 public
↓
子类只能 public这里还要注意:
默认访问权限的方法只有在子类与父类处于同一个包时,才会形成正常的可继承、可重写关系。
19.3.5 private 方法不能被重写
父类:
class Animal {
private void move() {
}
}子类:
class Dog extends Animal {
public void move() {
}
}这里子类中的:
move()并不是重写。
因为父类的:
private void move()对子类不可见。
两个方法实际上彼此独立。
所以:
private 方法
↓
不能被子类重写19.3.6 final 方法不能被重写
父类:
class Animal {
public final void move() {
}
}子类不能:
class Dog extends Animal {
// 编译错误
// @Override
// public void move() {
// }
}
需要注意:
final方法仍然可以被子类继承和调用,只是不能被重写。
所以准确说法是:
final 方法
↓
可以继承
↓
不能重写19.3.7 static 方法不能发生真正的重写
静态方法属于类本身,不参与实例方法的动态绑定。
例如:
class Animal {
public static void move() {
System.out.println(
"Animal"
);
}
}子类:
class Dog extends Animal {
public static void move() {
System.out.println(
"Dog"
);
}
}这种情况不是:
Override而是:
Method Hiding
方法隐藏
所以:
实例方法
↓
可以重写
↓
支持运行时多态
static 方法
↓
只能隐藏
↓
不属于真正的方法重写19.3.8 checked 异常不能扩大范围
如果父类方法声明了受检异常:
class Animal {
protected void eat()
throws IOException {
}
}子类可以声明:
class Dog extends Animal {
@Override
public void eat()
throws FileNotFoundException {
}
}因为:
FileNotFoundException是:
IOException的子类。
也可以完全不声明:
@Override
public void eat() {
}但是不能扩大成:
@Override
public void eat()
throws Exception {
}因为:
Exception比:
IOException范围更大。
所以对于受检异常:
子类声明的异常
↓
可以相同
可以更具体
可以不声明
↓
不能扩大这条限制主要针对:
Checked Exception对于:
RuntimeException及其子类,不受这条规则限制。
19.3.9 可以使用 super 调用父类版本
子类重写方法之后,仍然可以通过:
super.方法名()调用父类原来的实现。
例如:
class Animal {
protected void eat() {
System.out.println(
"Animal eat"
);
}
}class Dog extends Animal {
@Override
public void eat() {
// 调用父类实现
super.eat();
System.out.println(
"Dog eat"
);
}
}输出:
Animal eat
Dog eatsuper.eat() 并不要求必须写在方法第一行。
它可以根据业务需要出现在方法体允许的位置。
需要和:
super(...)区分。
只有调用父类构造方法的:
super(...)才必须是构造方法中的第一条语句。
19.3.10 构造方法不能被重写
构造方法:
Animal()和类名绑定。
子类:
Dog自己的构造方法必须叫:
Dog()所以父类构造方法不会被子类继承,也不存在方法重写。
可以:
调用父类构造方法但不能:
重写父类构造方法例如:
class Dog extends Animal {
public Dog() {
super();
}
}这里是调用父类构造方法,而不是重写。
19.3.11 抽象方法需要由具体子类实现
例如:
abstract class Animal {
public abstract void move();
}如果子类仍然是抽象类:
abstract class Dog
extends Animal {
}可以暂时不实现:
move()但是如果子类是具体类:
class BullDog extends Animal {
@Override
public void move() {
}
}就必须把尚未实现的抽象方法实现完整。
同样,接口中的抽象方法也是如此:
interface Animal {
void move();
}普通实现类:
class Dog
implements Animal {
@Override
public void move() {
}
}所以准确地说:
第一个具体的非抽象子类,必须实现继承体系中尚未实现的抽象方法。
19.3.12 synchronized 不影响重写规则
synchronized 用于线程同步,并不是方法签名的一部分。
例如父类:
class Animal {
public void eat() {
}
}子类可以:
class Dog extends Animal {
@Override
public synchronized void eat() {
}
}同样,父类是:
synchronized子类重写时也可以不写。
所以:
synchronized
↓
影响并发控制
↓
不决定是否构成 Override19.3.13 strictfp 不影响重写规则
strictfp 同样不是判断方法是否重写的条件。
不过从 Java 17 开始,浮点运算已经统一采用严格语义,strictfp 基本失去了过去的实际作用,并被标记为不再需要重点使用。
学习方法重写时,只需要知道:
strictfp
↓
不影响 Override 判断即可。
19.4 重载和重写的区别
最后把两者放在一起比较:
| 对比项 | 方法重载 Overload | 方法重写 Override |
|---|---|---|
| 发生位置 | 同一个类或继承体系中 | 父类与子类 / 接口与实现类 |
| 方法名 | 必须相同 | 必须相同 |
| 参数列表 | 必须不同 | 必须相同 |
| 返回类型 | 可以不同,但不能只靠返回值区分 | 相同或协变返回类型 |
| 访问权限 | 没有这种继承约束 | 不能比父类更严格 |
| 异常 | 各方法相互独立 | checked 异常不能扩大 |
| 与继承关系 | 不要求 | 必须存在继承或实现关系 |
| 与多态关系 | 编译期选择方法 | 运行时多态的重要基础 |
static 方法 | 可以参与重载 | 只能隐藏,不能真正重写 |
final 方法 | 可以和其他参数版本形成重载 | 不能被重写 |
可以简单记成:
Overload
↓
一同一不同
↓
方法名相同
参数列表不同而方法重写:
Override
↓
方法名相同
参数列表相同
返回类型兼容
↓
访问权限不能缩小
checked 异常不能扩大最核心的区别是:
重载
↓
同一个功能
提供不同的调用方式
重写
↓
继承父类行为
重新实现自己的版本一句话概括:
重载解决“怎么传参数”,重写解决“子类怎么改变父类行为”。